3.3 大模型技术原理
3.3 大模型技术原理(Transformer 架构简介)
本节摘要:ChatGPT 这类大模型为什么突然能写会画?核心是 2017 年提出的 Transformer 架构与它的"注意力机制"。本节用通俗方式讲清:词怎么变成数字、注意力机制在做什么、为什么"大"就强,以及大模型是怎么训练出来的。
读前必看
阅读完本节,你应当能够:
- 理解文本如何被转换成模型能处理的数字
- 用类比解释注意力机制
- 说清"参数量大"意味着什么
- 理解预训练与微调的区别
- 建立对"大模型为什么强"的直觉
一、问题与直觉
语言模型面对的难题:机器不懂语言,只懂数字。"我爱你"这三个字怎么让机器理解?答案是先把词变成数字(向量),再让模型在数字空间里找规律。而"注意力机制"解决的是另一个问题:一句话里,哪些词对理解当前词更重要——就像你读"虽然下雨,但我很开心",注意力会告诉你"虽然"和"但是"之间的转折关系。
先交代历史坐标。Transformer 架构由 Google 团队在 2017 年的一篇论文中提出,论文名直译过来就是"注意力就是你所需的一切"。此前处理文本的主流是循环网络,逐词阅读、步步传递,句子一长就"前读后忘",而且必须按顺序算,快不起来。Transformer 完全抛弃顺序处理,让每个词直接"看见"句中所有词,凭借这个设计一举拿下效率和效果,此后所有大模型都是它的后代。
二、核心原理
2.1 从词到数字
2.2 注意力机制:词的"关系网"
注意力机制让模型在处理每个词时,知道该重点关注哪些词。读"苹果"时,如果句子里有"公司",模型倾向于理解成科技公司;有"水果",则理解成水果。这种动态关联是 Transformer 的核心突破——它让模型能处理超长文本中的复杂关系。
2.3 为什么"大"就强
| 维度 | 小模型 | 大模型 |
|---|---|---|
| 参数量 | 千万级 | 千亿级 |
| 训练数据 | 少量 | 海量 |
| 能力 | 单一任务 | 通才 |
| 涌现能力 | 无 | 推理、编程、创作 |
大模型的"大"不只是体积,更是数据与算力的堆积——参数量大到一定程度,会"涌现"出训练时没明说教的能力(如推理、代码、翻译),这就是"规模效应"。
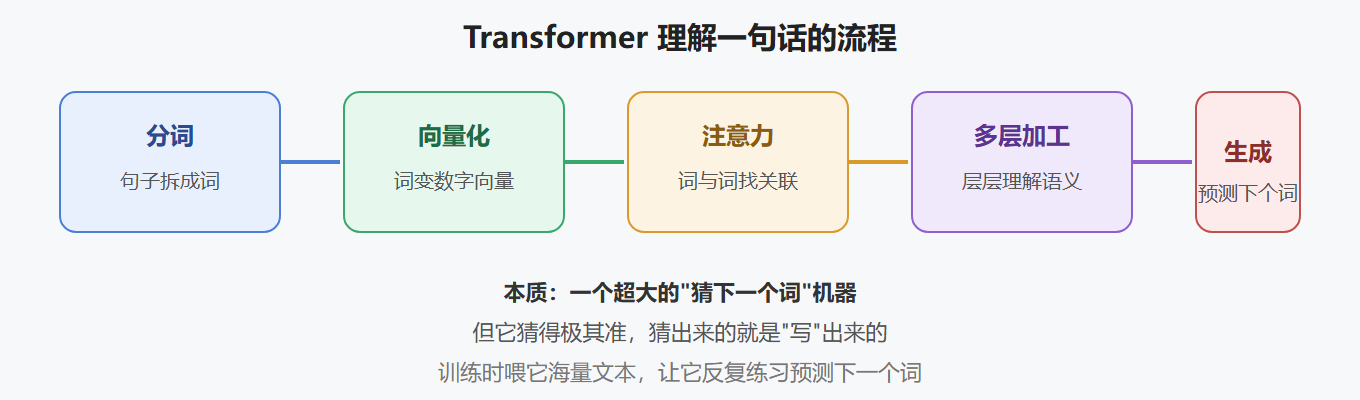
💡 关键直觉:大模型本质上是一个超强的"猜下一个词"机器——它预测下一个词的能力强到"写出来"就是"创作"。理解这一点,就理解了它"能写会画"的来源。
三、工程实践要点
3.1 预训练与微调
- 预训练:在海量通用文本上训练,得到"什么都会一点"的通才模型
- 微调:用特定领域数据再训练,让通才变成某领域的专才
这就是"大模型 + 定制"的基本原理——第 4 章的定制化应用就是微调或提示词工程的实践。
3.2 大模型的能力边界
| 能力 | 表现 | 局限 |
|---|---|---|
| 语言 | 写作、翻译、总结 | 可能编造事实 |
| 推理 | 逻辑、数学 | 复杂推理会错 |
| 知识 | 广博 | 训练后知识过期 |
| 创作 | 文案、代码 | 风格不稳定 |
3.3 普通人的理解要点
- 大模型 = 超强"猜词机" + 注意力机制 + 海量参数
- 预训练出通才,微调出专才
- 它"会写"但可能"编造",重要信息要核实
- 训练后知识会过期,新信息靠检索补充(RAG)
⚠️ 常见误区:以为大模型"什么都知道"。它的知识截止于训练时点,且会自信地编造——"一本正经地胡说八道"是大模型的固有风险,使用时要主动核实关键信息。
四、细节补完:从分词到对齐
4.1 分词与向量:语言的数字化
第一步是分词(Tokenization):把句子切成模型处理的最小单位,可能是一个字、一个词、甚至半个词。每个词元对应一串数字,即向量(Embedding)。向量的妙处在于"意思近则距离近":在向量空间里,"猫"和"狗"靠得很近,"猫"和"飞机"相距很远。模型对语言的一切运算,都发生在这个几何空间里——语义被翻译成了位置关系。
4.2 注意力机制再进一步
可以把注意力想象成开会:每个词都是与会者,发言前先环顾全场,判断谁的话与自己最相关,然后带着这份"加权理解"发言。"苹果"听到"发布会"三个字,立刻切换到公司语境;听到"削皮",切回水果语境。每个词都要对所有词算一遍相关性,这个计算可以高度并行——这正是 Transformer 比逐词处理的循环网络快得多的原因,也是它能吃下超长文本的原因。
4.3 训练的全流程:三步走
- 预训练:拿互联网量级的文本,做"给定前文猜下一个词"的练习,练出语言与世界的统计规律,得到"通才底座"。这一步最贵,动辄几千块 GPU 跑数月。
- 微调:用高质量的"指令—回答"样本教它按指令行事——从"会接话"变成"会办事"。
- 对齐训练:让人类对多个回答排序打分,模型学习"人类偏好什么",变得更有用、更安全、更符合预期。
理解这三步,很多现象就说得通了:模型知识截止于预训练数据的时间点;微调质量差的产品会答非所问;对齐做得保守的产品动辄拒绝正常请求。
4.4 参数量到底指什么
参数就是网络里那些可调的"权重旋钮"。GPT-3 有一千七百五十亿个参数,后来的模型动辄千亿级。旋钮越多,能记忆和表达的规律越细腻。规模定律是这轮竞赛的理论基础:参数、数据、算力按比例一起放大,模型能力可预期地上升;到某个规模后还会"涌现"出小模型完全没有的能力——复杂推理、跨任务泛化。这也解释了为什么大公司砸重金卷规模。
不过"大就是好"正在被修正。模型太大推理成本就高:一次训练烧掉千万美元级,日常服务亿万用户还要持续付电费和显卡钱。因此行业出现了两条并行路线——旗舰模型继续冲能力上限,小模型走"专精加便宜"路线,在手机等设备上本地运行。你手机上的语音助手、相册搜索,未来会越来越多地跑这种端侧小模型。
五、大模型不知道的事:RAG 与工具
预训练给了模型"脑中的知识",但脑中知识有三个硬伤:会过期、会缺细节、不能引用出处。补法是检索增强生成(RAG):回答前先去外部知识库(公司文档、最新网页)检索相关片段,把片段连同问题一起交给模型组织答案。相当于"开卷考试"——脑力是模型的,资料是现场的。企业内部知识问答几乎都走这条路,因为既省钱(不用重新训练)又可靠(答案有出处)。再进一步的形态是"智能体":模型自己决定何时检索、何时调用工具、何时提问——这是第 4 章定制化应用的技术底座。
三个高频问题:
问题一:为什么大模型会算错数学题? 它不是计算器,是在"猜最像答案的词"。简单算术常对是因为训练数据里见过太多;多步推理超出统计规律的舒适区就会滑倒。新一代模型通过"分步思考"和调用代码工具明显改善了这点。
问题二:同一问题每次回答不一样,正常吗? 正常。生成过程带随机采样,默认有"温度"参数控制随机度——创造性任务温度高些好,事实性任务温度低些稳。感觉回答不稳定时,重生成或降低随机性即可。
问题三:开源模型和闭源模型差在哪? 闭源(商用 API 为主)通常能力领先、开箱即用;开源(权重公开)可本地部署、数据不出门、可自由微调,能力略落后但追赶很快。企业敏感数据场景常选开源私有化,个人日常用云服务更省心。
问题四:大模型的"温度"是什么意思? 一个控制生成随机性的设置。温度低,模型总挑概率最高的词,回答稳定但刻板;温度高,偶尔选"冷门"词,回答多样但更敢编。你不必手动调它,但知道这个概念,能解释"为什么每次答案不一样",也能在工具提供该选项时按任务选对档位。
六、一次生成的旅程:从你的提问到它的回答
把全部原理串成一次完整的对话。你输入"帮我写一封请假邮件":
- 分词:句子被切成词元序列。
- 向量化:每个词元变成向量,带着语义坐标进入网络。
- 注意力运算:数十层 Transformer 层里,"请假"与"邮件"建立强关联,结合此前对话里的上下文(你之前提过明天去医院的铺垫),形成对意图的理解。
- 逐词生成:模型算出"下一个词"的概率分布,采样选一个,把新词接到序列末尾,再算下一个——你看到的"字往外蹦",就是这个循环的实时呈现。
- 终止:生成到特殊结束符或达到长度上限,回答完成。
全程没有一个"想法"产生,只有 billions 次矩阵乘法。但正是这种朴素的机制在海量参数加持下,涌现出了写诗、编程、推理的表观能力——理解这一点,你对 AI 的敬畏和警惕会同时增加:敬畏它的规模效应,警惕它没有"理解"兜底。
⚠️ 常见坑:把"概率生成"误当"知识检索"。它说"某某论文指出……"时,可能并不存在那篇论文——生成的是"像引用的文本"。凡涉及引用、数据、法条、新闻,一律核实。
要点速记
- 要点一:文本先分词再向量化,机器在数字空间理解语言
- 要点二:注意力机制让模型知道"哪些词相关",是 Transformer 的核心
- 要点三:大模型的"大"= 海量参数 + 海量数据 + 强大算力
- 要点四:参数量大到一定程度会"涌现"新能力
- 要点五:预训练出通才、微调出专才
- 要点六:大模型会自信地编造,关键信息要核实
- 要点七:训练三步——预训练出通才、微调学听话、对齐学说人话;知识截止于预训练时点
- 要点八:RAG 是"开卷考试",让模型用现场资料回答,企业知识问答的主流方案
原理理解了,下一节看怎么判断模型好不好——评估与优化。顺便说一句,本节的"猜下一个词"机制也解释了提示词为什么有效:你给的背景越充分,前文越清晰,模型猜出的下一个词就越贴你的意图——第 2 章的技巧与本章的原理,在这里接上了头。