2.1 调用栈进出的全程直播
2.1 调用栈进出的全程直播
本节摘要:调用栈是一块后进先出的内存区域,每个函数调用压入一个栈帧,帧内装着参数、局部变量与返回地址;返回即弹出。本节带你用 Error().stack 与 console.trace 亲眼看见栈、推演三层调用的帧序列、解释递归爆栈的配额原理,并讨论为什么尾递归优化在现实中基本缺席。
现场目击:把栈拍下来
不空谈,先拍现场。浏览器或 Node 里跑:
function inner() { console.log(new Error().stack); } function middle() { inner(); } function outer() { middle(); } outer();
实测输出(Node 22,浏览器类似,行号略异):
Error at inner (REPL2:2:15) at middle (REPL3:1:22) at outer (REPL4:1:15)
这三行就是调用栈的快照:inner 在栈顶(正在执行),middle 与 outer 在下面排队等待。console.trace() 是更正规的拍法,输出 Trace: at inner / at middle / at outer。第 7 章讲错误处理时你会再次看到这个结构——异常对象的 stack 属性就是异常抛出那一刻的栈快照,排错时读栈就是读「案发时刻谁在场」。
一、栈帧的四件行李
每个栈帧至少携带四样东西:
参数与 this 的绑定。调用发生时,实参被拷进帧内(注意:原始值拷贝值,对象拷贝引用的副本——这就是为什么函数内改对象属性会影响外部,改基本类型参数不影响外部)。
局部变量表。也就是第 1 章说的登记表,函数自己的词法环境。
返回地址。函数执行完该回到调用者的哪一行。
外层词法环境的引用。变量查不到时沿它向上找——这条引用串起来就是作用域链,2.3 节的主角。
用三层调用推演一遍。代码:
function c() { const z = 30; return z; } function b() { const y = 20; return c() + y; } function a() { const x = 10; return b() + x; } console.log(a()); // 60
执行到 c 内部 return 那行时,调用栈是这样的:
图 2.1-1 调用栈动画分镜:压栈与弹栈
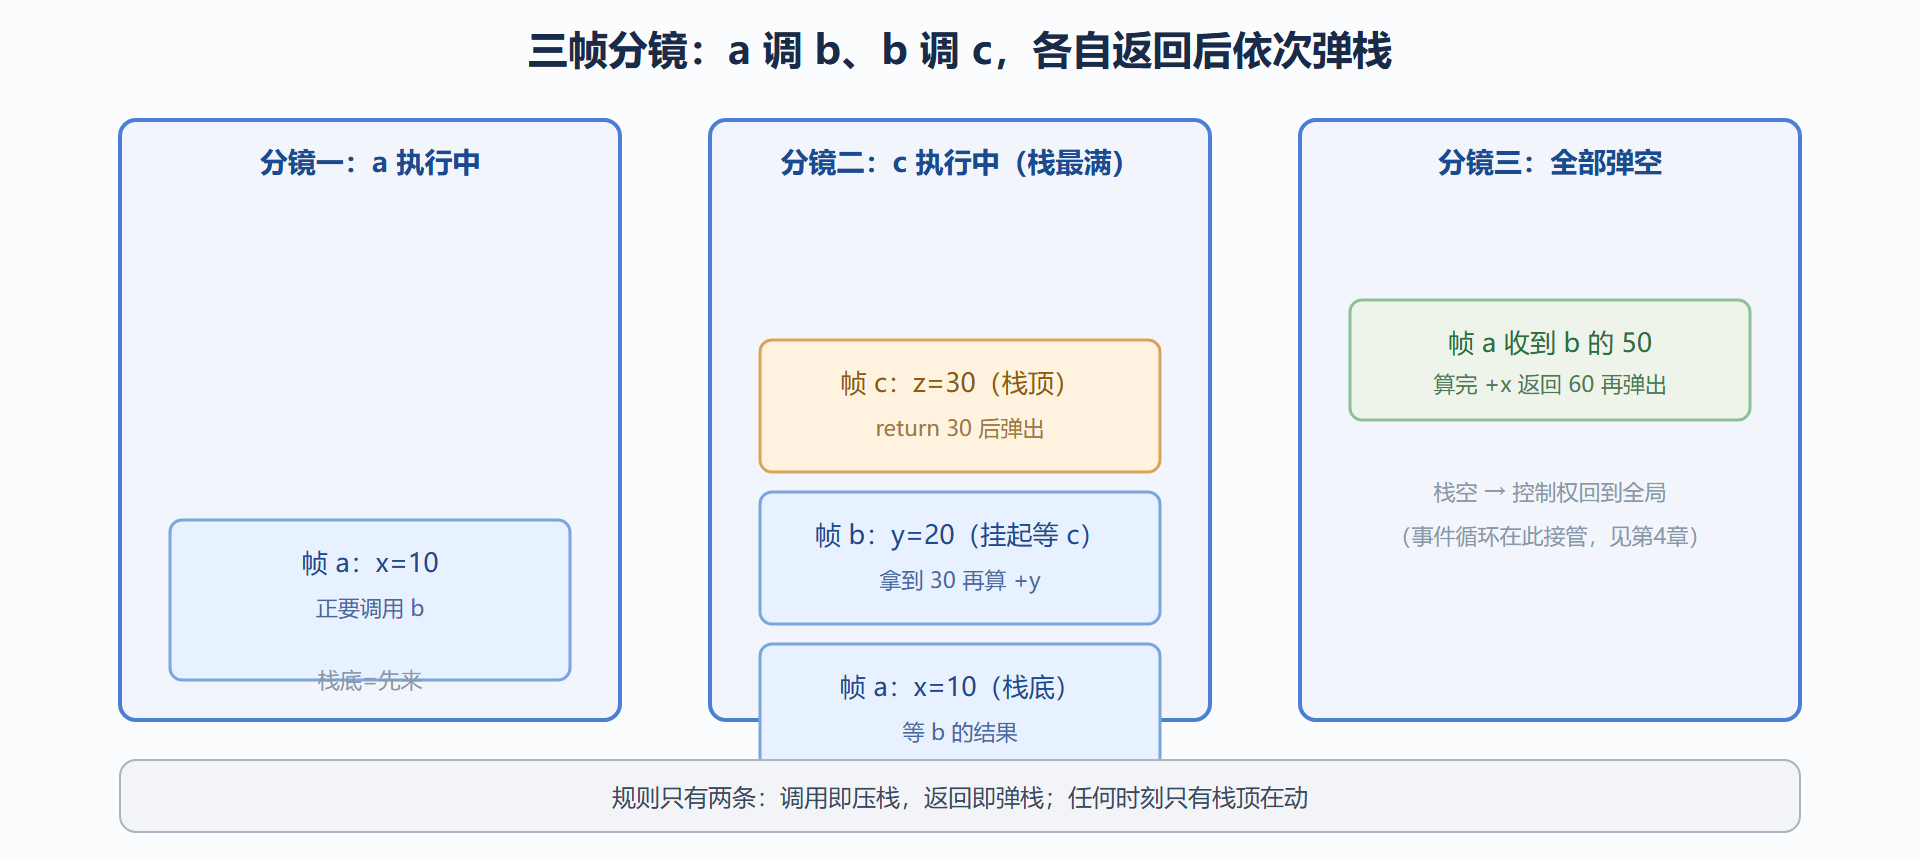
注意分镜二里 b 的帧还挂在栈上——它的局部变量 y 活着,代码却暂停在「等 c 的结果」这一步。这个「挂起」就是理解同步调用链的钥匙:调用者必须等被调用者返回,栈不空,别的代码就进不来。这也解释了为什么一个死循环或超长同步任务会把页面卡死:栈被占着,渲染、输入回调全都排在后面进不了场(第 5 章详述)。
二、爆栈:配额用尽的现场
栈不是无限深。每个引擎给调用栈设了帧数或内存配额,超出即抛 RangeError:
function loop(n) { return loop(n + 1); } loop(0); // 实测:RangeError: Maximum call stack size exceeded
实测输出里还带着长长一列 at loop——那就是爆掉瞬间的栈快照,几千个同名帧。Chrome 的配额大约在一万帧量级(不同版本、不同帧大小有浮动),Node 类似。
有用的推论有三条。第一,帧的大小影响可递归深度:局部变量越多、参数越多的函数,单帧越大,能递归的层数越少。第二,递归改写场景:树遍历、阶乘、斐波那契这类深度可控(对数级或常数级)的问题,递归安全;线性深度(如链表十万节点)就该改成显式栈或循环。第三,爆栈是同步世界的专属错误——异步回调每次都从空栈起步,所以用 setTimeout 把递归拆成调度不会爆栈,代价是失去返回值传递链。
标准里有个「尾调用优化」(PTC)本可消除一类递归的栈增长:函数最后一步直接 return 另一个调用时,复用当前帧。但现实是只有 Safari 的 JavaScriptCore 实现了它,V8 明确搁置。所以工程上请当作不存在,深递归一律手写迭代:
// 防御性写法:迭代版阶乘,栈深恒为 1 function factorial(n) { let acc = 1; for (let i = 2; i <= n; i++) acc *= i; return acc; } console.log(factorial(20000)); // Infinity(超 Number 上限,但不爆栈)
顺带看到第二个现象:20000 的阶乘超过双精度上限直接得 Infinity。深递归与精度是两个独立的坑,别混为一谈;真要大整数用 BigInt(20000n 量级运算,速度慢一个数量级,仅必要时使用)。
三、栈与参数传递:值拷贝的真相
栈帧里的参数是拷贝。原始类型拷的就是值本身;对象类型拷的是「引用的值」——指向堆上同一个对象的地址。看实证:
function mutate(obj, num) { obj.tag = 'changed'; // 顺着引用改堆上的对象 num = 99; // 只改了帧内的拷贝 } const o = { tag: 'origin' }; let n = 1; mutate(o, n); console.log(o.tag, n); // changed 1
对象被改了,数字没变。「JavaScript 传值还是传引用」的标准答案是:传值的语义,值里装着引用。这个模型也解释了重赋值与变异的区别:obj = {} 在函数内只是让本地引用指向新对象,外部无感;obj.tag = x 是穿过引用改堆,外部可见。数组的 sort、push 等变异方法都属后者。
把本节的三条主线收拢:栈帧是函数调用的完整档案(参数、变量、返回地址、外层环境引用);栈深有配额,深递归要主动迭代化;参数按值拷贝,对象可见的「按引用效果」来自拷贝的引用指向同一堆对象。下一节我们聚焦栈帧创建那一瞬间的另一个决定——this 指向谁。
- 要点:Error().stack 与 console.trace 是把栈拍下来的直接手段,读栈即读案发时刻;
- 要点:调用者挂起等待被调用者,栈不空则事件进不来,这是同步阻塞卡死页面的根源;
- 要点:爆栈是 RangeError,配额约万帧量级,受帧大小影响,尾调用优化在主流引擎缺席;
- 要点:参数拷贝的是值,对象场景下值是引用——变异可见、重赋值不可见。
综合演练:给递归加防护的三个版本
深度不可控的递归是线上事故的常客。同一棵树的遍历,三种防护版本从脆弱到稳健。
版本一:无防护(反面教材)。 输入意外成环(父节点引用了子节点),直接爆栈:
function walk(node) { doWork(node); node.children.forEach(walk); } const a = { children: [] }, b = { children: [a] }; a.children.push(b); // 意外成环 try { walk(a); } catch (e) { console.log(e.name); } // RangeError
版本二:访问标记防环。 图遍历的标配——走过的节点做记号:
function walkSafe(node, seen = new Set()) { if (seen.has(node)) return; // 环在这里断开 seen.add(node); doWork(node); node.children.forEach(c => walkSafe(c, seen)); } walkSafe(a); // 正常返回,不爆栈
防了环,防不了「合法但极深」:十万层的直线链表状结构照样能打穿配额。
版本三:显式栈迭代,栈深恒为一。 把「引擎的调用栈」换成「自己的数组栈」:
function walkIter(root) { const stack = [root]; while (stack.length) { const node = stack.pop(); doWork(node); for (let i = node.children.length - 1; i >= 0; i--) { stack.push(node.children[i]); } } }
数组栈活在堆上,容量只受内存限制,配合版本二的防环标记就是生产级写法。三个版本合起来读出一个方法论:递归的优雅建立在「深度可信」的前提上,前提存疑时,把栈的所有权从引擎手里拿回来。
常见问答
爆栈的报错里几千行 at loop,有办法看得清爽点吗?
那是栈快照如实记录了几千个同名帧。排查时只看第一行(抛出点)与最底部几行(最初入口),中间的重复帧直接跳过;把循环体抽成具名函数,报错也会更易读。别试图调大栈配额来「解决」——那是把爆栈时间推迟,不是消除。
异步回调为什么永远不会爆栈?
每次回调都从空栈起步(事件循环派发时,前一个任务的栈早就清了),回调之间不叠帧。代价是失去了同步的调用链——返回值传不回来、错误栈断在回调边界。深度递归改 setTimeout 分片能「不爆」,但整个算法形态都变了,能用显式栈就别用这条路。
栈帧大小真的会受局部变量影响吗?
会,但幅度通常不重要——除非单个函数里有巨型局部数组这类极端情况。日常可感知的差别来自「每帧携带多少闭包环境引用」,这也是深递归时「函数越简单越能递归更深」的微观解释。把它当背景知识即可,别为它做设计取舍。
通用模板:递归改显式栈
把 2.1 的爆栈防护提炼成一个可套用的翻译模板,以「树形结构求和」为例做完整对照:
// 递归版:语义清晰,深度受限 function sumTree(node) { if (!node) return 0; return node.value + sumTree(node.left) + sumTree(node.right); } // 显式栈版:栈深恒为一,深度不受限 function sumTreeIter(root) { if (!root) return 0; let total = 0; const stack = [root]; while (stack.length) { const node = stack.pop(); total += node.value; if (node.left) stack.push(node.left); if (node.right) stack.push(node.right); } return total; } // 构造一棵左斜一万层的深树实测 let deep = { value: 1, left: null, right: null }; for (let i = 0; i < 10000; i++) deep = { value: 1, left: deep, right: null }; console.log(sumTreeIter(deep)); // 10001 try { sumTree(deep); } catch (e) { console.log('递归版:', e.constructor.name); } // 实测:递归版可能抛 RangeError(深度接近默认配额上限的机器上必炸),迭代版稳定输出
模板的三步翻译法:把「函数调自己」改成「把子任务压进数组栈」;把「返回值累加」改成「循环外的一个累加变量」;把「递归终止条件」改成「循环的 while 判空」。任何「先根遍历」形态的递归(树求和、节点查找、目录遍历)都套得进这个模板;需要「后序」语义(先处理子再处理父)时,数组栈改两次入栈(节点先带标记压入,弹出遇标记再处理)即可。这套翻译在面试与生产里出现频率都高,值得练到肌肉记忆。
栈帧视角下的参数三兄弟:默认值、剩余参数、arguments
参数在栈帧创建时绑定,三个现代特性都可以从「绑定那一刻发生了什么」来理解。
默认值是创建时刻的表达式。 参数默认值在「调用发生、实参为 undefined」时求值,且每次调用独立求值:
function greet(name = makeName()) { return name; } let calls = 0; function makeName() { calls++; return '访客' + calls; } console.log(greet(), greet('张三'), greet()); // 访客1 张三 访客2 —— 默认值每次缺失都重新求值
这也解释了本节前文「参数默认值形成独立作用域」的死区案例:默认值表达式跑在一个介于函数体与外层之间的作用域里,能看见前面的参数,看不见函数体内的声明。
剩余参数是真数组。 function f(...args) 把多余实参收成数组——它就是数组,有全部方法、参与形状优化。对比之下 arguments 是「类数组对象」,还带着历史包袱:箭头函数里没有它、把整个对象传出去会阻碍引擎优化。
arguments 映射的历史行为。 非严格模式下,arguments 的下标与命名参数双向同步(改一个另一个跟着变)——这是 var 时代留下的活化石,严格模式与模块里已切断。新代码唯一的正确姿势:要收集参数用剩余参数,要读老代码时知道 arguments 与形参可能联动即可。三兄弟合起来一句话:参数的一切行为都定档在栈帧创建那一刻,理解了绑定时机,默认值、作用域、arguments 的怪行为全部有解。
栈深在线上能观测吗?
能,两个实用信号:递归函数入口埋点记录当前深度(用一个模块级计数器加试试包裹),超过阈值先告警再爆栈,事故从「页面崩了」变成「收到一条预警」;错误上报里统计 RangeError 的出现频率与栈深分布,能反推真实数据里最深递归的量级。这两个观测成本极低,却是「爆栈事故」从事后救火转向事前防范的最短路径。
本节带着你把函数调用的完整一生走了一遍:压栈、挂起等待、返回弹栈,以及栈配额耗尽与参数拷贝这两类高频事故的机理。顺手补齐了现代参数三件套(默认值、剩余参数、arguments)的栈帧视角,以及把递归翻译成显式栈的通用模板。带着这套模型进入下一节——栈帧创建那一瞬间还有另一个当场定案的决定等着我们:this 指向谁。它同样不神秘,只是四条按优先级排列的判定规则。