5.1 DOM树的表示与操作代价
5.1 DOM树的表示与操作代价
本节摘要:DOM 是浏览器用 C++ 对象维护的一棵活树,JavaScript 拿到的是它的接口包装。每次结构或几何改动都可能触发「样式重算 → 布局 → 绘制」的连锁,其中布局(重排)最贵。本节从树的形态讲起,给出查询、修改、批量更新的代价账本,比较 innerHTML 与 createElement 两条路线,并给出把重排压到一次的实战手法。
树的真实身份
打开控制台亲手摸一下这棵树:
const div = document.createElement('div'); div.textContent = '你好'; console.log(div.nodeType); // 1(元素节点) console.log(div.childNodes.length); // 1(文本节点也是节点) console.log(div.firstChild.nodeType); // 3(文本节点类型) console.log(document.nodeType); // 9(文档节点)
元素、文本、注释、文档,都是节点(Node),各有类型编号。每个元素节点身上挂着 parentNode、childNodes、firstChild 等指针——引擎内部是一张互相引用的对象网,你操作的每个 DOM 引用在 C++ 层都是真实指针的包装。这也意味着:DOM 对象是「重对象」,创建一万个 div 节点的内存与时间成本远超一万个普通 JS 对象,第 6 章内存清单里「detached 节点」泄漏的根源也在这里。
查询接口三代同堂:getElementById 与 getElementsByTagName(古典,按 tag 遍历优化);getElementsByClassName(返回动态集合——文档变了集合跟着变);querySelector 与 querySelectorAll(现代,吃完整 CSS 选择器,返回静态快照)。动态与静态的差异实测:
const list = document.querySelector('ul'); const live = list.getElementsByTagName('li'); const snap = list.querySelectorAll('li'); const li = document.createElement('li'); list.appendChild(li); console.log(live.length, snap.length); // 新增后 实测 4 3(live 变了,snap 不变)
querySelector 的成本与选择器复杂度成正比,右端最具体的条件放最右(引擎从右往左匹配)。高频查询结果存变量,别在循环里反复查——这是 DOM 性能最古老也最常被违反的一条。
一、改动的三级连锁
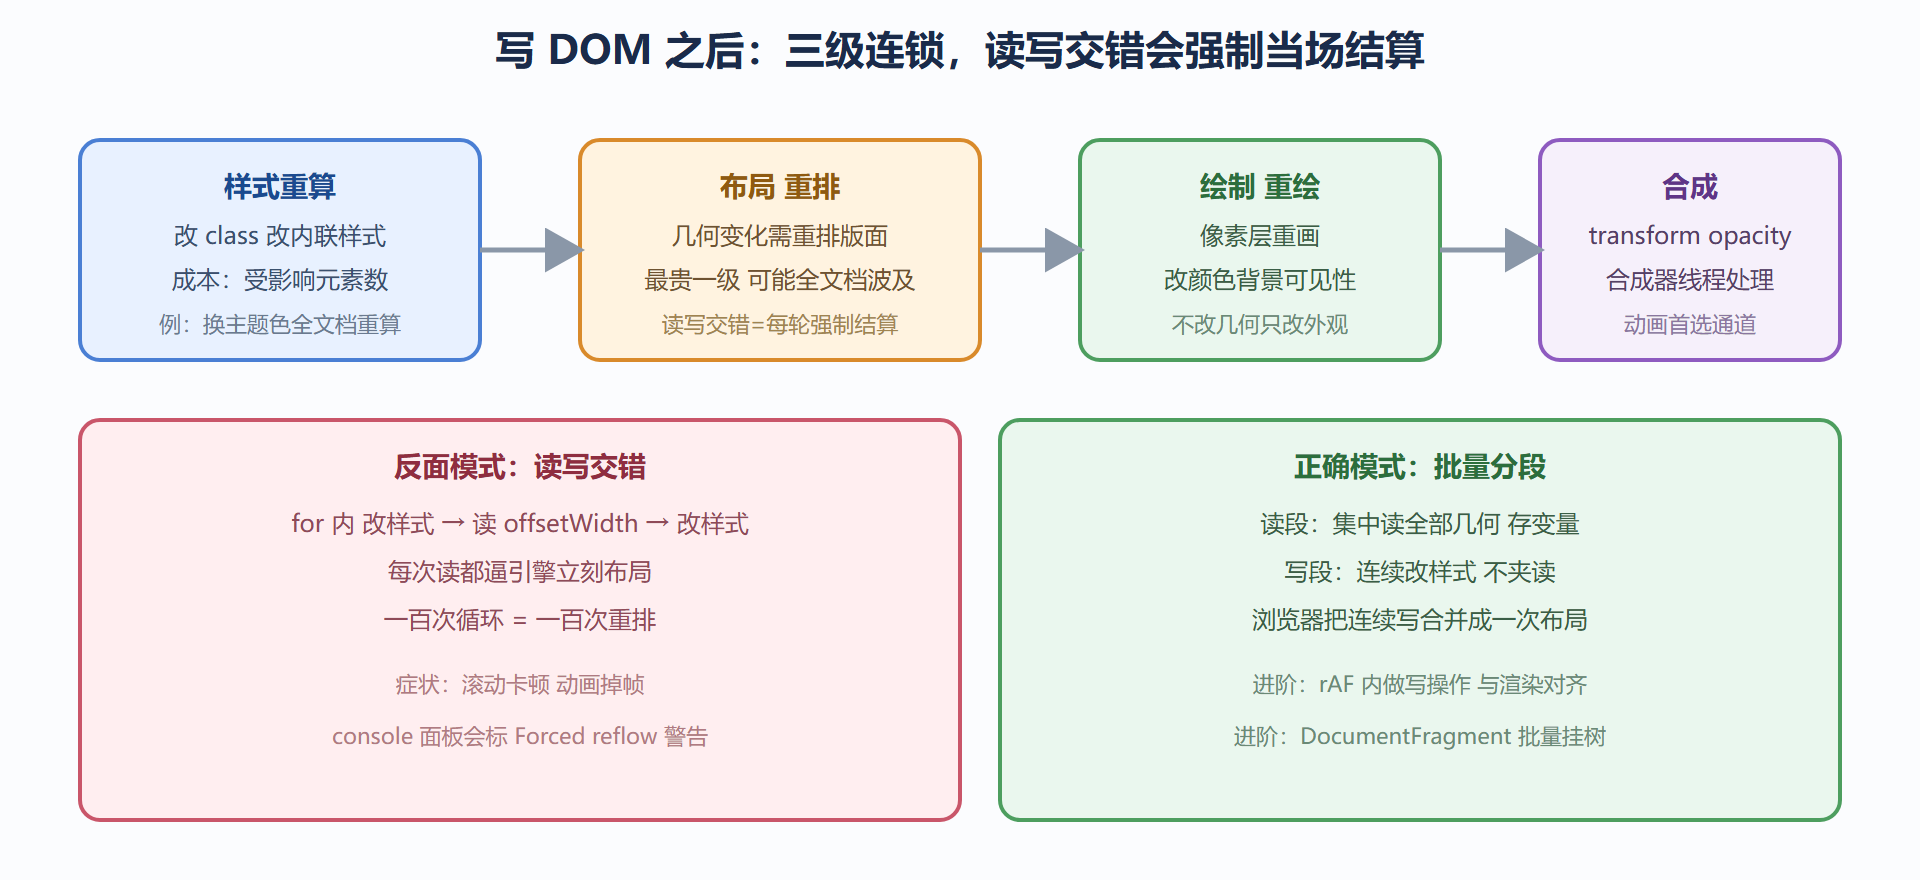
对树的每次写操作,浏览器按需走三级流水线:样式重算(哪些元素的样式变了)→ 布局/重排(几何位置重算)→ 绘制/重绘(像素重画)→ 可能的合成层提交。各级成本递增,重排是其中最贵的一级,因为它可能波及全文档。
触发重排的典型操作:读写几何属性(offsetWidth、getBoundingClientRect)、增删节点、改尺寸边距、窗口缩放、字体加载完成。只触发重绘的:改颜色、背景、visibility。完全避开的:改 transform 与 opacity(合成器层处理,第 6 章详述)。
最阴险的代价模式是「读写交错」:
const box = document.querySelector('.box'); for (let i = 0; i < 100; i++) { box.style.width = (100 + i) + 'px'; console.log(box.offsetWidth); // 每轮读一次几何 → 强制同步布局,最多一百次重排 }
浏览器本会把一百次样式改动合并成一次重排,但循环里那行 offsetWidth 读取逼它当场算出布局——强制同步布局(layout thrashing)。修法是把读与写分开批量做:
const widths = []; for (let i = 0; i < 100; i++) widths.push(100 + i); for (const w of widths) box.style.width = w + 'px'; // 只写,浏览器合并成一次重排 // 确实要读几何,集中读一次,缓存后使用 const rect = box.getBoundingClientRect();
图 5.1-1 一次 DOM 写操作的三级连锁与合并机会
二、批量建节点的两条路线
往列表里插一百项,三种写法代价不同:
const list = document.querySelector('ul'); const data = Array.from({ length: 100 }, (_, i) => `条目${i}`); // 写法一:逐个 append,最多触发一百轮布局更新提示 data.forEach(t => { const li = document.createElement('li'); li.textContent = t; list.appendChild(li); }); // 写法二:DocumentFragment 先攒再挂,树只动一次 const frag = document.createDocumentFragment(); data.forEach(t => { const li = document.createElement('li'); li.textContent = t; frag.appendChild(li); }); list.appendChild(frag); // fragment 内容一次性并入,本身不产生多余节点 // 写法三:innerHTML 一把梭(结构字符串现拼时) list.innerHTML = data.map(t => `<li>${t}</li>`).join('');
写法三是字符串模板路线:引擎解析 HTML 片段、重建子树,一次连锁。三者的取舍:数据驱动、模板复杂时 innerHTML 或模板字面量简洁高效,但用户内容必须先转义(安全红线,第 7 章展开);需要保留引用、逐项绑定事件时 createElement 路线更可控;大批量纯插入时 fragment 是标准答案。实测三者都在毫秒级完成百项插入,数量级拉到上万时 fragment 与 innerHTML 明显领先逐个 append。
已有的节点搬家用 append(旧 API appendChild 的现代化版本:支持多参数与文本节点);移动不是复制——原位置的节点会消失,这个语义用来做「节点换位置」零成本。克隆用 cloneNode(true),注意它不带事件监听器(监听器挂在节点身上,克隆体是白纸——这也是事件委托的另一个理由:委托挂在容器上,节点随便换)。
三、改文本、属性与类名的最小代价通道
改内容分三档:textContent(全量替换文本,自动转义,安全默认);innerText(触发样式感知的文本提取,读到可见性信息,代价更高);innerHTML(解析 HTML,能力最强风险最大)。纯文本更新一律 textContent。
属性操作两套 API:setAttribute 与直接属性赋值(el.id、el.type)。标准属性用赋值即可;自定义数据走 dataset(data-* 属性的映射)。改类名用 classList 的 add、remove、toggle、contains——比手工拼 className 字符串既快又不易错,且 toggle 的第二参可以强制置位。
样式改动优先级:能改 class 不改内联样式(样式重算集中、可被缓存、主题一致);能改 transform 不改 top left(合成通道,绕过布局);高频动画只碰 transform 与 opacity。这三条是第 6 章浏览器优化的前言,这里先立规矩。
- DOM 是 C++ 对象网的接口包装,重对象,查询结果缓存复用;
- 三级连锁按需触发,重排最贵,读写交错会强制每轮结算;
- 批量写分段合并:集中读、连续写、fragment 攒批、rAF 对齐渲染;
- innerHTML 快但要转义用户内容,textContent 是纯文本的安全默认;
- 改 class 优于内联样式,transform 优于几何属性,动画走合成通道。
综合演练:把一段卡顿的列表渲染改到一次重排
一段典型的「每行更新」代码,改造前后对照:
// 改造前:逐行读布局再逐行写样式 —— 每轮读写交错 function updateBad(list) { const rows = list.children; for (let i = 0; i < rows.length; i++) { const row = rows[i]; const h = row.offsetHeight; // 读 row.style.height = (h * 1.1) + 'px'; // 写 row.style.marginTop = (i * 2) + 'px'; // 写 } } // 改造后:读段集中、写段集中,浏览器合并布局 function updateGood(list) { const rows = Array.from(list.children); const heights = rows.map(r => r.offsetHeight); // 读段:一次读完 rows.forEach((row, i) => { row.style.height = (heights[i] * 1.1) + 'px'; row.style.marginTop = (i * 2) + 'px'; }); // 写段连续,中间无读取 —— 最多触发一次重排 }
改造要点拆解:读段用 map 一次性收齐几何值缓存进数组;写段只碰样式不夹任何 offsetTop、getBoundingClientRect 之类的读取;如需「按新布局再算第二轮」,两轮之间用 rAF 隔开,让浏览器先结算一轮。配合批量建树(fragment)与结构改动最小化,一个万行列表的滚动高亮从「每帧数十次重排」降到「每帧至多一次」——这正是第 6 章优化复盘里那条 80 毫秒长任务的病因与药方。
顺带补一个等价但更省的思路:这类「按下标规律变化」的样式,多数能翻译成 CSS 类或自定义属性——JS 只改一个变量,浏览器在样式系统里算完所有行,渲染线程的活交还给样式引擎,往往比 JS 循环写样式更快也更省电。
常见问答
innerHTML 什么时候算安全问题?
拼接进 innerHTML 的字符串里有「用户可控内容」时就是问题——用户输入 <img 与 onerror 片段就能注入脚本执行(存储型 XSS 的最短路径)。安全口径三条:用户内容一律走 textContent;确需拼结构,先转义(把尖括号等敏感字符替换成实体);富文本需求用白名单净化库处理后再插入。纯静态模板字符串(内容全来自代码常量)没有注入面,可放心用。
textContent 和 innerText 到底用哪个?
默认 textContent:更快(不做样式感知)、更安全(纯文本)、语义更纯。innerText 的特点是「读到渲染后的可见文本」——隐藏元素的文本拿不到、换行按显示效果来。需要「所见即所得」的文本提取(比如复制功能)才用它,其余场景都是 textContent 的领地。
虚拟 DOM 是不是就不用担心重排了?
虚拟 DOM 解决的是「怎么把变更写回 DOM 的次数与范围最小化」(diff 后批量提交),不是消灭重排本身——最终仍要操作真实 DOM。读写交错、频繁改几何属性这些错误写法,框架照样会被拖慢。理解本节的代价模型,你才能读懂框架文档里「避免在渲染函数里读布局」这类规约背后的原因。
常用操作代价速查表
把本节的散点收进一张表,评审与排查时直接对照。量级以常见文档规模为参照,重点看相对关系:
| 操作 | 量级与说明 | 注意事项 |
|---|---|---|
| getElementById | 近似常数,带索引缓存 | 同名 id 多个时只返回首个 |
| querySelector 单层类名 | 与候选集大小相关 | 复杂选择器右端放最具体条件 |
| querySelectorAll | 一次遍历加静态快照 | 结果是死集合,后续增删不同步 |
| classList.toggle | 单次样式重算 | 比手工拼 className 字符串稳 |
| style 内联逐条赋值 | 多次样式重算,可合并 | 批量改用 cssText 或类切换 |
| appendChild 单个 | 结构改动,可能触发布局 | 批量用 fragment 或一次 innerHTML |
| innerHTML 赋值 | 解析加重建子树一次连锁 | 用户内容必须转义 |
| 读 offsetWidth 等几何 | 通常触发强制同步布局 | 集中读,别与写交错 |
| getBoundingClientRect | 同上,含视口换算 | 动画与拖拽里缓存使用 |
| cloneNode 深拷贝 | 与子树规模成正比 | 不带监听器,正好配委托使用 |
表里三处「强制同步布局」条目是重灾区,其余操作多数能被浏览器合并消化。日常自检的口径也简单:热路径里出现的每个 DOM 调用,问一句它是读是写、会不会逼浏览器当场结算——答不上来就回本节找对应小节。
本节与开发者工具的接口
最后一个实操提示:Chrome 开发者工具的 Performance 面板里,紫色条是布局、绿色条是绘制——把本节的三级连锁对着条形图看一次,比再读十遍文字有效。面板还会在强制同步布局发生时给出标记,控制台在开启渲染跟踪时会提示具体脚本行——「读写交错」这类问题,工具已经替你把案发现场标好了。
为什么我刚改了 style,马上读回来却像旧值?
两个原因叠加。其一,内联 style 读回来的是「你设置的字符串」(比如一百像素就还是那个字符串),不反映级联与盒模型计算后的结果——要拿计算值得走 getComputedStyle。其二,布局类属性(宽度、位置)在浏览器批量结算之前,读到的可能是上一轮的值,除非你读的是强制同步布局那一族属性(offsetWidth 等,它们逼浏览器当场算)。区分「我写了什么」与「引擎算了什么」是 DOM 观测的基本功:改完样式要验证计算结果,统一走计算样式加几何属性,并且集中读——这正是本节反复强调的主旋律。
DocumentFragment 与离屏容器怎么选?
两者都实现「先攒后挂」,差别在语义纯度:fragment 是规范提供的「无渲染容器」,挂载时内容整体并入、自身消失,不留任何痕迹;离屏容器(建个不在文档里的元素攒内容)是手工模拟,多一个临时元素的管理成本。常规批量插入一律 fragment;需要「先对子树整体做事件绑定或测量」时,离屏容器更灵活——fragment 在并入前不是文档的一部分,某些测量接口对它不可用。选型记住这句即可:攒内容用 fragment,攒「可交互的半成品」用离屏容器。