5.4 定时器网络与存储的排队现场
5.4 定时器网络与存储的排队现场
本节摘要:浏览器是一座多线程工厂,JS 线程只是其中一个工位:定时器由专门的计时线程看管、网络由网络进程处理、存储走 IO 线程,它们的完成通知都以宏任务形式送回 JS 线程排队。本节把这些 API 对号入座到线程模型与队列模型里,讲清 rAF 与渲染节拍的关系、fetch 的 promise 化返回、localStorage 的同步阻塞本质,以及把重活搬到 Web Worker 的正确姿势。
四个API各排哪条队
一张实测代码把四类 API 的归属演出来:
console.log('1 同步'); setTimeout(() => console.log('2 定时器宏任务'), 0); fetch('数据接口地址') .then(() => console.log('3 网络完成宏任务里的微任务')); requestAnimationFrame(() => console.log('4 渲染前 rAF')); localStorage.setItem('k', 'v'); // 同步执行,占着主线程 console.log('5 存储完同步返回', localStorage.getItem('k')); Promise.resolve().then(() => console.log('6 微任务')); // 实测输出:1 5 6 4 2 3(3 依赖网络,实际时刻最晚)
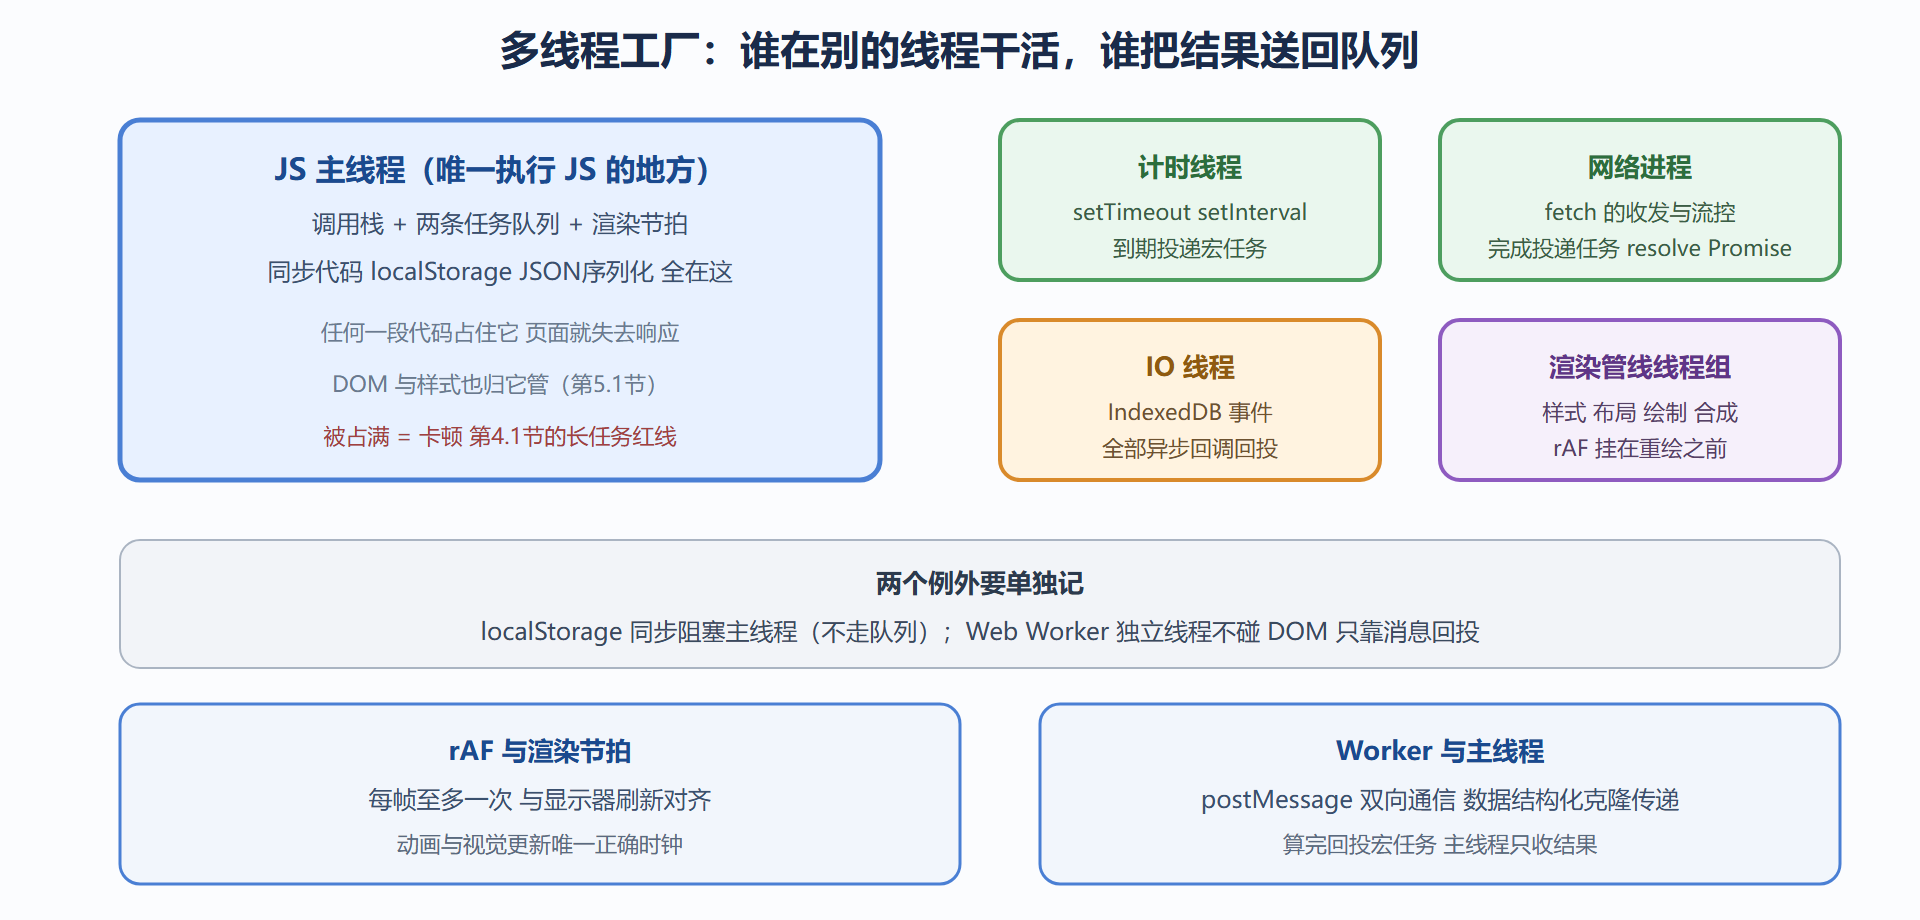
逐个定位。setTimeout:参数交给计时线程,到期后回调进宏任务队列(第 4 章已拆)。fetch:请求由网络进程发出,JS 线程继续跑;响应到达后排队一个任务,resolve 对应的 Promise,then 回调作为微任务紧随其后。rAF:回调登记到「下一次重绘之前」的队列——它不在宏任务与微任务的竞争序列里,而是挂在渲染节拍上(每帧最多一次)。localStorage:完全同步,读写期间主线程干等磁盘——大值写入能直接造成几十毫秒长任务。
图 5.4-1 浏览器多线程工厂与任务回投
一、rAF:挂在渲染上的回调
rAF 的回调在「浏览器下一次重绘之前」执行,天然与显示器节拍(通常约 16.7 毫秒一次)对齐。与 setTimeout 驱动动画的对比:
// setTimeout 驱动:与渲染不同步,可能一帧跑两次(浪费)或错过一帧(抖动) function tickSlow() { move(); setTimeout(tickSlow, 16); } // rAF 驱动:每帧恰好一次,后台标签页自动暂停(省电) function tickFrame(ts) { move(ts); requestAnimationFrame(tickFrame); } requestAnimationFrame(tickFrame);
rAF 回调收到的参数是高精度时间戳,用它算「距上帧的增量」做位移,动画速度就与帧率解耦。后台标签页 rAF 暂停而 setTimeout 只是被节流——这也是「切回来动画跳变」的原因,用时间戳增量即可平滑。取消用 cancelAnimationFrame,与 clearTimeout 对称。
需要「渲染之后、下次重绘之前」的时机则用 requestIdleCallback(空闲档期,适合非关键杂务),配合 rAF 使用能区分「必须这帧完成」与「有空再做」两类工作。
二、fetch:Promise 化的网络接口
fetch 把网络进程的完成通知包装成 Promise,链式处理响应:
async function loadUser(id) { const res = await fetch(`用户接口前缀/${id}`); if (!res.ok) throw new Error(`HTTP ${res.status} ${res.statusText}`); return res.json(); // json 也是 Promise:响应体流式读完才落定 }
三个容易踩的语义点。fetch 只在网络层失败时 reject(断网、DNS 错),HTTP 404 与 500 都是「成功的响应」——res.ok 与 res.status 必须自查。响应体是流,json、text、blob 各自返回 Promise 且只能读一次,要复用先克隆(res.clone())。默认不带 cookie,跨站要配 credentials。组合第 4 章的 race 可以做超时控制:
async function fetchWithTimeout(url, ms = 3000) { const controller = new AbortController(); const timer = setTimeout(() => controller.abort(), ms); try { return await fetch(url, { signal: controller.signal }); } finally { clearTimeout(timer); // 正常完成就解除定时器,别让它误伤后续 } } // 超时触发 abort → fetch 以 AbortError reject → 外层 catch 统一处理(第7章展开)
AbortController 同时也是「用户取消」的标准通道:页面卸载、切换筛选条件时 abort 未完成的请求,避免过期响应回来覆盖新数据(竞态问题)。
三、存储:同步与异步的分界
localStorage:同步 API、容量约 5MB、键值均为字符串、同源共享。写大 JSON 时先 stringify(主线程序列化)再写入(主线程等磁盘)——两段都是长任务候选:
const t0 = performance.now(); localStorage.setItem('cache', JSON.stringify(Array.from({length: 50000}, (_, i) => ({ i })))); console.log('同步写入耗时', performance.now() - t0); // 实测约 25 ms(主线程全程干等)
sessionStorage 同 API 但按标签页隔离,关页即清。Cookie 每次请求自动携带,是「存储」里最贵的一条通道——只放会话标识类小数据。IndexedDB:异步、事务型、容量宽松(数百 MB 起)、可存结构化克隆类型(含 Blob),配合 Promise 包装(idb 这类薄封装)就是前端本地数据库的标准答案;代价是 API 冗长、抽象成本高。
选型口径:界面状态与首屏配置用 localStorage(注意只存可同步读取的小对象);会话内临时用 sessionStorage;离线数据与缓存用 IndexedDB;需要随请求发送的标识用 Cookie。共同纪律:任何存储都不是可靠信道——用户可清空、隐私模式受限、跨标签同步有事件时差,读出来必须做容错解析(try-catch 包 JSON.parse,第 7 章的异常传播正好用上)。
四、Web Worker:把计算搬出主线程
Worker 是独立线程:自己的全局对象、自己的事件循环,与主线程只靠 postMessage 通信,数据以结构化克隆方式拷贝传递(不可共享,除非用 Transferable 转移所有权)。
// 主线程侧 const worker = new Worker('计算模块地址'); worker.postMessage({ dataset: bigArray }); worker.onmessage = e => console.log('算完了', e.data); // Worker 侧(概念示意) onmessage = e => { const result = heavyCompute(e.data.dataset); // 任意重计算,不碰 DOM postMessage(result); };
适用边界很清晰:Worker 里没有 DOM、没有 window,能做的是纯计算与 IO(fetch、IndexedDB 可用)。图像处理、大文件解析、密码学运算、大数据集聚合是典型场景。通信成本(克隆拷贝)决定了「小进大出」的任务最划算——传进少量配置、传回大量计算结果最优;大数组可用 Transferable 零拷贝转移。第 6 章性能优化会把它与长任务拆解一起收进清单。
- 定时器、网络、事件都是「别处干活、队列回投」,主线程只消费任务;
- rAF 是渲染节拍回调,动画唯一正确时钟,后台自动暂停;
- fetch 的 reject 只管网络层,HTTP 错误状态要自查 res.ok;
- localStorage 同步阻塞,大 JSON 是长任务高发区,离线数据走 IndexedDB;
- Worker 隔离线程靠消息通信,小进大出的纯计算最划算。
综合演练:带超时、取消与竞态守卫的搜索框
把本节与第 4、7 章的组合件拼成一个生产级搜索框——四个需求一次满足:输入防抖、请求超时、切换取消、过期结果丢弃:
const input = document.querySelector('input'); const controllerBox = { current: null }; // 记录当前请求的取消器 let latestSeq = 0; // 竞态序号 function debounce(fn, ms = 300) { let timer; return (...args) => { clearTimeout(timer); timer = setTimeout(() => fn(...args), ms); }; } async function search(keyword) { const seq = ++latestSeq; controllerBox.current?.abort(); // 取消上一发 const controller = new AbortController(); controllerBox.current = controller; const timer = setTimeout(() => controller.abort(), 4000); try { const res = await fetch(`搜索接口?kw=${encodeURIComponent(keyword)}`, { signal: controller.signal }); if (!res.ok) throw new Error(`HTTP ${res.status}`); const data = await res.json(); if (seq !== latestSeq) return; // 结果过期:静默丢弃 renderResults(data.items); } catch (e) { if (e.name === 'AbortError') return; // 主动取消不算错误 if (seq === latestSeq) showError(e.message); } finally { clearTimeout(timer); } } input.addEventListener('input', debounce(e => { const kw = e.target.value.trim(); if (kw) search(kw); else renderResults([]); }));
逐项对账:debounce 把连续击键折叠成一次请求(300 毫秒静默期);AbortController 双职能——超时触发与新请求触发共用同一取消通道;seq 序号守卫保证「只有最新请求的结果有资格渲染」;AbortError 静默处理避免「取消自己」被当成错误弹窗。这五十行覆盖了搜索框八成的线上事故形态,每个机制都能在前面的章节找到出处——这就是组合的力量。
常见问答
rAF 回调里能改布局属性吗?
能跑但不推荐:rAF 的正确职责是「在重绘前提交视觉变更」,改 transform 与 opacity 走合成最顺;改几何属性会触发布局,帧预算(16.7 毫秒)可能被吃穿。确需读布局再写布局的「依赖式动画」,读放在 rAF 开头集中做,写放后面,一帧内只结算一次。
fetch 的 body 能发多少种东西?
字符串、URLSearchParams(表单编码)、FormData(带文件上传)、Blob 与 ArrayBuffer(二进制)、以及配手动头的任意序列化结果(比如自己 stringify 的 JSON)。注意发 JSON 要显式设内容类型头——fetch 不会替你猜。下载侧同理:res.blob 与 res.arrayBuffer 把响应体按二进制收全,配合对象地址还能做预览。
localStorage 里放登录态安全吗?
作为「存储位」可以,作为「信任位」不行。脚本可读意味着任何 XSS 都能顺走它(这就是 httpOnly Cookie 存在的理由——脚本读不到)。工程折衷:会话令牌优先放 httpOnly Cookie(配合 CSRF 防护),必须用 localStorage 时(比如无 Cookie 的纯前端方案),配短有效期加刷新机制,并把「防 XSS」当成比「防 CSRF」更优先的安全投入。
存储配额与清理策略
「存着存着满了」是离线应用绕不开的坎,配额体系与现代管理接口值得单独一提。localStorage 的五兆上下是硬约束,超了写入直接抛异常;IndexedDB 与缓存存储走的是「配额管理」体系——由浏览器按磁盘空间动态分配,可用一个查询接口查看用量:
const est = await navigator.storage.estimate(); console.log('已用约', (est.usage / 1048576).toFixed(1), 'MB', '配额约', (est.quota / 1048576).toFixed(0), 'MB'); // 实测形态:已用约 3.2 MB 配额约 60000 MB(不同设备差异极大)
两个配套动作:持久化申请(storage.persist,请求浏览器在压力下不清理本站数据,适合离线优先的应用,是否批准由浏览器决定);** eviction 应对**(浏览器可能在空间压力下清掉非持久数据,应用要能从「缓存全丢」的状态自愈重建——把远端数据当真相、本地存储当加速层,是唯一稳的心态)。
清理策略与第 6 章的缓存淘汰同构:容量上限加 TTL 加按需重建。区别在于存储层的清理要考虑「用户可能正在离线」——清缓存前判断在线状态,离线时保留最近使用的数据段,把清理窗口放到下次联网。这类细节决定了离线功能是「偶尔失灵的噱头」还是「可靠的能力」。
Service Worker 和本节的线程模型是什么关系?
它是线程工厂里一个特殊的员工:独立线程、不碰 DOM、生命周期独立于页面,充当「页面与网络之间的可编程代理」。请求先问它、缓存策略由它执行、离线能力由它兜底——第 4 章的任务队列模型完全适用于它的回调(事件驱动、宏任务粒度)。学习它之前,本节的「谁在哪个线程、结果怎么回投」是必备前置;学它之后,你会看到同一套调度思想在更大尺度(页面级、会话级)的复用。
浏览器对同一域名的并发请求有上限吗?
有,HTTP 层面对同域并行连接数有上限(HTTP 一点一时代通常是六条,多路复用后缓解但仍有流控)。这意味着「并行发十个请求」实际是排队复用连接——总耗时未必等于最慢的一个。前端能做的两件事:减少请求总数(合并资源、内联关键数据);域名分片或升级协议这类基础设施优化交给服务端与运维。看到「并发了但没快多少」时,先想到连接上限这层。
rAF、rIC、setTimeout 三者怎么配合使用?
按「工作的重要与紧急」分层:rAF 承担「必须这一帧完成」的视觉更新(动画步进、绘制指令提交);requestIdleCallback 承担「有空再做」的非关键杂务(预计算、延迟埋点、缓存预热);setTimeout 承担「明确延迟后执行」的调度语义(轮询间隔、防抖)。三者不是竞争关系而是三个档位——把任务按档位归位,是第 4 章调度规则在第 5 章场景里的最后一块拼图。
浏览器的现场到此巡视完毕:树(5.1)、事件(5.2)、加载(5.3)、排队(本节)四条线都在同一个调度框架下运转,一个带超时、取消与竞态守卫的搜索框把这些零件串成了完整示范。下一章潜入更深处——内存的分配与回收,看看页面用久了为什么变卡、变重,以及哪些引用习惯在悄悄扣留资源。