第1章 · 基础概念
第 1 章 · 基础概念
章节摘要:微调是"站在预训练模型肩膀上再训练",理解它需要先补三块地基:机器学习与深度学习的基本框架、参数训练是怎么回事、微调在整个流程里的位置。本章用通俗方式把这三块讲清,并回答一个关键问题——为什么要微调而不是从零训练。
先说结论
阅读完本章,你应当能够:
- 复述机器学习与深度学习的基本流程
- 说清训练、参数、损失函数的关系
- 理解微调与全量训练的差异
- 判断"什么时候该微调"
- 建立训练视角下的模型认知
核心概念速览
一句话记住本章:微调 = 给"通才员工"做专项培训,比从零培养一个新员工便宜得多——这就是微调存在的全部理由。
微调学习地图
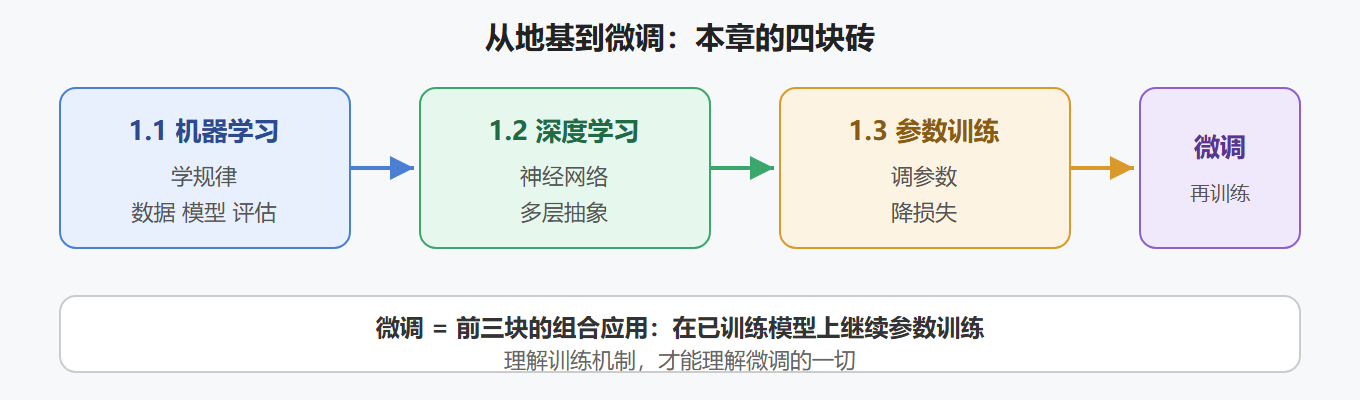
子章节导航
1.1 机器学习基础
机器学习流程、三种学习方式与数据/模型/评估的关系。
1.2 深度学习基础
神经网络的结构、训练机制与深度学习的适用范围。
1.3 参数训练概述
参数、损失函数、优化器——训练三要素与一次训练迭代的完整过程。
1.4 模型微调概述
微调的定义、与全量训练的对比,以及"什么时候微调"的决策逻辑。
子章节之间的逻辑关系
机器学习(1.1) → 深度学习(1.2) → 参数训练(1.3) → 模型微调(1.4) 基础 结构 机制 应用
前三节是"训练"的三块地基,第四节把三块地基用在"微调"这个具体任务上。
前置知识与后续延伸
- 前置:Python 基础;对 PyTorch/Hugging Face 有概念更好,无则随学随查
- 为后续铺垫:本章的训练机制是第 2 章微调策略、第 3 章参数训练的理论基础
本章学习建议
本章是地基,节奏放慢一点:把机器学习的损失函数、梯度下降和深度学习的反向传播这三件事彻底想明白,后面所有章节都建立在它们之上。建议边读边在纸上画出"数据 → 模型 → 损失 → 梯度 → 更新"的闭环,再对照书中的代码把一次完整训练跑通,这比记住任何公式都重要。
评论区
(0)
U