1.3 参数训练概述
1.3 参数训练概述
本节摘要:训练 = 参数 + 损失 + 优化器的三方协作。本节讲清训练三要素各自干什么、一次训练迭代的完整过程、训练中的三个关键参数(学习率、批次大小、轮数),以及它们之间的相互影响——这是后面调参的词汇表。
你能学到什么
阅读完本节,你应当能够:
- 说出训练三要素的职责
- 复述一次训练迭代的完整过程
- 解释学习率、批次、轮数的含义
- 理解三个关键参数的关系
- 看懂训练日志
一、问题与直觉
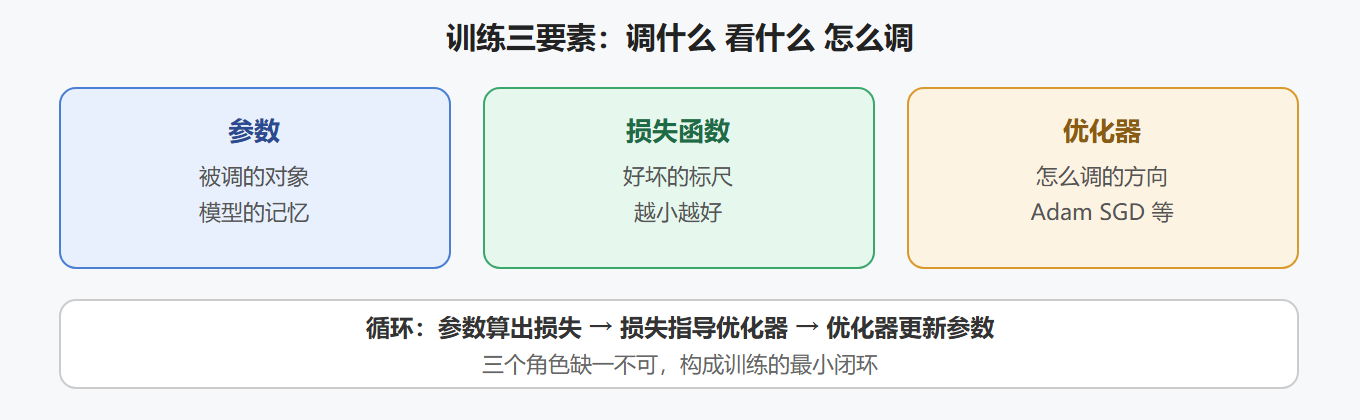
打开任何一份训练代码,无非在调三样东西:模型参数(被调的对象)、损失函数(好坏的标尺)、优化器(怎么调的方向)。再加三个超参数——学习率、批次大小、轮数。搞懂这六个词,训练脚本在你眼里就不再是黑盒。
二、核心原理
2.1 训练三要素
2.2 一次训练迭代
2.3 三个关键超参数
| 超参数 | 含义 | 类比 |
|---|---|---|
| 学习率 | 每次更新走多大步 | 调整旋钮的幅度 |
| 批次大小 | 一次看多少数据 | 一次学几道题 |
| 轮数 | 全部数据看几遍 | 总复习次数 |
三、工程实践要点
3.1 学习率:最重要的超参数
学习率过大,损失剧烈震荡不收敛;过小,收敛极慢。经验法则:微调场景学习率通常为预训练的 1/10 到 1/100——因为起点已经很好,只需小幅调整。
⚠️ 常见坑:直接用预训练的学习率做微调,模型"用力过猛",把已有能力冲掉(灾难性遗忘的诱因之一)。微调先设小学习率,观察再调。
3.2 批次大小与显存
批次大小直接决定显存占用:批次 × 单样本显存 = 单步开销。显存不够时的降级顺序:降批次 → 降精度 → 换参数高效方法(第 5 章)。
3.3 看训练日志的三行
epoch 1/3, loss 2.1, lr 5e-5, grad_norm 0.8 epoch 2/3, loss 1.6, lr 5e-5, grad_norm 0.7 epoch 3/3, loss 1.4, lr 5e-5, grad_norm 0.6
损失在降、梯度范数稳定 → 健康。损失不降 → 学习率太小或数据有问题。损失先降后升 → 过拟合,早停或加正则。
💡 关键直觉:训练日志是模型的"体检单"——每次训练都把损失、学习率、梯度范数记下来,异常一眼可见,排查有据可查。
3.4 三个超参数如何互相影响
学习率、批次大小、轮数不是孤立变量,它们互相牵制,调参时要有"全局观":
| 想解决的问题 | 优先动哪个 | 怎么动 |
|---|---|---|
| 损失震荡不收敛 | 学习率 | 降一个数量级(如 5e-5 → 5e-6) |
| 显存不够(OOM) | 批次大小 | 减半,必要时同步微调学习率 |
| 验证损失回升(过拟合) | 轮数 | 提前早停,或加正则 |
| 收敛太慢 | 学习率 + 批次 | 小步提升学习率,或加大批次并配 warmup |
一条容易踩的联动:批次加大后,梯度估计更稳,同样的学习率可以更大。反过来,用 LoRA 这类参数高效方法时,可训练参数变少,学习率通常可以比全量微调大一些。这些经验不是教条,而是"先改一个变量、观察再改下一个"的实验方法——微调调参本质上是在做受控实验,每次只动一个旋钮,记录结果,再决定下一步。
另一个高频困惑是"训练多少轮够"。经验上:数据量小(几千条)时 1~3 轮即可,轮数过多反而容易过拟合;数据量大时轮数可以适当增加。判断标准永远是验证集曲线:验证损失不再下降甚至回升,就停。这也解释了为什么现代训练框架普遍内置"早停(early stopping)"回调——它在验证指标连续若干轮不提升时自动终止训练,省时且防止过拟合。
核心回顾
把本节的核心收敛成一句话:训练就是在"参数、损失、优化器"这个闭环上反复迭代,而学习率、批次、轮数三个旋钮决定迭代的节奏与质量。后面的章节会反复用到这张词汇表——看到学习率、梯度范数、早停这些词,都能回到本节找到它们的确切含义与相互影响。
- 要点一:训练三要素——参数、损失、优化器,构成最小闭环
- 要点二:一次迭代 = 前向-损失-反向-更新
- 要点三:学习率是"步幅",微调设为预训练的 1/10 到 1/100
- 要点四:批次大小直接决定显存占用
- 要点五:看日志三行——损失、学习率、梯度范数
- 要点六:损失先降后升 = 过拟合信号
训练机制懂了,第四块砖——模型微调概述,把前面全部串起来。