1.4 模型微调概述
1.4 模型微调概述
本节摘要:前面三节的地基,在这一节汇成"微调"这个具体操作。本节讲清微调的定义、与全量训练的对比、微调的数据形态,以及最重要的工程判断——什么时候该微调、什么时候不该微调。
阅读收获
阅读完本节,你应当能够:
- 用自己的话说出微调的定义
- 对比微调与全量训练的差异
- 理解微调数据的形态
- 判断"要不要微调"
- 说出微调的主要风险
一、问题与直觉
"模型效果不够好,微调一下"——这句话听着简单,背后是个成本不小的决定。微调要数据、要算力、要时间,可能还会把模型原有能力冲掉。什么时候值得微调,什么时候用提示词或 RAG 就够,是微调工程的第一课。
二、核心原理
2.1 微调 vs 全量训练
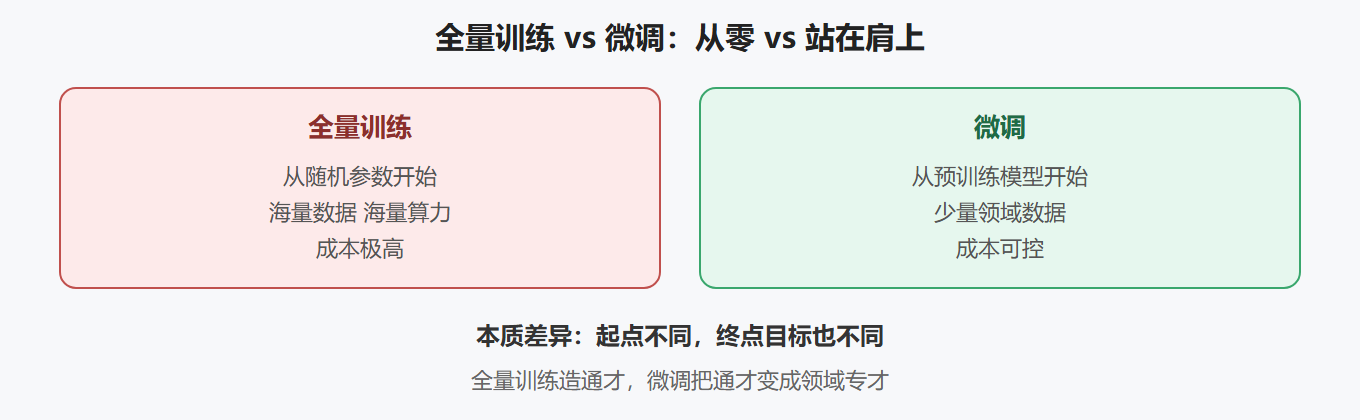
- 全量训练:从随机参数开始,喂海量数据,目的是"造一个基础模型"
- 微调:从预训练模型开始,喂领域数据,目的是"让通才懂你的领域"
2.2 微调的数据形态
微调数据通常是"问题-期望回答"对:
问题:这家店支持哪些支付方式? 期望:支持微信、支付宝、银行卡三种方式,其中……
模型从这些"示例"中学会你的领域的回答风格与知识。
2.3 什么时候该微调
💡 关键直觉:微调是最后手段,不是第一选择。提示词能解决的就用提示词,RAG 能补知识的就用 RAG——只有"行为模式需要固化"(如特定语气、特定格式、特定推理路径)时才值得微调。
三、工程实践要点
3.1 微调 vs 其他方案对比
| 方案 | 解决什么 | 成本 |
|---|---|---|
| 提示词 | 行为定制 | 极低 |
| RAG | 知识补充 | 低 |
| 微调 | 行为固化 | 中高 |
| 全量训练 | 造新模型 | 极高 |
3.2 微调的主要风险
| 风险 | 表现 | 缓解 |
|---|---|---|
| 灾难性遗忘 | 原有能力下降 | 小学习率、混合通用数据 |
| 过拟合 | 只记得微调数据 | 早停、数据增强 |
| 幻觉加重 | 编造更自信 | 高质量数据、评估 |
3.3 微调的决策清单
- 有足够的领域数据吗(至少几百到几千条优质样本)
- 行为模式确实需要固化吗
- 算力与显存预算够吗
- 有评估微调效果的基准吗
四问全"是",微调才值得启动。
⚠️ 常见误区:把该用 RAG 的场景也拿去微调。知识类问题(资料里有答案)用 RAG 更合适——微调擅长"行为固化",不擅长"知识注入",用错场景既费钱效果还差。
3.4 一个微调项目的完整流程
提前看清全貌,后面各章才不会迷路。一个标准微调项目分六个阶段:
数据准备 → 数据清洗与配比 → 训练配置 → 微调训练 → 评估对比 → 部署上线
- 数据准备:收集领域样本,整理成"问题-期望回答"对(第 2 章讲策略)。
- 数据清洗:去重、去噪、配比不同来源数据、划分训练/验证/测试集。
- 训练配置:选择基座模型、微调方法(全量/PEFT)、学习率与批次(第 3 章讲参数)。
- 微调训练:跑训练循环,盯损失曲线与梯度范数,必要时早停。
- 评估对比:用固定评测集对比"微调前 vs 微调后",重点看目标指标是否提升、通用能力是否下降(防灾难性遗忘)。
- 部署上线:导出模型、量化、接推理服务,并建立线上反馈闭环。
这个流程里最容易翻车的是评估环节缺失:很多人微调完"感觉变好了"就上线,却没有用同一套评测集对比基线,结果通用能力悄悄下降而不自知。因此第 4 章的案例都会强调"先定评测、再谈微调"。
本节速览
微调是把"预训练通才"改造成"领域专才"的二次训练:先确认问题确实需要微调(提示词、RAG 都试过之后),再按"数据准备→清洗→配置→训练→评估→部署"的六步流程推进,全程用评测集守住"效果提升、能力不倒退"两条底线。
- 要点一:微调 = 从预训练模型开始,用领域数据继续训练
- 要点二:全量训练造通才,微调造专才
- 要点三:微调数据是"问题-期望回答"对
- 要点四:微调是最后手段,提示词与 RAG 优先
- 要点五:三大风险——遗忘、过拟合、幻觉
- 要点六:启动前过四问决策清单
基础概念全部就位。第 2 章进入微调核心——理论与实践。
评论区
(0)
U