7.1 错误栈与异常传播现场
7.1 错误栈与异常传播现场
本节摘要:异常抛出后,引擎沿调用栈逆向展开:逐层弹出栈帧,每层若带 catch 则接管、带 finally 则收尾,全都接不住就命中全局兜底。Error 对象的 stack 属性是抛出瞬间的栈快照。本节拆展开动作的分镜、内置错误类型的分诊、finally 的控制流细则、自定义错误子类的设计,最后给出「读报错三步法」。
栈展开的逆行路线
一段代码把「逆行」完整演出来:
function level3() { throw new Error('在 deepest 抛出'); } function level2() { try { level3(); } finally { console.log('level2 的 finally 先收尾'); } } function level1() { try { level2(); } catch (e) { console.log('level1 接住:', e.message); console.log(e.stack.split('\n').slice(0, 3).join('\n')); } } level1(); // 实测输出: // level2 的 finally 先收尾 // level1 接住: 在 deepest 抛出 // Error: 在 deepest 抛出 // at level3 ... // at level2 ...
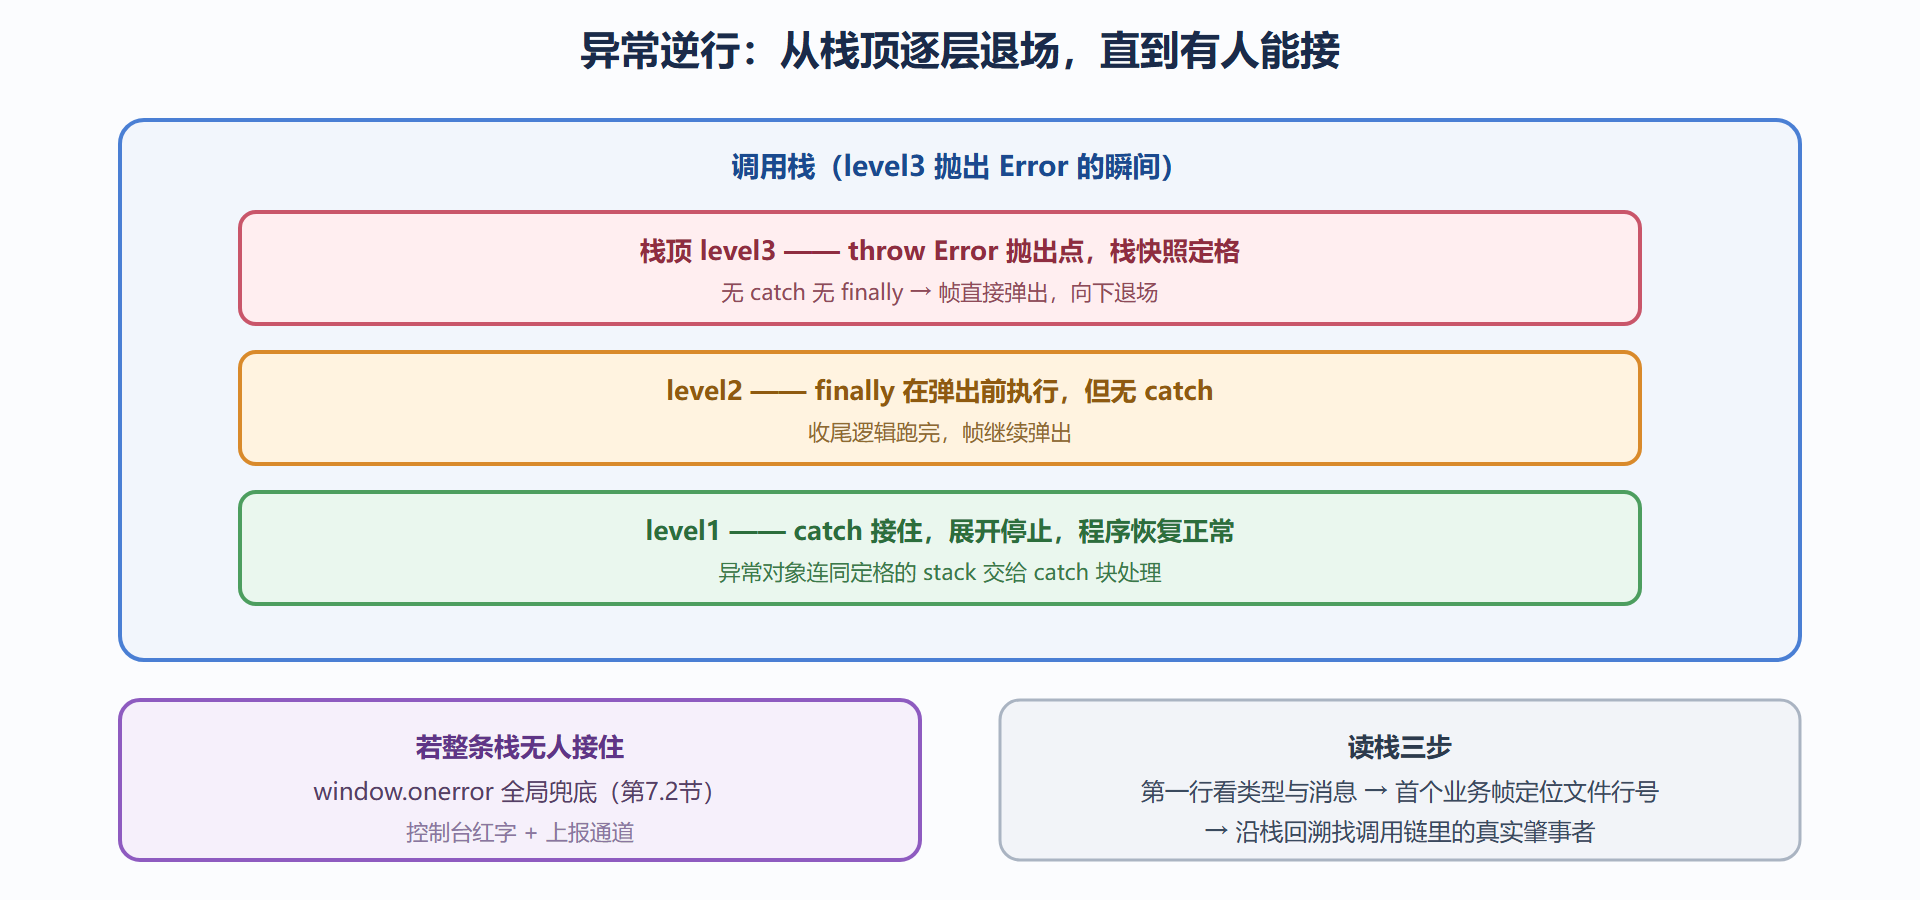
分镜回放:level3 抛出的瞬间,栈上有 level1、level2、level3 三帧,stack 快照定格于此。引擎开始展开:level3 没有 catch也没有 finally,帧直接弹出;level2 有 finally——finally 在帧弹出前执行(打印),但没有 catch,帧继续弹出;level1 有 catch,展开在此停止,异常对象交给 catch 块,程序沿 catch 之后继续正常执行。
两个关键时序。快照在抛出时生成:哪怕异常被外层接住,stack 里记录的仍是案发时刻的完整路径——这就是排错时「读栈即读现场」的依据。finally 沿途逐层执行:无论是否接住、无论 return 还是 throw,只要离开当前帧就先过 finally。
图 7.1-1 栈展开分镜与三层防线
一、错误分诊:四类内置错误的含义
报错第一行是类型名,类型即分诊台:
SyntaxError:编译站拦截(第 1 章),整段脚本未执行。修配置工具或语法本身,运行时 try-catch 救不了它(除非代码在 eval 或 new Function 里)。
ReferenceError:登记表上查无此人(第 1 章)。典型:变量未声明、TDZ 中访问、拼错变量名。Cannot read properties of undefined 属于下一类,注意区分。
TypeError:值未就位或类型不对。最常见三兄弟:读 null 与 undefined 的属性、把非函数当函数调用、赋值到不可写属性。xxx is not a function 几乎总是「名字在、值不对」——回看第 1 章 expr 的案例。
RangeError:数值越界——爆栈(Maximum call stack size exceeded,第 2 章)、数组长度非法、数字精度方法参数越界。
自定义错误用子类表达业务语义:
class ApiError extends Error { constructor(message, { status, endpoint, retryable = false } = {}) { super(message); this.name = 'ApiError'; this.status = status; this.endpoint = endpoint; this.retryable = retryable; } } try { throw new ApiError('库存不足', { status: 409, endpoint: '下单接口', retryable: true }); } catch (e) { console.log(e.name, e instanceof ApiError, e.retryable); // ApiError true true }
三个细节:this.name = 'ApiError' 要手动设(否则 name 继承为 Error);instanceof 沿原型链判定(第 3 章);扩展内建 Error 在旧引擎需要 Object.setPrototypeOf 补原型链,现代环境 class extends 直接可用。自定义错误的价值在于 catch 里可以按类型分流处理,而不是对着一个笼统的 Error 猜。
二、finally 的三条细则
细则一:finally 总会执行——try 正常结束、return、throw、甚至 break 与 continue,离开代码块前都过 finally。这是资源清理的立足点。
细则二:finally 里的 return 会吞掉异常:
function swallow() { try { throw new Error('重要错误'); } finally { return '假装没事'; // 异常被这个 return 覆盖,静默消失 } } console.log(swallow()); // 假装没事 —— 错误没了
细则三:finally 里的 throw 会替换原异常——排查时看到的错误可能不是最初那个。两条细则合成一条纪律:finally 只做清理,不做控制流。
try-catch 的包裹粒度也有讲究:包太窄(每行一个)代码噪声大且丢上下文;包太宽(整个函数一大块)定位困难。实践口径是「按错误处理策略分块」——同一段恢复逻辑覆盖的代码放一个 try,比如「整个请求-解析-渲染」用同一个降级策略,就包成一块。
三、读报错三步法
拿一条真实报错走一遍。某页面控制台出现:
Uncaught TypeError: Cannot read properties of null (reading 'value') at validate (表单模块:42:18) at handleSubmit (表单模块:87:9)
第一步读类型与消息:TypeError 加「reading value」——某个 null/undefined 上取 value 属性。第二步定位首个业务帧:表单模块 42 行 18 列,validate 函数。第三步沿栈回溯:handleSubmit 87 行调用了它。打开 42 行,field.value 的 field 为 null——多半是查询选择器没命中(选择器写错或脚本跑在 DOM 就绪前,回看第 5 章「async defer 决定可见 DOM」)。三步之内必有答案;跳步瞎猜才是慢的根源。
生产环境的报错还有两道折损:压缩后行号失真(配 source map,第 1 章推论三)、跨域脚本报错只显示 Script Error(脚本响应头配跨域凭证,上报通道才能拿到完整栈)。这两个问题在下一节的全局兜底里一并解决。
⚠️ 常见坑:空 catch(catch 后面跟个空块或只写一行注释)是错误处理里最坏的写法——异常被按住不出声,程序带着坏状态继续跑,炸在更远的地方。接不住就别接:让异常上浮到能处理的一层,或至少在 catch 里记日志再重新抛出。
- 展开是逆向栈巡礼:无 catch 的帧逐层弹出,finally 沿途收尾,快照定格于抛出时;
- 类型即分诊台:SyntaxError 编译站、ReferenceError 查无此人、TypeError 值不对、RangeError 越界;
- 自定义错误子类带业务字段,catch 按类型分流;
- finally 只做清理,其中的 return 会吞异常、throw 会换异常;
- 读报错三步:类型消息 → 首个业务帧 → 沿栈回溯真实肇事者。
综合演练:给一个库设计错误类型
接手一个数据同步库,调用方需要区分「网络问题该重试、参数问题该修代码、冲突问题该问用户」。错误类型设计三步走:
// 第一步:错误基类——统一「这是本库抛的」判别位 class SyncError extends Error { constructor(message, context = {}) { super(message); this.name = new.target.name; // 子类自动带对的名字 this.context = context; // 结构化的上下文,替代拼进 message 的字符串 this.timestamp = Date.now(); } } // 第二步:三个语义子类,各自携带处理线索 class NetworkError extends SyncError { constructor(message, { endpoint, retryable = true } = {}) { super(message, { endpoint }); this.retryable = retryable; } } class ValidationError extends SyncError { constructor(message, { field, value } = {}) { super(message, { field }); this.detail = { field, value }; // 给修代码的人看 } } class ConflictError extends SyncError { constructor(message, { recordId, remoteVersion } = {}) { super(message, { recordId, remoteVersion }); this.needsUserDecision = true; // 给交互层的行为标记 } } // 第三步:内部把引擎原生错误翻译成语义错误 function translate(e, endpoint) { if (e instanceof SyncError) return e; // 已翻译,幂等 if (e.name === 'TypeError') { return new ValidationError('数据结构不符合预期', { field: '响应体' }); } return new NetworkError('同步失败', { endpoint }); // 兜底归网络 }
调用方的处理因此变成清晰的三岔口:
try { await sync(record); } catch (e) { if (e instanceof ValidationError) { logBug(e.detail); return; } if (e instanceof ConflictError) { askUserMerge(e.context.recordId); return; } if (e instanceof NetworkError && e.retryable) { scheduleRetry(); return; } throw e; // 未知错误上浮,不吞 }
设计要点收拢成三条:name 用 new.target 自动继承(子类不改构造器也不会叫错名);上下文结构化(拼字符串进 message 是给日志的,结构化字段才是给程序的);翻译层幂等(内部任何抛出点都过一遍 translate,重复翻译无害)。这套模式从十行的工具库到万行的平台服务都适用,变化的只是子类数量。
常见问答
Error.cause 是什么,什么时候用?
标准的错误链字段:包装错误时把原始错误挂上,throw new SyncError('同步失败', { cause: e })。价值在排错——上层看到包装后的语义,还能顺着 cause 挖到最初的引擎级异常,不会丢掉案发第一现场。任何「捕获后重新包装抛出」的代码都该带上它,这是零成本的证据保全。
每个函数都 try-catch 会不会更安全?
恰恰相反,那是把错误吞掉的最快方式。安全来自分层:底层(工具、库)抛得准——带语义带上下文;中层(编排)只接「能恢复的」,接不住就透传;顶层(入口与全局兜底)兜住一切并上报。按层分工,每层只做自己该做的错误决策,这比逐函数包裹既安全又可读。
自定义错误要在抛出前校验输入吗?
抛错与校验是两件事:校验是「拒绝坏输入」(在边界处,参数校验失败返回明确的字段级信息),抛错是「报告执行中的意外」。把校验写全的库,抛出的错误才稀少而可信——每个都是真意外,而不是「调用者又传错了」的噪声。边界校验加内部抛错的组合,比满屏 try-catch 的防御式编程可靠得多。
高频报错速读库
最后送一张速查表:控制台最常见的报错文案,对应的含义与排查方向。多数排障在第一行就能定方向:
| 报错文案 | 真实含义 | 优先排查 |
|---|---|---|
| Cannot read properties of undefined | 在 undefined 上取属性 | 数据没到位:接口字段、时序、拼写 |
| Cannot read properties of null | 同上但值明确是 null | 可选链兜住,或补空值分支 |
| xxx is not a function | 名字在、值不是函数 | 声明方式(表达式提升)、导入名 |
| xxx is not defined | 登记表查无此人 | 未声明、作用域拼写、导入缺失 |
| Cannot access before initialization | 死区访问 | 声明提前使用(let const) |
| Unexpected token | 语法站拦截 | 少括号、逗号、压缩产物损坏 |
| Maximum call stack size exceeded | 栈配额耗尽 | 无终止递归、意外成环 |
| Unexpected end of JSON input | 解析空字符串 | 空响应体、缓存脏数据 |
用表的方式读它:第一列是症状,第二列是引擎视角的病理(几乎全部能落到第 1、2 章的机制上),第三列是处方方向。把这张表内化的标志是——看到报错第一反应不是「加个判空试试」,而是「这个值的登记与赋值时序哪里断了」。这时错误就从敌人变成了线索,排障从碰运气变成了流程。
异常安全的资源管理
「出错了也要收拾现场」是 try-finally 的天职,两个资源管理模板覆盖日常绝大多数场景。
模板一:单资源的获取-使用-释放。 无论中途怎么炸,释放必达:
async function withResource(acquire, release, use) { const res = await acquire(); try { return await use(res); // use 内部的异常会向外传 } finally { await release(res); // 但释放先于异常离开本帧执行 } } // 用例:锁、事务句柄、临时文件、数据库连接 const result = await withResource( () => checkoutConnection(), (conn) => conn.close(), (conn) => conn.query('查询语句') );
模板二:多步操作的失败回滚。 把「已完成的步骤」记进清单,异常时逆序撤销:
async function transactional(steps) { const done = []; try { for (const step of steps) { await step.execute(); done.push(step.rollback); } return '全部成功'; } catch (e) { for (const rollback of done.reverse()) { await rollback(); // 逆序回滚已完成的步骤 } throw e; // 回滚完再上抛,异常不吞 } }
两个模板的共同骨架正是本节开头的栈展开分镜:异常逆向经过每一层,finally 与 catch 就是每层的「离场手续」。用模板把手续固化,业务代码只写「做什么」,「出事怎么办」交给结构——这是错误处理从「处处设防」进化到「集中承包」的路径。
错误处理写得好不好,有什么检验标准?
三条可操作的标尺。其一,关掉网络与接口跑一遍核心页面:该降级的降级、该提示的提示,而不是白屏或一堆控制台错误——「错误路径也是产品路径」。其二,故意注入异常(测试替身抛错)后,恢复操作能继续:一次失败不污染后续状态,事务感清晰。其三,新人接手时问「这个错误在哪处理」,三十秒内能指着具体 catch 或兜底给出答案——错误处理的结构可见。三条全过,错误处理就从「写了不少 try」升级成了「有错误处理设计」。
本节知识和错误监控平台怎么衔接?
监控平台的价值依赖本节的两个基本功:错误分类(平台的告警分组策略要贴合你的错误类型设计,否则全是噪声)与栈阅读(收到告警后的定位速度取决于读栈的熟练度)。反过来,平台补上了本节覆盖不到的两块:聚合(同一错误的百万次出现归并成一条)与趋势(版本维度的对比发现回归)。人机分工一句话:机器管「发现与统计」,人管「阅读与裁决」——本节练的正是人这半边。
同步世界的错误至此走完全程:展开分镜、分诊台、finally 细则、自定义错误类型、读报错三步法、资源管理模板与高频报错速读库——这套装备能应付绝大多数「炸了之后」的场景。下一节转向异步通道——rejection 如何漂移、两道全局防线怎么布、以及一个生产级上报器的完整骨架,让错误不只被接住,还被看见。