2.3 不同类型模型的微调
2.3 不同类型模型的微调实践
本节摘要:不同架构的模型,微调方式天差地别。本节分三类讲清:BERT 类编码器(分类任务)、GPT 类解码器(生成任务)、多模态模型(图文任务)——各自的微调目标、数据形态与常见做法。
上手前先明确
阅读完本节,你应当能够:
- 区分 BERT 类与 GPT 类的微调目标
- 为编码器模型设计分类微调
- 为解码器模型设计生成微调
- 理解多模态微调的输入形态
- 按模型类型选对微调套路
一、问题与直觉
"微调 BERT 的教程"和"微调 GPT 的教程"完全不同——因为它们解决的问题不同。BERT 类擅长"理解"(分类、抽取),GPT 类擅长"生成"(对话、写作)。先搞清楚你要微调的是"理解型"还是"生成型"模型,方法就清楚了一半。
二、核心原理
三类模型各有所长,微调目标跟着架构走:
2.1 三类模型对比
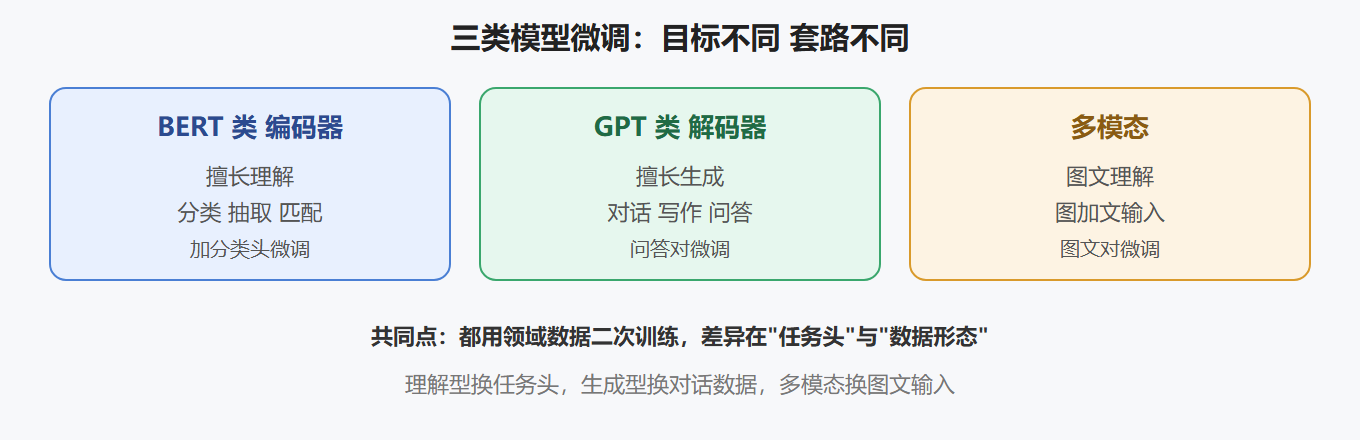
2.2 BERT 类:换任务头
BERT 类模型输出的是"文本理解向量"。微调做法:保留模型本体,换一个分类头,用"文本-标签"数据训练。典型:情感分类、意图识别、实体抽取。
2.3 GPT 类:换对话数据
GPT 类模型输出的是"下一个词"。微调做法:用"问题-回答"对继续训练生成能力。典型:领域客服、写作助手、垂直问答。
三、工程实践要点
3.1 分类微调示例(概念)
# BERT 类分类微调:模型 + 分类头 + 标签数据 # 数据:[(文本, 标签), ...] # 训练:交叉熵损失,小学习率
3.2 生成微调示例(概念)
# GPT 类生成微调:模型 + 问答对 # 数据:[{问题: "...", 回答: "..."}, ...] # 训练:语言模型损失,指令微调格式
3.3 数据形态速查
| 模型类型 | 数据形态 | 任务示例 |
|---|---|---|
| BERT 类 | 文本+标签 | 情感分类、意图识别 |
| GPT 类 | 问题+回答 | 客服、写作、问答 |
| 多模态 | 图+文+回答 | 图文理解、VQA |
💡 关键直觉:数据形态跟着模型架构走——理解型模型要"带标签的数据",生成型模型要"问答对",多模态要"图文对"。数据准备错了,再好的策略也白搭。
3.4 多模态微调注意点
多模态微调输入是"图像+文本"组合,显存与数据准备成本更高。常见做法:先冻结视觉编码器,只微调语言部分,等验证有效再逐步放开。
⚠️ 常见坑:把 BERT 的微调习惯套到 GPT 上。给生成模型喂"带标签"数据(而非问答对),训练目标不匹配,效果很差——先确认模型架构,再准备对应数据。
3.5 一个可运行的分类微调骨架
把 BERT 类微调落到实处,核心只有四步:加载模型 → 准备数据 → 定义损失 → 跑训练循环。下面是一个最小骨架:
from transformers import AutoModelForSequenceClassification, AutoTokenizer, Trainer, TrainingArguments model = AutoModelForSequenceClassification.from_pretrained("bert-base-chinese", num_labels=2) tokenizer = AutoTokenizer.from_pretrained("bert-base-chinese") # 数据:文本 + 0/1 标签 samples = [("这家店服务很好", 1), ("物流太慢了", 0), ("味道一般", 1), ("客服不回消息", 0)] enc = tokenizer([s[0] for s in samples], padding=True, truncation=True, return_tensors="pt") labels = [s[1] for s in samples] args = TrainingArguments( output_dir="./cls_out", learning_rate=2e-5, # 微调用很小的学习率 num_train_epochs=3, per_device_train_batch_size=4, evaluation_strategy="epoch", ) trainer = Trainer(model=model, args=args, train_dataset=enc, eval_dataset=enc) trainer.train()
注意 learning_rate=2e-5——这个数量级正是 2.2 节强调的"微调学习率约为预训练的十分之一到百分之一"。把 num_labels 换成你的类别数、把 samples 换成你的领域数据,这个骨架就是一个可用的生产微调脚本。GPT 类生成微调则把 AutoModelForSequenceClassification 换成 AutoModelForCausalLM,数据格式换成指令式问答对即可。
3.6 多模态微调的典型数据样例
多模态微调的数据形态与纯文本不同,每一条样本同时包含图像与文本。以图文问答(VQA)为例,一条样本长这样:
{ "image": "cat_on_table.jpg", "question": "桌子上有什么?", "answer": "一只猫" }
训练时图像经过视觉编码器变成特征向量,文本经过文本编码器,两者在融合层对齐后预测答案。工程上最常踩的坑是图像分辨率与文本长度的对齐:图像要统一 resize 到模型支持的尺寸(如 336×336),文本要按模型的图文模板拼接(如 "
用户问:{question}"),拼接格式错了,模型训练时 loss 不降,排查半天才发现是格式问题。多模态数据的清洗也比纯文本复杂:要检查图文是否对应、图像是否损坏、问答是否与图相关——建议先人工抽检一百条再开训。
要点串联
- 要点一:BERT 类理解、GPT 类生成、多模态图文
- 要点二:理解型换任务头,生成型换对话数据
- 要点三:数据形态跟着架构走——标签/问答对/图文对
- 要点四:多模态先冻结视觉编码器,验证后再放开
- 要点五:别把 BERT 套路套到 GPT 上
- 要点六:先确认架构,再准备数据
模型类型会微调了,下一节看路上绕不开的问题——微调的问题与挑战。