2.2 微调策略详解
2.2 微调策略详解
本节摘要:微调不是"一条路走到底",而是按显存与效果目标选择策略。本节对比四种主流策略——全量微调、冻结层微调、LoRA、PEFT 家族——讲清各自原理、成本、效果与适用场景,并给出选型决策树。
本节地图
阅读完本节,你应当能够:
- 说出四种微调策略的原理
- 对比各策略的成本与效果
- 理解 LoRA 为什么省显存
- 用决策树为项目选型
- 说出各策略的典型应用场景
一、问题与直觉
"微调用什么方法?"——这个问题没有唯一答案,取决于你的显存和预算。7B 模型全量微调要 100GB+ 显存,个人机器直接劝退;但 LoRA 只调几千分之一的参数,一张消费级显卡就能跑。策略选择的本质,是在效果与成本之间找你的平衡点。
二、核心原理
2.1 四种策略对比
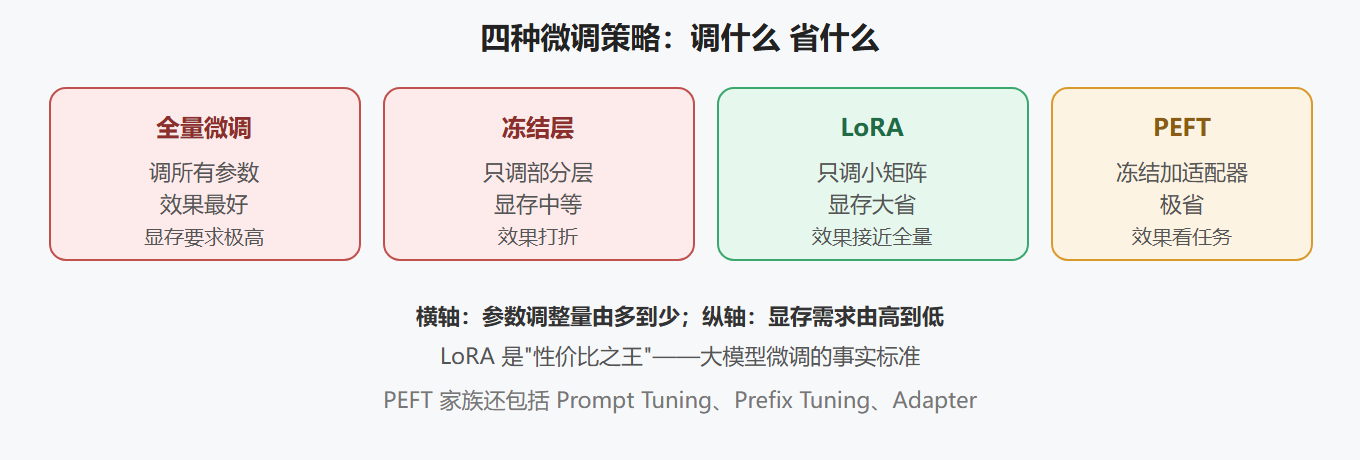
2.2 LoRA 为什么省显存
LoRA(低秩适配)的核心思路:大模型参数矩阵不动,在旁边加一个很小的可训练矩阵。训练时只更新这个小矩阵,显存需求从"全部参数的梯度"降到"小矩阵的梯度"——7B 模型全量要 100GB+,LoRA 只需 20GB 左右。
2.3 选型决策树
三、工程实践要点
3.1 策略选型速查
| 策略 | 显存 | 效果 | 适用 |
|---|---|---|---|
| 全量微调 | 极高 | 最佳 | 有算力、效果至上 |
| 冻结层 | 中 | 中 | 数据少、任务简单 |
| LoRA | 低 | 接近全量 | 大模型微调首选 |
| PEFT 家族 | 极低 | 看任务 | 显存极度受限 |
💡 关键直觉:大多数大模型微调项目用 LoRA——它把"个人能跑"与"效果接近全量"两个目标同时满足。除非你有明确理由,否则从 LoRA 开始。
3.2 LoRA 的核心超参数
| 参数 | 含义 | 经验 |
|---|---|---|
| r | 低秩维度 | 越大越强但越贵,常用 8-64 |
| alpha | 缩放系数 | 通常为 r 的 1-2 倍 |
| target_modules | 挂载哪些层 | 注意力层常用 |
3.3 冻结层微调的做法
# 概念示意:冻结大部分层,只训练顶层 for name, param in model.named_parameters(): if "classifier" not in name: # 只训分类头 param.requires_grad = False
3.4 踩坑提醒
⚠️ 常见坑:LoRA 不是银弹。任务与预训练领域差异极大时,LoRA 的表达能力可能不足——先小规模实验验证效果,再决定是否升级到全量。
3.5 用 PEFT 库跑一次 LoRA 微调
PEFT 是 Hugging Face 官方的参数高效微调库,几行代码就能给模型挂上 LoRA:
from transformers import AutoModelForCausalLM from peft import LoraConfig, get_peft_model model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen2.5-0.5B") lora_cfg = LoraConfig( r=8, # 低秩维度 lora_alpha=16, # 缩放系数 target_modules=["q_proj", "k_proj", "v_proj", "o_proj"], lora_dropout=0.05, ) model = get_peft_model(model, lora_cfg) trainable = sum(p.numel() for p in model.parameters() if p.requires_grad) total = sum(p.numel() for p in model.parameters()) print(f"可训练参数: {trainable:,} / 总参数 {total:,} ({trainable/total:.2%})") # 例如 0.5B 模型挂 LoRA 后,可训练参数通常只有总参数的 0.5%~2%
get_peft_model 会把 LoRA 旁路挂到指定模块上,冻结其余参数。打印出的可训练参数占比就是"省了多少显存"的直接证据——这也是为什么一张 8GB 显存的显卡也能微调几十亿参数的模型。训练时优化器只更新这些少量参数,save_pretrained 保存的也是瘦身后的 LoRA 权重(通常只有几十 MB),部署时再合并回主模型即可。
3.6 全量微调与 LoRA 的效果差距有多大
一个常被问到的现实问题:LoRA 效果真的接近全量吗?大量基准实验的结论是:在数据量中等、任务与预训练领域相关时,LoRA 与全量微调的差距通常在一个百分点以内;但数据量极大(十万级以上)且任务差异大时,全量微调的上限更高。工程上的务实选择是:先用 LoRA 快速拿到一个可用版本并上线验证,若指标确实差口气,再评估是否值得投入全量微调的成本。这种"先 LoRA、后全量"的路径,避免了最贵的方向性错误——花大价钱全量微调后发现数据本身有问题。
另外注意 LoRA 的可组合性:不同任务训练的 LoRA 权重可以按需叠加或切换(同一基座模型挂多份 LoRA 适配器),这在多租户、多任务场景下极具吸引力——模型只需存一份,适配器按业务切换,省显存也省存储。这也是 LoRA 成为大模型微调事实标准的重要工程原因。
本章回顾
- 要点一:四种策略——全量、冻结层、LoRA、PEFT
- 要点二:LoRA 靠"旁路小矩阵"省显存,是大模型微调事实标准
- 要点三:选型先算显存账,再定策略
- 要点四:LoRA 核心参数 r、alpha、target_modules
- 要点五:差异极大的任务,LoRA 可能不够,先实验验证
- 要点六:大多数项目从 LoRA 开始
策略选好了,下一节看不同模型类型怎么微调——BERT、GPT、多模态。