第5章 · 前沿趋势
第 5 章 · 未来趋势与前沿技术
章节摘要:微调技术仍在快速演进。本章覆盖五个前沿方向:参数高效微调(PEFT,用更少资源做微调)、持续学习(模型持续学新东西不忘旧的)、联邦学习(数据不出域也能微调)、AutoML(自动化的模型微调)、可解释性(微调后的模型为什么这么答)。学完本章,你能看懂微调领域的下一步。
阅读收获
阅读完本章,你应当能够:
- 理解 PEFT 家族的原理与优势
- 认识持续学习解决"遗忘"的思路
- 理解联邦学习在隐私场景的价值
- 了解 AutoML 自动化微调的流程
- 认识可解释性对微调的意义
核心概念速览
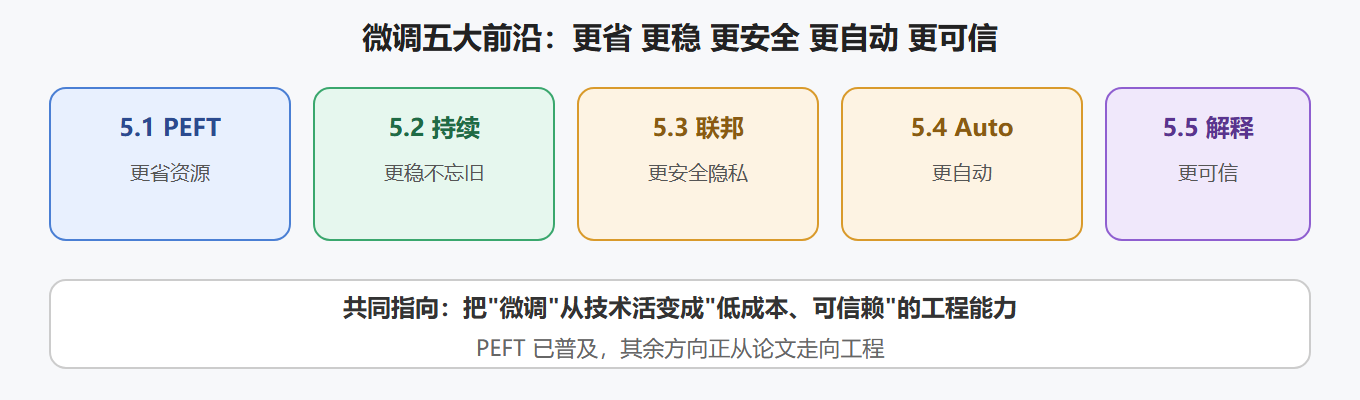
一句话记住本章:微调的未来是"更省、更稳、更安全、更自动、更可信"——五个方向都围绕"让微调更容易落地"。
前沿技术全景
子章节导航
5.1 参数高效微调(PEFT)
LoRA、Prompt Tuning、Prefix Tuning、Adapter 的原理与对比。
5.2 持续学习与终身学习
模型持续学新知识不忘旧能力的思路与方法。
5.3 联邦学习与模型微调
数据不出域的前提下协作微调。
5.4 AutoML 与自动模型微调
用自动化手段搜索数据、策略与超参数。
5.5 模型可解释性与微调
微调后模型的可解释性挑战与应对。
子章节之间的逻辑关系
更省(5.1) → 更稳(5.2) → 更安全(5.3) → 更自动(5.4) → 更可信(5.5) PEFT 持续学习 联邦学习 AutoML 可解释性
五个方向从"资源"到"信任"逐步升级,构成微调技术演进的全景。
前置知识与后续延伸
- 前置:前四章全部内容——本章是微调工程的能力扩展
- 为后续延伸:PEFT 是当前落地的首选;持续学习与 AutoML 是未来工程化的方向
本章学习建议
前沿章的内容演进很快。建议把 PEFT 的几种主流方法(LoRA、Adapter、Prefix)的原理差异吃透,它们能覆盖你未来两年大部分微调需求。持续学习与联邦学习先建立概念框架即可,等真正遇到增量更新或数据隐私需求时再回来深挖。
评论区
(0)
U