5.1 参数高效微调 PEFT
5.1 参数高效微调技术(PEFT)
本节摘要:PEFT(参数高效微调)解决"微调太贵"的问题——只调一小部分参数,效果接近全量微调。本节讲清 LoRA、Prompt Tuning、Prefix Tuning、Adapter 四种方法的原理与对比,以及"为什么 PEFT 成了大模型微调的主流"。
本节导航
阅读完本节,你应当能够:
- 说出 PEFT 的核心思想
- 对比四种 PEFT 方法
- 理解 LoRA 为何成为主流
- 判断何时用 PEFT 而非全量
- 认识 PEFT 的局限
一、问题与直觉
全量微调 7B 模型要 100GB+ 显存,普通人根本跑不了。PEFT 的思路很直接:模型大部分参数不动,只动一小部分"适配"参数——显存需求从"全部梯度"降到"小部分梯度",一张消费级显卡就能微调大模型。用 1% 的参数,拿到 90% 的效果,这就是 PEFT 的价值。
二、核心原理
PEFT 的核心思想一句话:
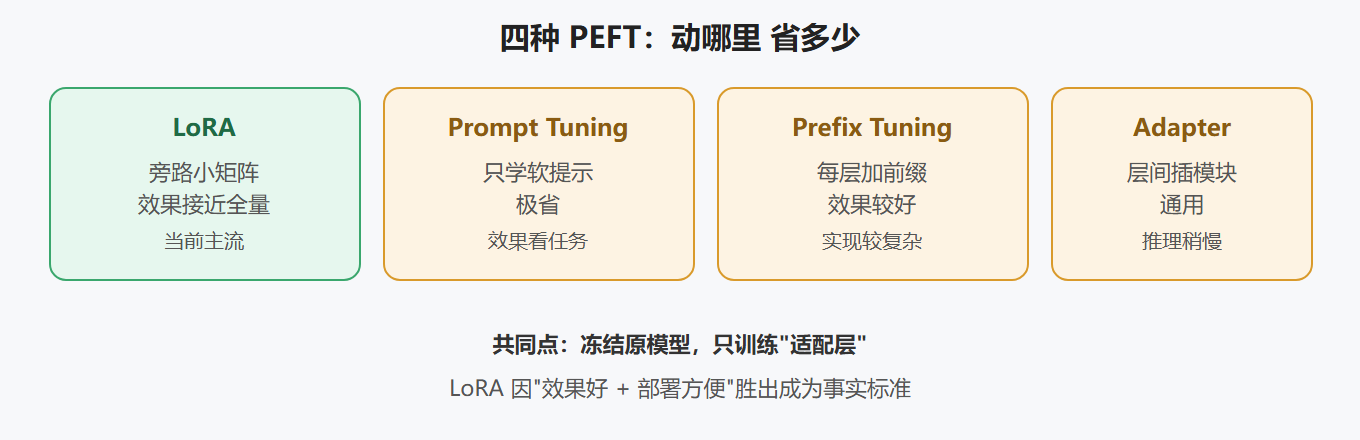
2.1 四种 PEFT 方法
2.2 为什么 LoRA 成为主流
LoRA 的优势不只是省显存:训练产物小(几 MB 的适配器文件,原模型不动)、可叠加(多个任务各一个适配器随时切换)、部署简单(原模型加载适配器即用)。这三点让它从 PEFT 家族中脱颖而出。
三、工程实践要点
3.1 PEFT vs 全量微调
| 维度 | PEFT | 全量微调 |
|---|---|---|
| 显存 | 低 | 极高 |
| 训练时间 | 短 | 长 |
| 效果 | 接近 | 最佳 |
| 产物 | 小适配器 | 全量权重 |
💡 关键直觉:PEFT 不是"妥协",而是"性价比最优"。对大多数业务场景,PEFT 的效果已足够,而成本只有全量的零头——先 PEFT,不够再全量,是最优路径。
3.2 选择 PEFT 方法
| 场景 | 推荐 |
|---|---|
| 通用大模型微调 | LoRA |
| 极省显存 | Prompt Tuning |
| 效果优先 | LoRA 或 Prefix |
| 多任务切换 | LoRA(适配器叠加) |
3.3 PEFT 的局限
- 复杂任务效果上限:任务与原领域差异极大时,小适配器可能不够
- 推理开销:部分方法(Adapter、Prefix)推理略慢
- 知识注入有限:新知识大幅增加时,PEFT 力不从心
3.4 工程实践建议
起步:LoRA 跑通全流程 优化:调 r、alpha 与目标层 验证:对比微调前后效果 升级:确实不够再考虑全量
⚠️ 常见坑:把 PEFT 当"万能微调"。PEFT 省的是显存与成本,不是"任务适配难度"——任务与原领域差异极大时,小适配器表达力不够,先小规模验证再决定。
3.5 PEFT 家族横向对比
PEFT 不是只有 LoRA。主流方法按思路分三类:加法型(Adapter,在层间插入小模块)、乘法型(LoRA 及变体,用低秩矩阵近似权重增量)、重参数化/前缀型(Prefix-Tuning、Prompt-Tuning,在输入侧加可学习向量)。三类的共同点是"只训练极少量参数",差异在表达力与部署成本:
| 方法 | 思路 | 可训练参数 | 部署成本 |
|---|---|---|---|
| Adapter | 层间插小模块 | 中 | 需改模型结构 |
| LoRA | 低秩旁路 | 低 | 可合并回主模型 |
| Prompt/Prefix | 输入侧向量 | 极低 | 依赖模型支持 |
工程选择建议:追求通用与部署简单选 LoRA;需要在同一个基座上挂多个任务且频繁切换时,LoRA 的多适配器方案最省;数据极少且模型支持时,Prompt-Tuning 的性价比最高。PEFT 的边界也要清楚:当任务要求模型产生全新的能力(而非适配现有能力)时,参数高效方法可能不够,需要回到全量微调。
再补充 PEFT 的一个实用技巧:LoRA 的秩 r 与效果并非线性关系。实践中 r 从 8 增到 32 通常有明显提升,超过 64 后收益递减,而显存与显式存储成本继续上涨。另一个技巧是"先训后合并再评估":训练时保留 LoRA 权重,评估时合并进主模型对比——合并前后效果应一致,若不一致说明 merge 实现有问题或存在浮点精度损失。
要点速记
- 要点一:PEFT = 只调少量适配参数,用 1% 参数拿 90% 效果
- 要点二:四种方法——LoRA、Prompt、Prefix、Adapter
- 要点三:LoRA 因产物小、可叠加、部署简成为主流
- 要点四:PEFT 是性价比最优,先 PEFT 不够再全量
- 要点五:多任务场景用 LoRA 适配器切换
- 要点六:差异极大的任务 PEFT 可能不够,先验证
PEFT 让微调"更省",下一节让模型"更稳"——持续学习与终身学习。
一句话收束:PEFT 的本质是用"极小参数子空间"逼近全量微调的效果——选择时先问自己三个问题:任务是否适配现有能力(不匹配就上全量)、显存与部署约束多紧(越紧越倾向 LoRA)、是否需要在同一基座上频繁切换任务(是则多适配器方案最优)。
秩的选择最终由数据规模与任务难度共同决定,建议在小规模实验中直接扫描对比。