1.1 源程序与编译器全景
1.1 源程序与编译器全景
本节摘要:编译器的全景是一串工序——词法分析、语法分析、语义分析、中间代码生成、优化、目标代码生成,外加贯穿始终的符号表与错误处理。本节用一条赋值语句走一遍全程,标出它在每个阶段的形态变化,并解释为什么两道工序之间的"接口契约"是理解编译器的钥匙。
阅读完本节,你应当能够:
- 按顺序列出编译的六个阶段,说出每个阶段的输入与输出
- 描述主线语句在每个阶段出口处的形态
- 解释符号表为何是全流水线共享的数据库
- 说明"遍"的概念与多遍编译的取舍
从一行代码的素颜照开始
在一切开始之前,先看清楚我们旅行者的素颜。对编译器而言,源程序没有任何结构,只是一串字节:
源程序字符流(33 个可见字符): t o t a l = p r i c e * q t y - d i s c o u n t ; 编号: 0 1 2 3 4 5 ...
注意几个事实:空格没有语义;total 这 5 个字符对机器而言和 5 个独立字母没有区别;分号只是第 32 号字符。把字符变成"有意义的单位",是第一道工序的事。编译器的经典分工是下面这六站:
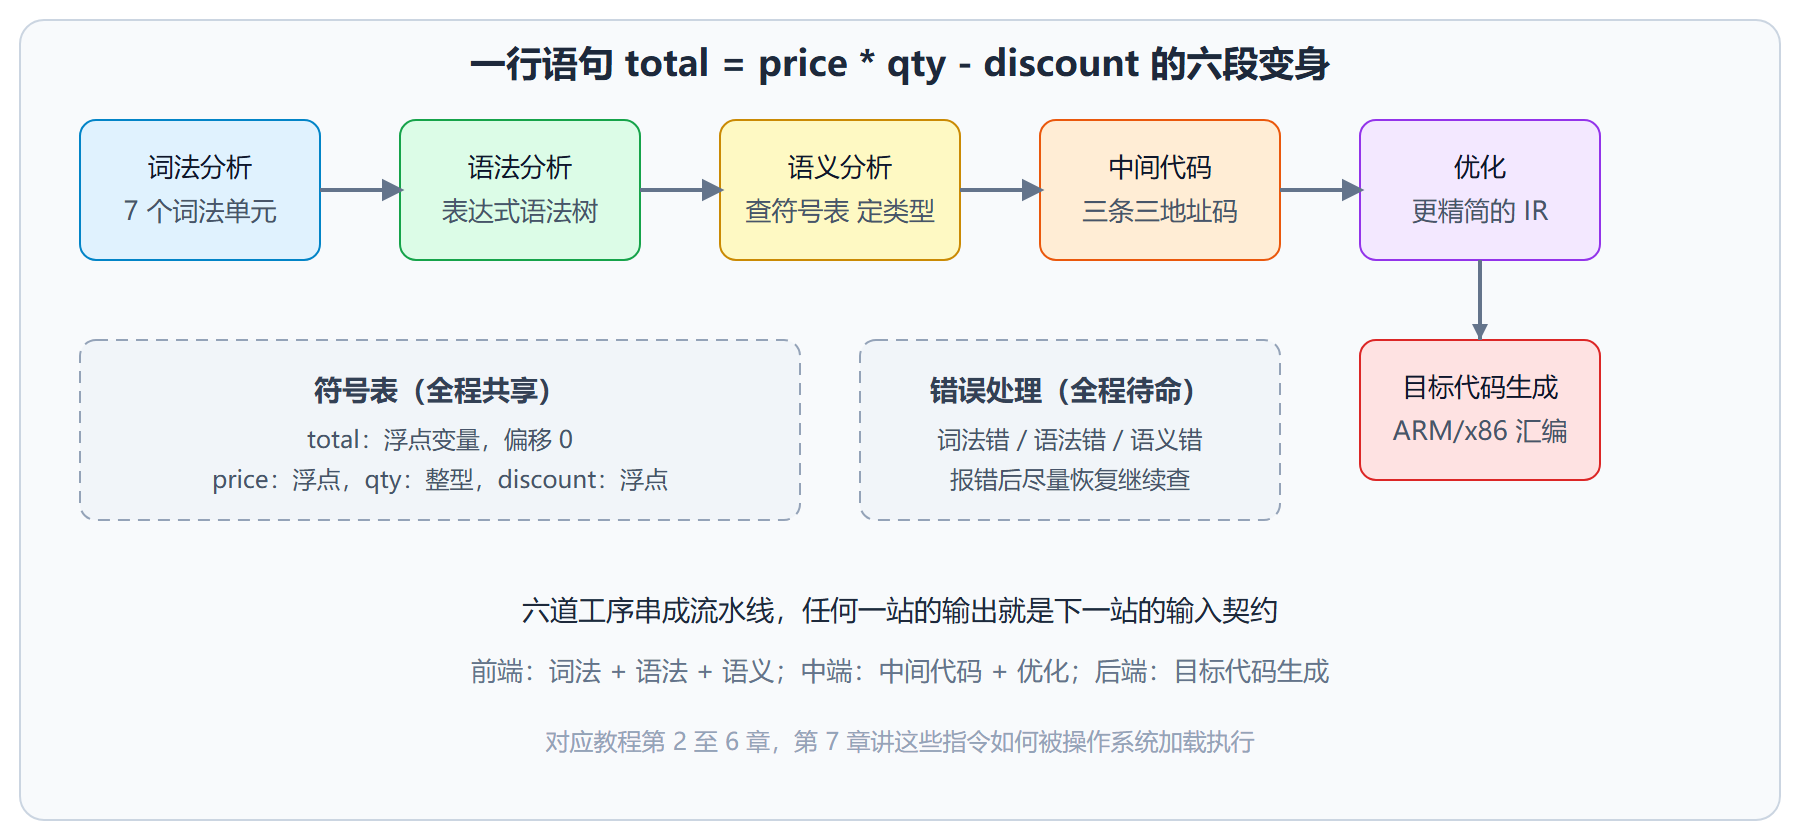
字符流 → 词法分析:字符流 → 词法单元流(token stream) → 语法分析:词法单元流 → 语法树 → 语义分析:语法树 + 符号表 → 带类型标注的语法树 → 中间代码生成:语法树 → 三地址码 → 优化:三地址码 → 更精简的三地址码 → 目标代码生成:三地址码 → 汇编/机器码
主线语句的一站一站
第一站,词法分析。它从左到右扫描,把字符切成语义单位并贴标签。我们的语句被切成 7 个词法单元:
(total, ID) (=, ASSIGN) (price, ID) (*, MUL) (qty, ID) (-, SUB) (discount, ID) (;, SEMI)
total 和 discount 从此不再是无意义的字母堆,而是"标识符"这个类别的成员。空格被丢弃,因为它们只负责分隔。
第二站,语法分析。词法单元流被检查是否符合语言的文法,同时搭出树形结构。赋值语句的右边是一个减法表达式,减号左边是乘法表达式,因为乘法优先级高,所以树长成这样:
赋值语句 / \ total 减法 / \ 乘法 discount / \ price qty
这棵树第一次表达了"先算什么后算什么"——结构即意义。
第三站,语义分析。语法树只管形状对不对,不管讲不讲得通。如果 price 是浮点、qty 是整数,乘法要不要插一条类型转换指令?total 有没有声明过?这些要查符号表——一张全流水线共享的名字登记册。
第四站,中间代码生成。语义检查过的树被翻译成与机器无关的三地址码:
t1 = price * qty t2 = t1 - discount total = t2
三条指令,每条最多一个运算,这就是三地址码的风格。
第五站,优化。如果编译器发现 qty 的值恒为 2,乘法会被改写成加法(强度削弱);如果 discount 是编译期常量 0,整个减法直接消失。优化改的是指令,不改语义。
第六站,目标代码生成。三地址码落成具体机器的汇编,变量被安排进寄存器或栈槽。旅程到此,我们的语句从一行文本变成了若干条二进制指令。
图 编译流水线全景:主线语句的形态变身
符号表:流水线的共享账本
值得单独一提的是符号表。它不属于六道工序中的任何一道,却是所有工序都要读写的登记册:词法分析登记新名字的拼法,语义分析查它的类型,目标代码生成查它的存储位置。用一个简表说明它的成长过程:
| 时刻 | 登记内容 | 谁在读 |
|---|---|---|
| 词法分析 | total 是个标识符 | 语法分析 |
| 语义分析 | total 类型浮点,已声明 | 中间代码生成 |
| 中间代码 | total 对应临时变量与栈偏移 | 优化 |
| 目标代码 | total 映射到寄存器或栈槽 | 汇编输出 |
遍:流水线跑几趟
"遍"(pass)指对整个源文件从头到尾扫一次。一遍编译器边读边生成目标码,速度快但优化空间小;多遍编译器先建好完整的树和表,再反复扫描做优化,编译慢但生成代码质量高。工程上的取舍很直白:教学编译器(如早期 Pascal 的 P4 实现)追求一遍完成;生产编译器(GCC、Clang)动辄十几遍。跨文件编译还要先跑一遍预处理和符号解析,遍数只会更多。
⚠️ 常见误区:把六个阶段想象成"六个程序先后独立运行"。实际上它们常在同一个程序里交织执行——递归下降分析器甚至在分析的同时就把中间代码生成了。阶段是逻辑分工,不是进程划分。
三个常见追问
问一:预处理器算不算编译器的一道工序? 严格说它是独立的翻译阶段——输入字符流、输出改写后的字符流,不产生任何词法单元。传统 C 实现把它作为独立程序挂在编译器前面,现代编译器把它整合进驱动程序但阶段边界仍在。把它画在流水线最左端、词法分析之前,是教科书的通行画法。
问二:符号表为什么能被所有阶段共享,不会互相踩吗? 会踩,所以有纪律:每个阶段只能写入自己负责的字段(词法登记拼法、语义回填类型、代码生成回填偏移),读别的字段自由。这类似数据库一张表的分列授权——共享不等于随意改。
问三:一遍编译器现在还有吗? 有,且离你很近。许多嵌入式领域的轻量编译器、教学用的 Pascal 子集实现都是一遍式;脚本语言的解释器前端(解析即执行)本质也是一遍。多遍与一遍的取舍点始终是同一个:要不要为优化留出全程序视野。
补一问:中间表示到底有几种,都叫什么名字? 常见的至少四种:三地址码(本书主线)、四元组(与三地址码等价的表格形态)、栈式字节码(虚拟机的紧凑选择)、SSA 形式(优化器的通用语)。它们不是竞争关系,一个编译器里常分层使用——前端吐三地址码,进优化器转 SSA,出优化器再降回。第 4.3 节会给出同一表达式在四种形态下的对照。
本节要点回顾
- 六道工序:词法、语法、语义、中间代码、优化、目标代码生成,接口契约环环相扣
- 形态演进:字符流 → 词法单元 → 语法树 → 带类型树 → 三地址码 → 汇编
- 两个配角:符号表全程共享,错误处理全程待命
- 三层视角:前端懂语言、后端懂机器、中端用中间表示解耦两者
- 遍的取舍:一遍快而糙,多遍慢而精,生产编译器选后者
下一节把镜头拉高:同样是把这行语句跑出结果,编译器整体翻译、解释器逐句执行,两条路线的分岔从哪里开始。