1.2 编译与解释:两种翻译哲学
1.2 编译与解释:两种翻译哲学
本节摘要:编译与解释是运行程序的两种哲学——编译器先把整个程序翻译成目标码再执行,解释器边翻译边执行、不留下目标程序。本节用同一行赋值语句对比两条路线的执行轨迹,分析它们在性能、报错时机、可移植性上的差异,并说明现实中 Java、Python 这些"混合派"如何两边取长。
阅读完本节,你应当能够:
- 用执行轨迹图区分编译与解释对同一语句的处理顺序
- 说出两种方式在性能、报错时机、交付形态上的至少三处差异
- 解释字节码 + JIT 为什么是折中方案
- 判断给定的语言实现属于编译型、解释型还是混合型
一场同题竞演
让两条路线跑同一份程序,程序只有一行:
total = price * qty - discount;
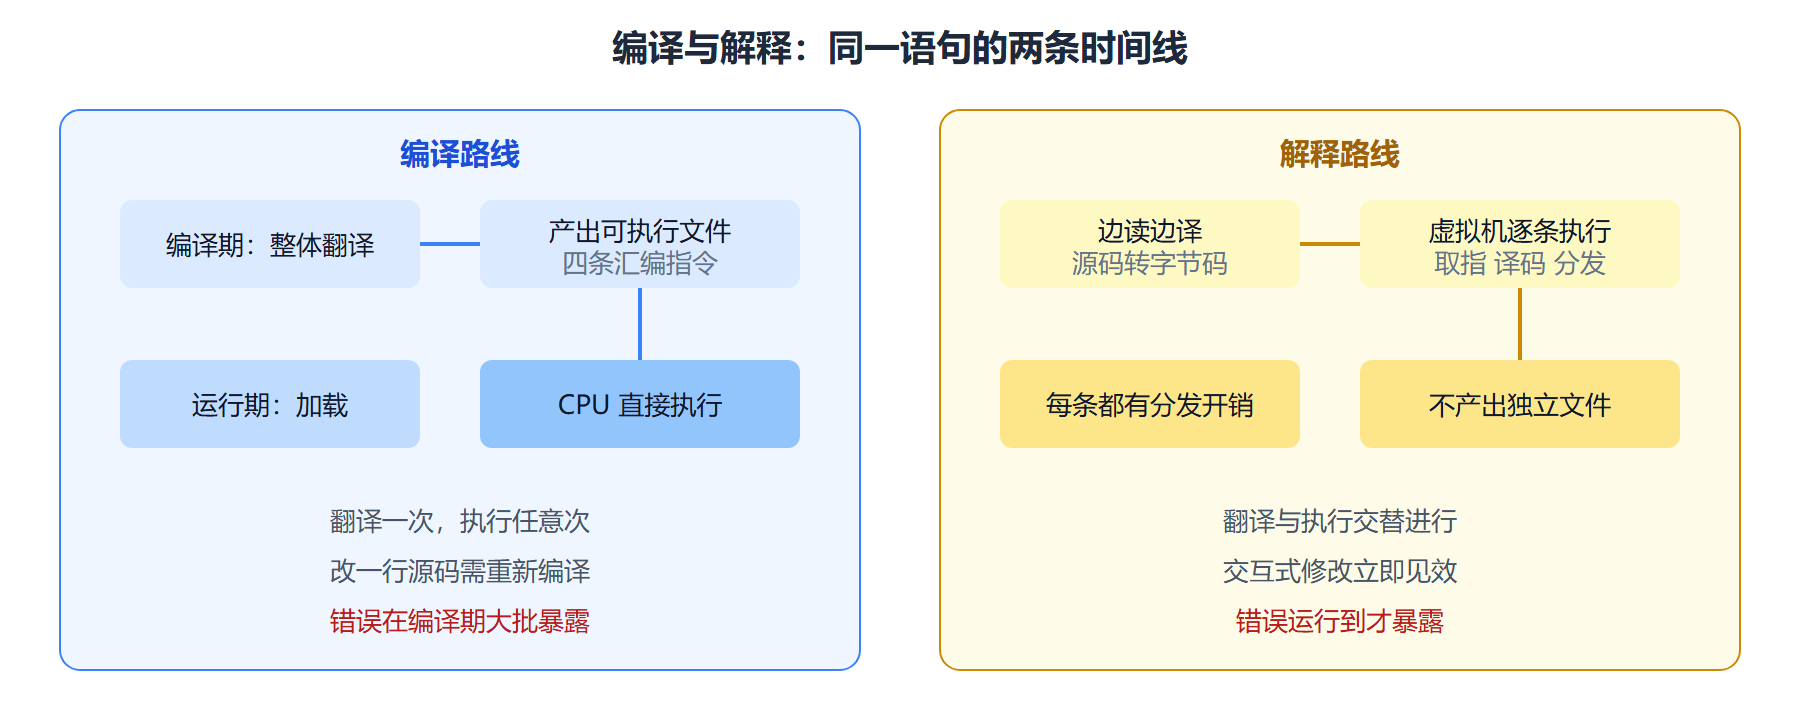
编译路线(以 C 编译器为例)分两拍。第一拍编译:整份源文件被翻译成目标码,这行语句变成大约四条汇编指令,乘法、减法、赋值各就各位,文件落盘为可执行文件。第二拍执行:操作系统把可执行文件加载进内存,CPU 直接执行那四条指令,翻译过程不再发生。你改一个字符,就得重新编译——翻译成果是持久存在的商品。
解释路线(以 Python 解释器为例)没有第二拍,因为第一拍永远不会完整发生。解释器读入源码,先编译成字节码(这是很多人不知道的一步),然后由虚拟机逐条取指、译码、执行:
字节码形态(示意,反汇编输出风格): LOAD_NAME price ;取出 price LOAD_NAME qty ;取出 qty BINARY_MULTIPLY ;相乘,结果压栈 LOAD_NAME discount ;取出 discount BINARY_SUBTRACT ;相减 STORE_NAME total ;存入 total
每条字节码都要经历"取指 → 查分发表 → 跳到处理函数"的循环。同样的乘法,编译路线是 CPU 一条指令直接完成,解释路线是虚拟机先花三条指令弄清楚"接下来该做乘法",才轮到真正的乘法。这个差价,就是解释执行慢 3 到 30 倍的主要来源。
三个维度的对比
| 维度 | 编译执行 | 解释执行 |
|---|---|---|
| 翻译时机 | 运行前一次完成 | 运行中反复进行 |
| 翻译粒度 | 整个程序 | 语句或字节码级 |
| 运行速度 | 快,接近硬件 | 慢,有分发开销 |
| 报错时机 | 编译期抓住大量错误 | 运行到才暴露 |
| 交付形态 | 可执行文件,不含源码 | 通常要交付源码或字节码 |
| 交互性 | 改一行要重编 | 改完立即见效 |
| 可移植性 | 目标码绑定指令集 | 字节码跨平台,随虚拟机走 |
第三行需要展开。编译器有整份程序在手,可以做过程间优化、把跨函数的常量传播到底;解释器每次只看眼前几条指令,很多全局优化无从谈起。第四行也一样值得咀嚼:如果程序第 800 行有个除零检查错误,C 编译器可能编译期就拒绝放行,而解释型语言要等真跑到第 800 行才报错——开发体验上各有拥趸。
图 同一行语句的两条执行轨迹
混合派:两边的好处都要
现实中很少有纯粹的一边倒。主流语言实现几乎都是混合策略:
- Java:先把源码编译成字节码,交给 Java 虚拟机;JVM 里的解释器先跑起来,发现某段代码成为热点,即时编译器(JIT)再把这段字节码编译成本地机器码。冷代码解释执行省内存,热代码编译执行要速度。
- Python:源码先编译成字节码缓存下来,虚拟机再解释字节码。PyPy 这类实现进一步加 JIT,热点循环可提速数倍。
- V8 引擎:JavaScript 先被解释执行(点火),热函数逐级编译优化(涡轮增压),是 JIT 分层策略的代表作。
用一段伪代码描述 JIT 的决策逻辑:
函数调用计数器 heat = 0 每次进入函数: heat = heat + 1 若 heat 小于 阈值: 走解释器路径 ;快启动,零编译开销 若 heat 超过 阈值 且未编译: 触发后台编译为机器码 ;暂停执行一小会儿 替换入口指针 ;下次直接跳机器码 若优化假设被打破(如类型变了): 退回解释器路径 ;去优化,保证语义不变
💡 关键直觉:编译与解释不是非黑即白,而是一个光谱——"翻译在运行前的占比"从 100%(纯编译)滑向 0%(纯解释),Java 与 V8 把滑块放在中间动态调整。第 8 章讲 JIT 时会回到这个光谱。
怎么判断一个语言属于哪派
记住一条原则:谈编译/解释,对象是"实现",不是"语言"。C 语言有编译器实现,也有解释器实现;同一个人工智能辅助工具里的 Python 既可能跑 CPython 也可能跑 PyPy。判断时看三件事:交付物是什么(可执行文件、字节码还是源码)、运行时有没有翻译动作、有没有 JIT 层。这三问比背"C 是编译型、Python 是解释型"这种口诀可靠得多。
延伸讨论
SQL 属于编译还是解释? 都有。数据库收到一条语句后走完整的编译流程(词法、语法、语义、计划生成),产物不是机器码而是执行计划;随后由执行器按计划逐算子解释执行。热点查询还会被缓存计划甚至编译成机器码。它是编译思想在前端、解释思想在执行端的混合体。
为什么即时编译不把整个程序都编了? 编译本身要花时间与内存,而多数程序九成的运行时间集中在一成代码上——把冷代码也编译,启动变慢、内存暴涨,收益趋近于零。热点探测的本质是投资决策:只把预算投给高频执行的代码。
汇编语言要不要编译? 汇编器做的是翻译而非编译——一对一助记符转机器码,几乎不做优化、不建抽象树。它是流水线的极简版,也正因为极简,常被当作理解第 6 章指令选择与寄存器分配的参照系。
补一问:字节码算是编译产物吗? 算半个。字节码是编译的产物(源码到字节码是完整的翻译过程),但程序运行的直接驱动者仍是解释字节码的虚拟机——除非热点被即时编译成机器码。所以判断一个实现的属性,看的不是有没有中间产物,而是最终驱动 CPU 的是编译好的机器指令还是逐条分发的解释循环。
本节要点回顾
- 执行轨迹:编译是"翻译一次、执行多次";解释是"翻译与执行交替"
- 性能差距来源:解释执行的分发开销与丢失的全局优化机会
- 报错时机:编译期大批暴露对比运行到才暴露,各有工程代价
- 混合策略:字节码做中间层,JIT 对热点做即时编译,冷热分流
- 判断口诀:编译/解释是实现的属性,不是语言的属性
哲学辨析完毕,下一节回到工程地面:真要动手造编译器,哪些工序可以请工具代劳。