1.3 编译器构造工具箱
1.3 编译器构造工具箱
本节摘要:词法分析和语法分析有成熟的自动化工具——lex/Yacc、Flex/Bison、ANTLR、JavaCC,它们把"正则表达式→词法分析器""文法规则→分析器"的机械劳动交给机器。本节逐个介绍这些工具接管流水线的哪一段、输入输出是什么,并讨论手写与生成的取舍,为第 2、3 章的手工实现提供对照。
阅读完本节,你应当能够:
- 说出 lex 与 yacc 各自的输入、输出与接合方式
- 解释为什么词法、语法可以自动化而语义分析很难自动化
- 读懂一段简单的 lex 规则和 yacc 文法
- 判断一个项目该用生成器还是手写分析器
为什么要工具
写一个只认 total = price * qty - discount; 的词法分析器,几十行代码够了。但真实语言有几十种词法类别:整数、浮点、字符串、转义序列、注释嵌套……每一种都要一个自动机,每一个自动机都要手画状态、手写转移。1970 年代的 Unix 开发者发现这些自动机全都可以从"正则表达式描述"自动生成,于是有了 lex;同样地,语法分析表可以从"文法规则"自动计算,于是有了 yacc——yet another compiler compiler 的缩写本身就是句玩笑:这类工具太多了。
lex:词法规则的编译器
lex 的输入是一份"正则表达式 → 动作"的对照表。下面这份规则能认出我们主线语句涉及的全部词法:
/* 词法规则示意:左边是模式,右边是动作 */ %{ 计数 无符号数、标识符的数量 %} DIGIT [0-9] ID [a-zA-Z_][a-zA-Z_0-9]* %% {DIGIT}+ { 计数加一; 返回类别 NUMBER, 值为数字 } {ID} { 计数加一; 返回类别 IDENT, 值为字符串 } [ \t\n]+ { 忽略空白,不返回 } "=" { 返回类别 ASSIGN } "*" { 返回类别 MUL } "-" { 返回类别 SUB } ";" { 返回类别 SEMI } . { 报词法错误:无法识别的字符 }
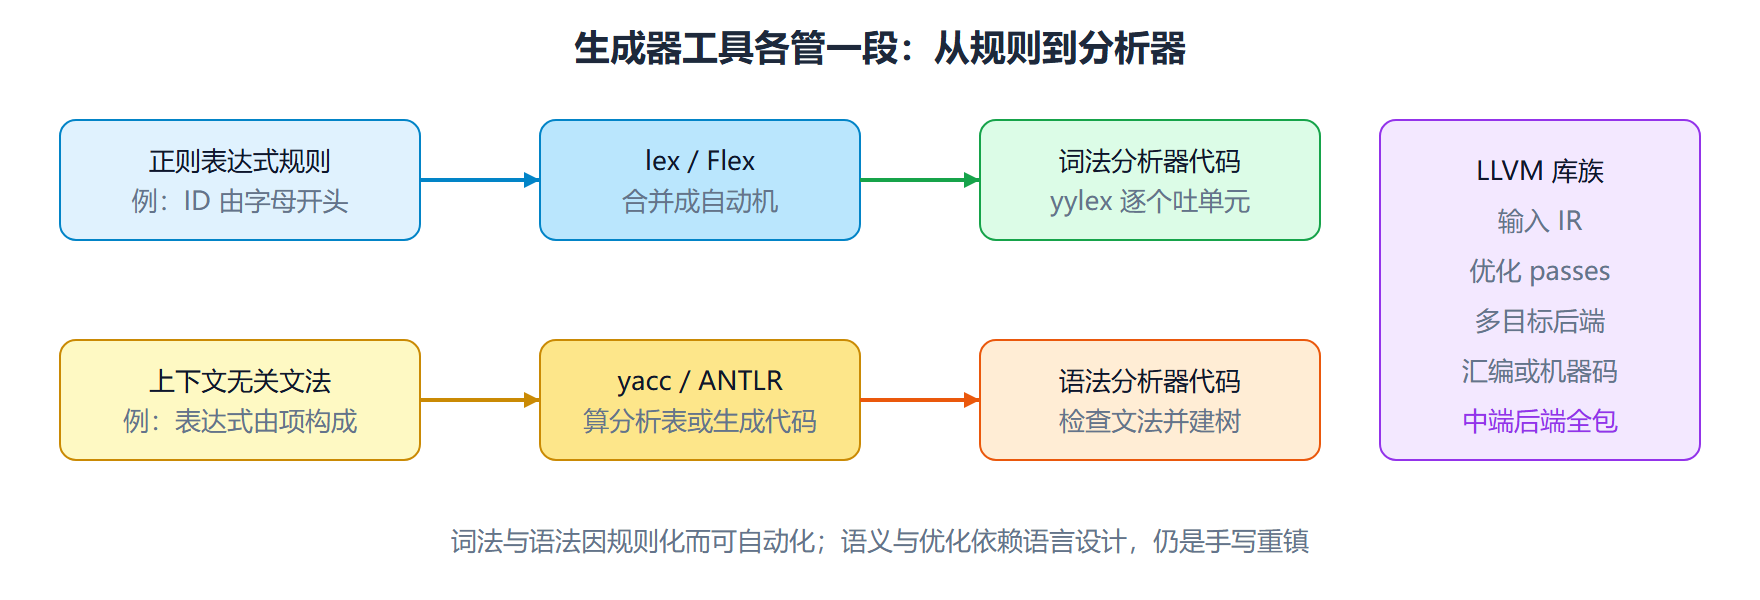
lex 拿到这份规则后,把所有正则表达式合并成一张确定性有限自动机(第 2 章会讲怎么合并),生成一份 C 代码。生成的分析器每次调用 yylex 就吐出下一个词法单元。把主线语句喂给它,输出序列是:
IDENT total ASSIGN = IDENT price MUL * IDENT qty SUB - IDENT discount SEMI ;
yacc:文法规则的编译器
yacc(GNU 版叫 Bison)吃进去的是上下文无关文法,吐出来的是 LALR(1) 分析表驱动的语法分析器。它和 lex 的配合方式是流水线式:lex 每切出一个词法单元就递给 yacc,yacc 查表决定移进还是归约。一段认赋值表达式的文法长这样:
/* 文法规则示意:非终结符 : 候选式 */ 语句 : IDENT ASSIGN 表达式 SEMI 表达式 : 表达式 ADDOP 项 | 项 项 : 项 MULOP 因子 | 因子 因子 : IDENT | NUMBER | LPAREN 表达式 RPAREN
左边的 语句、表达式是非终结符,是要被进一步展开的占位符;IDENT、MULOP 这类大写词是终结符,就是 lex 送上来的词法单元类别。yacc 根据这份文法自动计算分析表,遇到移进/归约冲突还会报警——冲突本身往往暴露文法设计的歧义,第 3 章会正面处理。
一张工具地图
| 工具 | 年代/平台 | 接管工序 | 输入 | 输出 |
|---|---|---|---|---|
| lex / Flex | 1975 / GNU | 词法分析 | 正则规则表 | C 词法分析器 |
| yacc / Bison | 1970s / GNU | 语法分析 | 文法规则 | LALR 分析器 |
| ANTLR | 1989 至今,多语言 | 词法+语法+遍历 | 组合语法文件 | 递归下降分析器 |
| JavaCC | Java 生态 | 词法+语法 | .jj 描述 | 递归下降分析器 |
| LLVM 库族 | 2003 至今 | 中端+后端 | LLVM IR | 目标码 |
ANTLR 与 lex/yacc 一代的最大差别在输出风格:lex/yacc 生成的是表驱动分析器,ANTLR 生成的是手写风格的递归下降代码,可读、可断点、可改——这也是为什么现代语言项目(SQL 解析器、配置语言)偏爱它。LLVM 则更进一步,把中端优化和后端代码生成做成了可复用的库,你只要把语言翻译到 LLVM IR,x86、ARM、RISC-V 的后端全白送。第 6 章的目标代码生成会把这条生态讲透。
图 工具链在流水线上的分工
自动化的边界
为什么没有"语义分析生成器"?因为词法和语法的规约形式(正则表达式、上下文无关文法)数学性质好,算法可以吃规则吐代码;而语义规则千奇百怪——类型相容、名字作用域、继承可见性——写起来本质是一堆过程调用,生成器帮不上忙。属性文法尝试过形式化语义检查,但工程上主流做法仍是:结构靠生成,语义靠手写,在语法树的遍历钩子里填逻辑。ANTLR 的"监听器/访问者"模式就是这个思路的产物:遍历骨架它生成,访问到某个节点该干什么,由你填。
⚠️ 常见坑:拿生成器对付高度歧义的文法,l-reported conflicts 满屏。表驱动 LALR 工具对文法形态敏感,经典案例是 Pascal 的"悬空 else"——不改造文法,工具只会按默认规则消歧。遇到大量冲突,先怀疑文法,再怀疑工具。
💡 关键直觉:生成器最大的价值不是省代码,是把"语言设计"从"代码实现"里解耦——改一条文法规则重新生成即可,不用手改分析器逻辑。这也是为什么语言原型阶段用 ANTLR、性能定稿阶段手写的团队流程很常见。
本节要点回顾
- lex/Flex:正则规则表 → 合并自动机 → 生成词法分析器
- yacc/Bison:文法 → LALR 分析表 → 生成语法分析器,与 lex 以词法单元为接口咬合
- ANTLR:一代工具整合词法语法,输出可读的递归下降代码,现代项目主流
- LLVM:把中端优化与多目标后端做成库,前端只负责到 IR
- 自动化的边界:结构与文法可生成,语义与优化仍靠手写遍历钩子
工具箱清点完毕。下一章正式开工:不用任何生成器,亲手把主线语句切成 7 个词法单元,看清自动机在切分时到底在想什么。