2.1 词法分析器的任务与接口
2.1 词法分析器的任务与接口
本节摘要:词法分析器的任务是读入字符流、按模式切分、输出带类别标签的词法单元流,同时处理空白与注释、维护行号、滤掉宏替换等预处理杂务。本节厘清词法单元、模式、词素三个核心术语,定义扫描器与语法分析器之间的拉模式接口,并给出主线语句的完整切分结果。
阅读完本节,你应当能够:
- 准确区分词法单元、模式、词素,并对任一切分结果标出三者
- 说明为什么扫描器通常被语法分析器"按需拉取"而非一次全推
- 列出词法分析器顺带完成的预处理杂务清单
- 写出主线语句的完整词法单元序列
三个容易混淆的词
先上一张对照表,这大概是词法分析里最重要的三个术语:
| 术语 | 是什么 | 例子 |
|---|---|---|
| 词法单元 token | (类别, 属性值) 二元组,是传递的实体 | (ID, 指向 total 的表项) |
| 模式 pattern | 描述一个类别所有合法拼法的规则 | 标识符:字母开头,后跟字母数字下划线 |
| 词素 lexeme | 源程序里实际匹配上的字符序列 | total、price、qty |
一句话串起来:模式是模板,词素是源码里被模板套中的实物,词法单元是贴好类别标签后的成品。语法分析器只关心类别(比如 ID),个别场合才看属性值(比如赋值目标到底叫 total 还是 t)——这个"只看类别"的设计,让语法规则可以用几十个类别概括无穷多种具体拼法。
用主线语句过一遍切分结果,属性值列全部指向符号表表项:
源程序: total = price * qty - discount ; 切分结果(类别 + 词素 + 属性): 1 ID total 指向符号表第 1 项 2 ASSIGN = 无属性 3 ID price 指向符号表第 2 项 4 MUL * 无属性 5 ID qty 指向符号表第 3 项 6 SUB - 无属性 7 ID discount 指向符号表第 4 项 8 SEMI ; 无属性
空格去哪了?被丢弃。注释去哪了?被丢弃。它们的作用只是分隔词素,本身不携带语义。但换行不能全丢——行号要靠它累计,报错时"第 12 行"的信息来自这里。
接口:推还是拉
扫描器和语法分析器怎么配合?两种方案:
推模式:扫描器先把整个文件切成单元流存进数组,再整批交给分析器。简单直白,但有个致命伤——切到第 800 行才发现第 3 行少个分号,前面的工作白做;而且数组占内存,大文件吃不消。
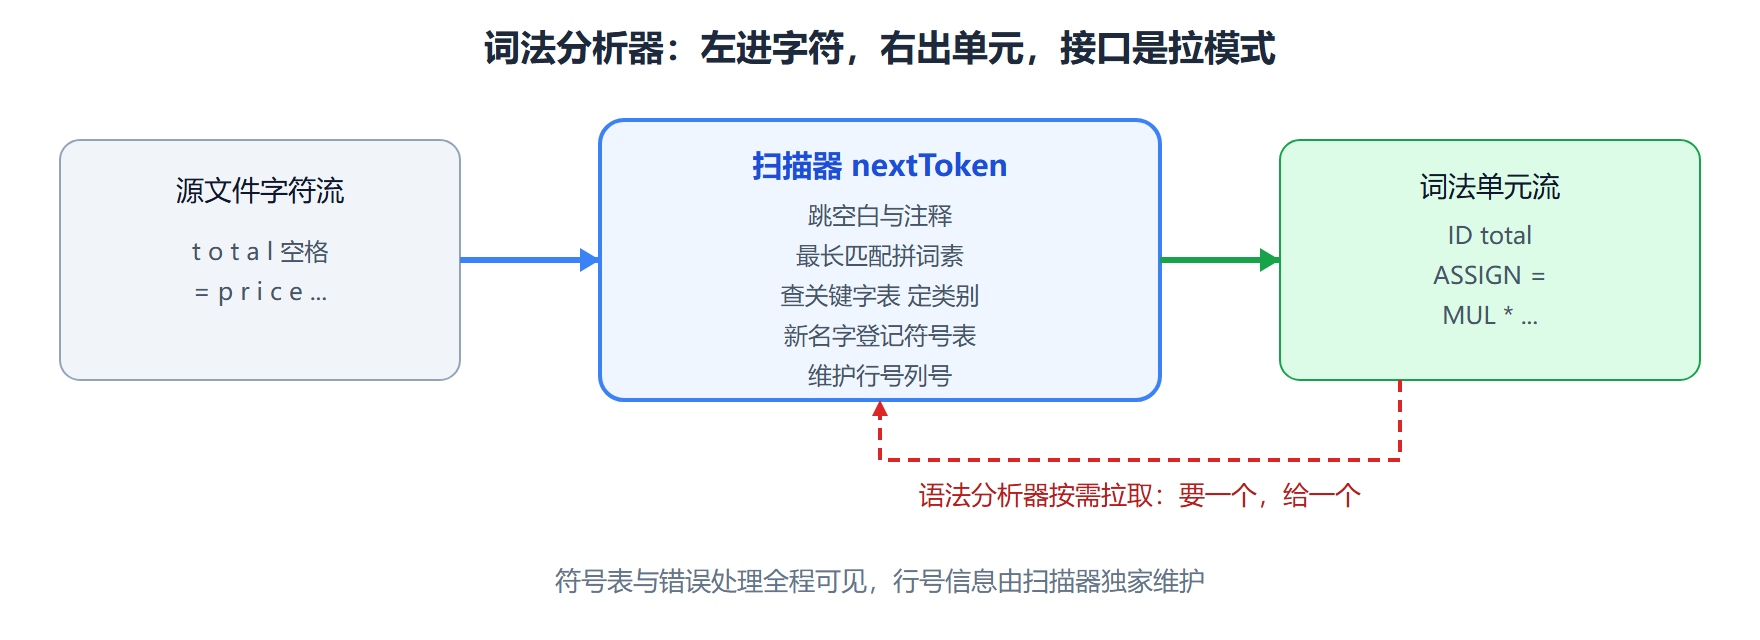
拉模式:分析器每需要下一个单元时,调用一次 nextToken(),扫描器现场切一个交货。主流编译器全是这种。伪代码接口:
函数 nextToken 返回 词法单元: 跳过空白与注释,同时累计行号 读入下一个字符 c 若 c 是字母或下划线: 继续读入字母数字,拼成词素 s 查关键字表:s 若是 if/while 等则返回关键字单元 否则登记符号表,返回 (ID, 表项) 若 c 是数字: 继续读入数字与小数点,返回 (NUM, 数值) 若 c 是单字符运算符: 先向前多看一个字符,判断是单目还是双目 如 - 后跟 = 则返回 SUB_ASSIGN 若 c 是文件结束符:返回 EOF 否则:调用错误恢复例程,返回下一个单元
拉模式还有个隐藏好处:语法分析器可以影响词法行为。典型例子是 C 语言的比较运算符在模板语境要不要拆成两个大于号,需要分析器把语境传给扫描器。推模式做不到这一点。
顺手干掉的杂务
教科书把词法分析器叫"前端的前端",因为它还承包了一批与切词无关的杂活:
- 宏替换与文件包含:C 语言的 include、define 在传统实现里由预处理器完成,预处理器就挂在扫描器之前,本质上是字符流到字符流的改写
- 行号与文件名维护:报错定位全靠它
- 编译指示解析:pragma once 这类指令在词法层拦截,不进入单元流
- 字符串转义还原:反斜杠 n 在源码里是两个字符,交给语法分析器之前应还原为一个换行符
图 扫描器的位置:吃字符,吐单元
类别设计没有标准答案
一个语言要设多少个词法类别?没有定数,但有倾向。类别太粗(如"所有运算符一个类"),语法分析要额外查属性值才能分流,分析表变大;类别太细(每个关键字一类),文法规则爆炸。常见做法是折中:关键字各自一类(它们参与结构判断)、运算符按优先级分簇(算术类、关系类、逻辑类)、所有标识符一类、数字与字符串各一类。第 3 章写文法时会直接用到这里的分类决定。
💡 关键直觉:词法分析器是整个编译器里唯一"逐字符"接触源程序的阶段,所以一切与字符编码、转义、换行风格相关的脏活都天然归它。把这个阶段写得干净,后面所有阶段都可以假装源程序是完美的单元流。
两个容易争起来的问题
问:正则与关键词冲突,谁先谁后? 答案是同一个自动机加两张表。所有类别的模式合并进一张 DFA,识别出一个完整词素后再查关键字表覆盖类别——先最长匹配,后类别修正。这也是为什么 iffy 能被正确识别为标识符而非关键字加标识符:最长匹配先吃完整词,查表发现不在关键字表中,按标识符登记。
问:为什么有的语言关键字不能当变量名,有的可以? 设计取舍。保留字方案让语法分析简单、读者不会被关键字当变量名晃眼;上下文关键字方案对使用者友好,但词法层要依赖后面跟的是什么来判类别,扫描器与语法分析器的耦合变深。工程代价从语言设计一路传导到实现,这正是词法层接口设计的微妙处。
补一问:词法单元里除了类别和属性,还有别的吗? 实际实现还常带位置区间(起始与结束的行列号,供报错与工具跳转)、原始词素(避免二次查表)、以及供语法分析预判的标志位。教学模型两字段够用,工业实现里一个单元七八个字段很常见——每个字段都是某一类下游需求的接口预留。
本节要点回顾
- 三术语:模式是模板,词素是源码实物,词法单元是 (类别, 属性) 成品
- 接口:拉模式 nextToken 按需交付,主流选择,支持语境反馈
- 丢弃与保留:空白注释丢弃,行号保留,新名字登记符号表
- 杂务清单:宏、包含、行号、编译指示、转义还原都在词法层顺手解决
- 类别粒度:粗则分析器受累,细则文法爆炸,按优先级分簇是常见折中
下一节回答本章理论核心问题:模式用什么语言写?答案是正则表达式,以及它的执行装置——有限自动机。