2.2 正则表达式与有限自动机
2.2 正则表达式与有限自动机
本节摘要:正则表达式是词法模式的书写语言,有限自动机是它的执行装置,两者表达能力等价。本节从正则的三种基本运算出发,走完"正则 → NFA → DFA"的机械转换链:汤普森构造把每个正则片段变成小自动机再拼接,子集构造法把非确定性消除。这条链条就是 lex 类工具的内核算法。
阅读完本节,你应当能够:
- 用选择、连接、闭包三种运算读写出词法正则
- 手工把一个正则表达式经汤普森构造变成 NFA
- 用子集构造法把 NFA 确定化成 DFA,并画出转移表
- 说明为什么 DFA 适合做扫描器而 NFA 只适合做中间形态
正则的三个积木
不管语法糖有多少,正则表达式只靠三种运算搭建。设 r 与 s 是正则表达式:
| 运算 | 写法 | 含义 | 词法例子 |
|---|---|---|---|
| 选择 | r 或 s | 匹配 r 或 s | 关键字 if 或 while |
| 连接 | r 接 s | 先 r 后 s | 字母接数字 |
| 克林闭包 | r 星 | r 重复零次或任意次 | 一串数字 |
括号控制结合次序,闭包优先级最高,连接次之,选择最低。标识符的模式用这三个积木就能写出来:
标识符模式(分步构造): 第1步 letter = 小写字母 或 大写字母 或 下划线 ;字符集 第2步 letterdig = letter 或 digit ;字母或数字 第3步 ident = letter 接 letterdig 的星号 ;首字符字母,后面零或多个字母数字 第4步 数字常量 numb = digit 星 接 小数点 接 digit 星 的分支组合
主线语句里的 total、price、qty、discount 全部匹配第 3 步的 ident 模式,23、3.14 这类则匹配第 4 步。注意一个著名细节:digit 星 接 点 接 digit 星 会错误地匹配只有一个点的串,严谨写法要拆成"有整数部分"和"只有小数部分"两个分支。词法模式的坑,往往藏在这些边界上。
NFA:带猜想的机器
非确定有限自动机(NFA)允许两种"不确定":一个状态读同一个字符可以有多条出边;还可以有不读字符就跳转的空边。看一个极简 NFA,识别以 a 结尾的串:
状态集: S0 起始,S1 接受 转移: S0 --a--> S0 ;读 a 留在原地 S0 --a--> S1 ;读 a 也可以跳到接受态(二选一) S1 无出边 接受条件:读完输入串时停在 S1
读入 aa 时机器"不确定"该走哪条边——形式化说法是它同时处于所有可能状态。这不是缺陷,是设计:NFA 的状态可以直接对应正则的结构,正则多复杂,NFA 只是机械地变大,不会变复杂。
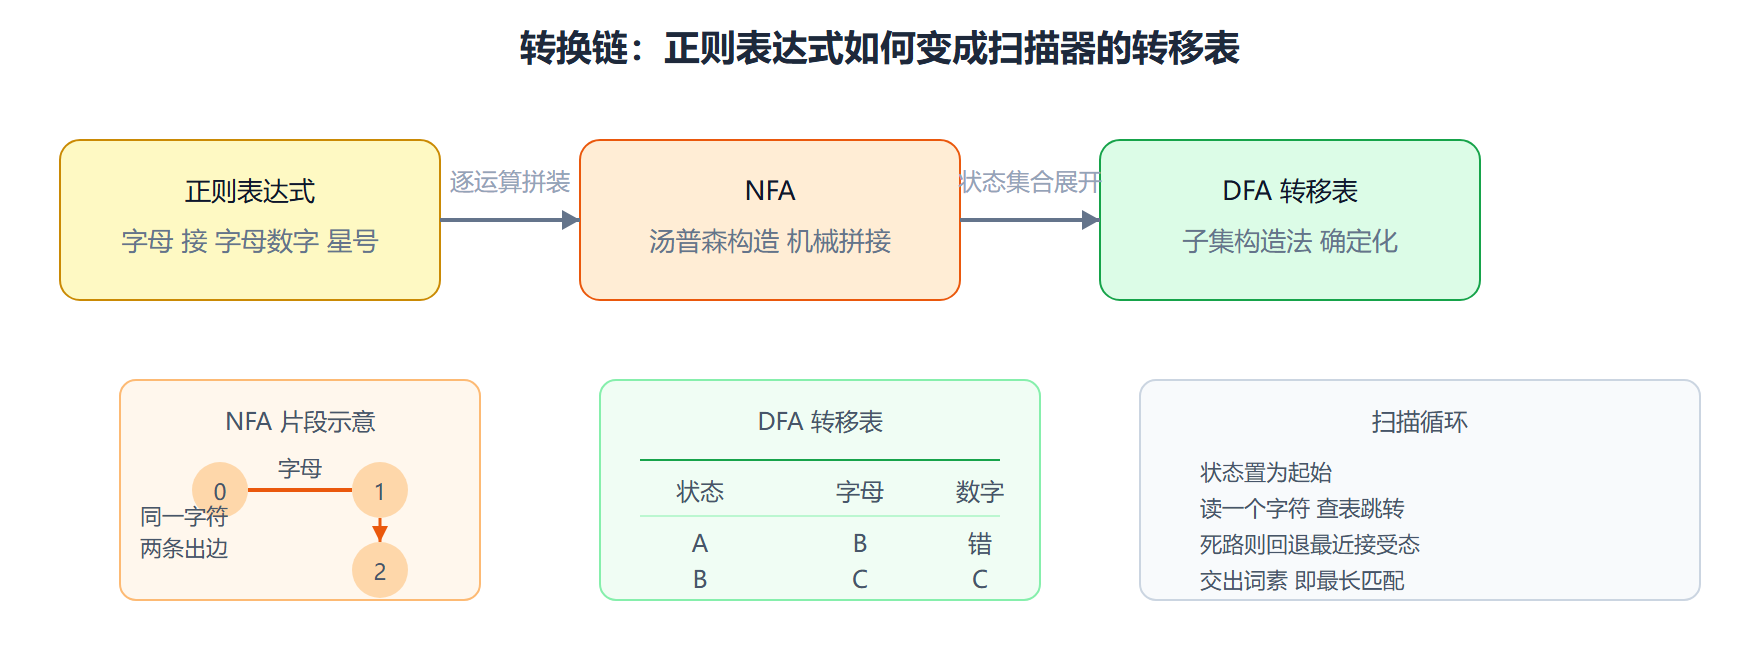
汤普森构造就是把正则翻译成 NFA 的机械流程:每个基本符号造一个两状态小自动机;选择运算把两个小机器并联、加新起点分叉;连接运算串联;闭包运算加回边与空边。规则虽多,每条都是"照图拼积木",全程不需要聪明。
DFA:没有猜想的机器
确定有限自动机(DFA)在任一状态读任一字符,出边至多一条,且无空边。它读一个串只有一条执行路径,查表即走,天然适合写循环。子集构造法负责把 NFA 变 DFA:DFA 的每个状态代表"NFA 状态的一个集合"。
对识别标识符的自动机做确定化,示意性的状态集演化:
NFA 状态编号 0 至 5(ident:首字符字母,后跟字母数字) DFA 状态 = NFA 状态集合 A = {0} 起始 B = {1, 2, 3, 5} 读入一个字母后到达 C = {4, 3, 5} 又读入字母或数字后到达 DFA 转移表: 状态 字母 数字 是否接受 A B 出错 否 B C C 是 ;最长匹配要求继续读 C C C 是
注意 B 同时是接受态又有出边——这正是最长匹配的实现机制:到达 B 时虽已切成一个合法词素,但扫描器继续读,直到走进死胡同才回头取最后一个接受态。discount 走到 dis 时 B 已接受,但机器不停,一路读到第 8 个字符才在空格处回头,交出完整词素。第 2.1 节说的"贪心切分",机器层面就是这么来的。
图 从正则到 DFA 的三级转换链
正则的能力边界
正则表达式不是万能的。经典的"括号配平"(任意深度的嵌套括号)超出了正则的表达能力——有限个状态记不住任意深的嵌套层数。所以 C 语言的块注释可以用正则(它不嵌套),而允许注释嵌套的语言就得靠扫描器里的一段手写小程序辅助。词法结构的分寸感就在这里:正规语言管"平铺",嵌套结构留给文法——这正是词法分析与语法分析的分工边界,也是第 3 章引入上下文无关文法的根本动机。
⚠️ 常见坑:忘了正则里的选择运算只作用于紧邻的前一个单元。想写"匹配 if 或 ignore",必须用括号把两个完整候选括起来再写选择,直接拼接会静默匹配到完全不同的串,这类错误在词法测试阶段才会暴露。
💡 关键直觉:NFA 与 DFA 识别同一类语言,差别只在"执行成本"。NFA 是给人设计用的(结构对应正则、易于拼接),DFA 是给机器执行用的(每步查一次表)。编译期把 NFA 确定化,就是把"猜"的成本一次性付清,运行期每字符只做一次表访问。
再往深处问一步
问:既然 DFA 快,为什么还需要 NFA 这个中间形态? 因为构造方向不同。NFA 与正则结构一一对应、易于拼接(汤普森构造的每条规则都只是拼积木);而直接从正则构造 DFA 没有对应的机械算法,必须经 NFA 中转。工程上还有一个理由:正则引擎若采用运行时模拟 NFA 的策略(同时维护状态集合),可以支持捕获组、反向引用这些超能力——DFA 做不到捕获,因为它丢弃了匹配经过哪些路径的信息。
问:词法分析器为什么不用正则库直接实现? 正则库假设一个表达式独立匹配一个串,而扫描器的问题是多个表达式竞争匹配输入流的最长前缀。合并多模式自动机、维护最长匹配与优先级,这些词法特有的调度逻辑正则库不提供,所以 lex 类工具的核心贡献正是多模式 DFA 的合并与调度。
本节要点回顾
- 三种积木:选择、连接、克林闭包,一切词法正则由此搭建
- 汤普森构造:正则逐运算翻译成 NFA,机械拼接无需聪明
- 子集构造法:DFA 状态即 NFA 状态集合,消除非确定性
- 最长匹配的实现:接受态之外继续转移,死路时回退最近接受
- 能力边界:正则管平铺不管嵌套,嵌套归文法,两级分工由此划定
理论链条打通了,下一节挽起袖子:不用 lex,手写一个真能跑的扫描器,逐字符切完主线语句。