6.1 目标机器模型
6.1 目标机器模型
本节摘要:代码生成算法需要一个抽象机器模型:三地址指令集、多种寻址方式、以"1 加访存次数"计的指令代价。本节建立这个模型,用主线语句的两种翻译对比寻址方式对代价的影响,并说明 RISC 与 CISC 两种真实指令集风格如何映射回模型。
阅读完本节,你应当能够:
- 写出模型机的指令形态与代价公式
- 计算同一表达式不同寻址组合的指令代价
- 说明寄存器在模型中的地位与真实约束(调用约定保留的寄存器)
- 区分 RISC 与 CISC 对代码生成的不同影响
模型机长什么样
抽象掉具体芯片的细节,保留影响代码生成的骨架:
模型机指令(load 与 store 型访存): 载入 load r, addr ;内存 addr 的值进寄存器 r 存储 store addr, r ;r 的值进内存 addr 运算 op dst, src1, src2;寄存器间运算,结果进 dst 跳转 jmp / br 条件跳转 寻址方式: 直接寻址 变量名 ;load r1, price 代价 2 寄存器寻址 值已在寄存器 ;op r3, r1, r2 代价 1 变址寻址 基址加偏移 ;load r1, 8(rbp) 代价 2 立即数 常量直接编码 ;mov r1, 100 代价 1(小常量) 指令代价 = 1 + 访存次数 寄存器对寄存器的运算代价 1;带一次内存访问的指令代价 2 起步
代价公式粗糙(不建模流水线、缓存、分支预测),但作为选择指令的标尺足够好——代码生成的所有"挑便宜的"决策都以此为标尺。
同一语句的两份账单
主线语句 total = price + price 在模型机上按操作数位置不同有两种典型翻译:
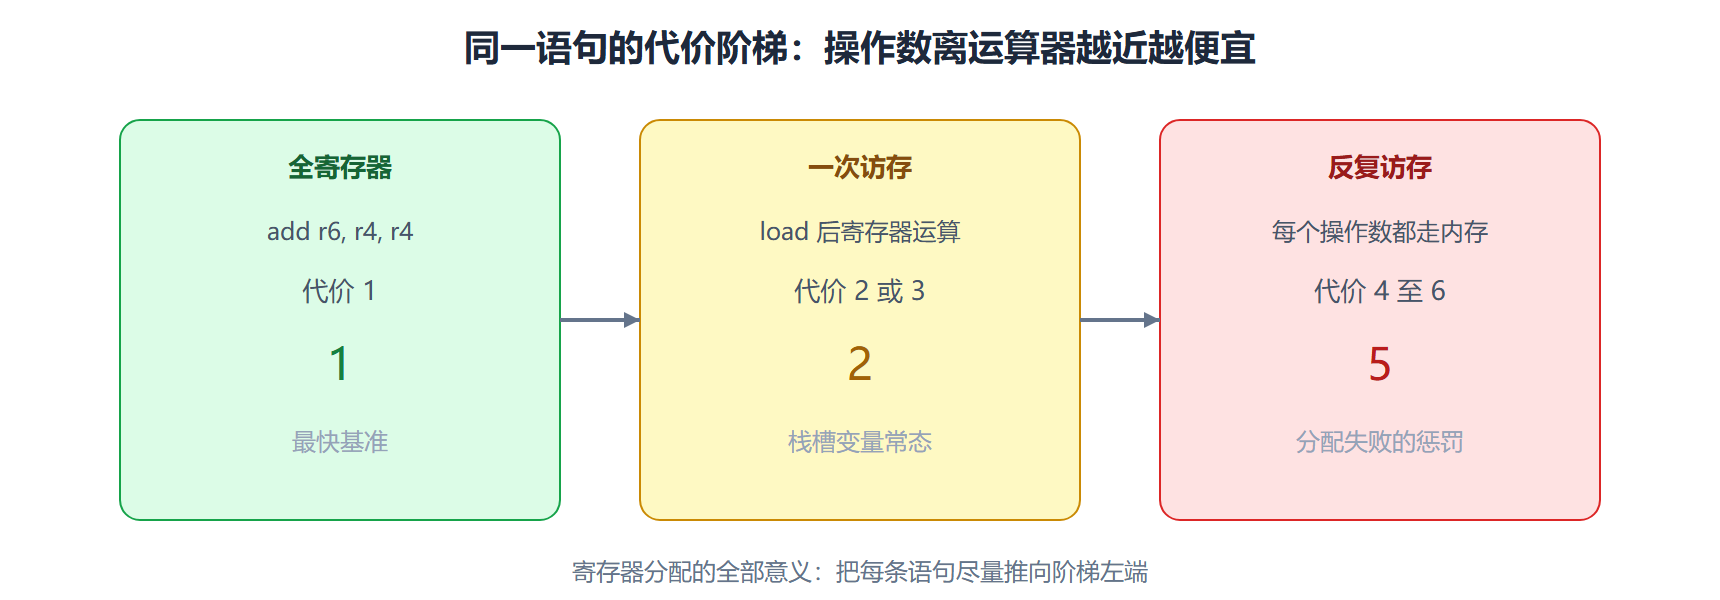
方案一:操作数走内存(load-store 风格) load r1, price 代价 2 add r2, r1, r1 代价 1 store total, r2 代价 2 合计 4 条指令,总代价 5 方案二:假设 price 已在寄存器 r4、total 在 r6(前序代码分好的) add r6, r4, r4 代价 1 合计 1 条指令,总代价 1
四倍代价差,全部来自操作数在寄存器还是在内存。这就是寄存器分配为什么是后端核心问题的定量理由——6.3 节的图着色就是在为"把更多方案二变成现实"而战。
图 寄存器与内存的代价阶梯
真实机器:RISC 与 CISC
模型机偏 RISC 风格(load-store 架构:只有载入存储指令碰内存)。真实世界的两端:
| 维度 | RISC(ARM、RISC-V) | CISC(x86) |
|---|---|---|
| 访存 | 仅 load/store | 多数指令可直接访存 |
| 指令长度 | 定长 | 变长(1 到 15 字节) |
| 指令选择 | 模板较固定 | 组合爆炸,技巧空间大 |
| 代价模型 | 接近 1 加访存 | 复杂(微码分解、融合) |
代码生成器面对 x86 时,"挑便宜指令"的空间更大(一条复杂指令顶三条简单指令),但代价估算更难准。工程现实是两种风格都要伺候——这也是抽象模型的价值:算法(树覆盖、图着色)在模型层设计好,落地时按指令集填表。
另一个绕不开的真实约束是调用约定:16 个(或 32 个)寄存器并非全部由编译器自由支配,前几个固定传参、某几个被调用方必须保留(调用后值不变)、栈指针帧指针神圣不可侵犯。寄存器分配器实际可用的"颜色数"是约定后剩下的额度。
⚠️ 常见坑:以为指令条数少就等于快。x86 上一条复杂指令可能在微架构里分解成多个微操作,反而比两条简单指令慢;代价公式只是初筛,真正定案靠目标机实测。编译器的启发式都建立在这层"初筛够用"的假设上。
💡 关键直觉:把模型机看成"代码生成的公倍数"——它足够像任何真机,使算法可以一次设计、多机复用;又足够简单,使代价可以手算。教学、原型、跨平台后端框架(如 LLVM 的 TableGen 描述目标机)都靠这层抽象吃饭。
模型与现实的落差
问:代价公式为什么不建模缓存与流水线? 建模代价太高。一条指令的真实延迟依赖流水线状态、缓存命中、前后指令的依赖关系——完整建模等于在编译器里内置一个模拟器。折中方案是分层建模:指令选择用粗粒度代价公式,指令调度用延迟表(近似流水线),最后靠运行时档案反馈修正。每一层都在精度与编译速度之间让步。
问:为什么寄存器数量不能多一点? 硬件成本与指令编码的矛盾。指令要编码寄存器编号,32 个寄存器占 5 位,64 个占 6 位,每条指令都多几位意味着代码密度下降。指令集历史上加寄存器的换代(x86-32 到 x86-64 的翻倍、RISC-V 的可选 32/128)都要同步改编码格式——寄存器数量是指令集设计里牵一发动全身的参数。
补一问:同一段代码在台式机与手机上代价差多少? 代价公式的形状相似,常数差得远:手机端访存延迟更高(内存带宽窄)、乱序窗口更小(并行机会少)、主频更低。同一段标量代码的绝对耗时差三到五倍很常见。跨平台性能工作第一步永远是换算代价模型的常数,而不是重学算法——模型通用、参数本地化。
再补一问:代价模型怎么验证准不准? 拿基准程序对拍:模型预测的代价排序与实测耗时的排序一致性高,模型就可用于排序决策。完全对齐不现实也没必要——指令选择只需要选对相对便宜的,不需要预测绝对周期数。这是所有编译器代价模型的共同定位:排序器,不是计时器。
记住这一定位,后两节的算法讨论里每次出现代价二字,指的都是这种排序意义上的相对便宜,而非绝对周期数的预测。顺带一提,同代不同款的芯片共享指令集但微架构参数各异,同一份二进制在不同款上的性能排序也可能不同——代价模型是每芯片一颗,编译器发行版里常见成组的参数文件就是这个原因。
本节要点回顾
- 模型机三件套:load-store 指令集、四类寻址、1 加访存的代价公式
- 代价阶梯:全寄存器 1、单访存 2、反复访存 5,寄存器分配的意义定量呈现
- 两种风格:RISC 模板固定、CISC 组合多,算法共用、表格各异
- 调用约定:寄存器额度被约定切走一块,可用颜色数先打折
- 标尺定位:代价公式是初筛工具,微架构真相靠实测
机器模型立好,下一节选指令:表达式树怎么覆盖成最便宜的机器指令组合。