6.2 指令选择:从IR到汇编
6.2 指令选择:从 IR 到汇编
本节摘要:指令选择把每条中间代码匹配到目标机的指令模式,树覆盖算法对表达式树自底向上打分,选出总代价最小的指令组合。本节用主线语句的表达式树走一遍覆盖过程,展示 ARM 与 x86 的两份汇编,最后讲窥孔优化——指令选完后的最后一道打磨。
阅读完本节,你应当能够:
- 把机器指令写成树模式,理解"覆盖即选择"
- 用动态规划为表达式树算出最小代价覆盖
- 写出同一 IR 在 ARM 与 x86 上的汇编并解释差异
- 列举窥孔优化的常见模式
指令是树的碎片
一条机器指令能计算的树形是固定的。把几条典型 ARM 指令画成树模式:
树模式(自底向上覆盖用): 模式 A:mov rd, rs 覆盖叶到叶的复制 代价 1 模式 B:ldr rd, addr 覆盖"内存取值"叶子 代价 2 模式 C:add rd, rs, rs 覆盖"加法,两操作数同名" 代价 1 模式 D:add rd, rs, imm 覆盖"加小常量" 代价 1 模式 E:基地址加偏移寻址 覆盖"加法嵌套取值" 代价 2 ldr rd, [rb, 偏移]
指令选择 = 用这些碎片不重不漏地盖满整棵表达式树,碎片总代价最小。这是标准的动态规划:每个节点记"以它为根的子树,用各模式覆盖的最小代价",自底向上填表,最后从根回溯取指令。
覆盖主线语句的树
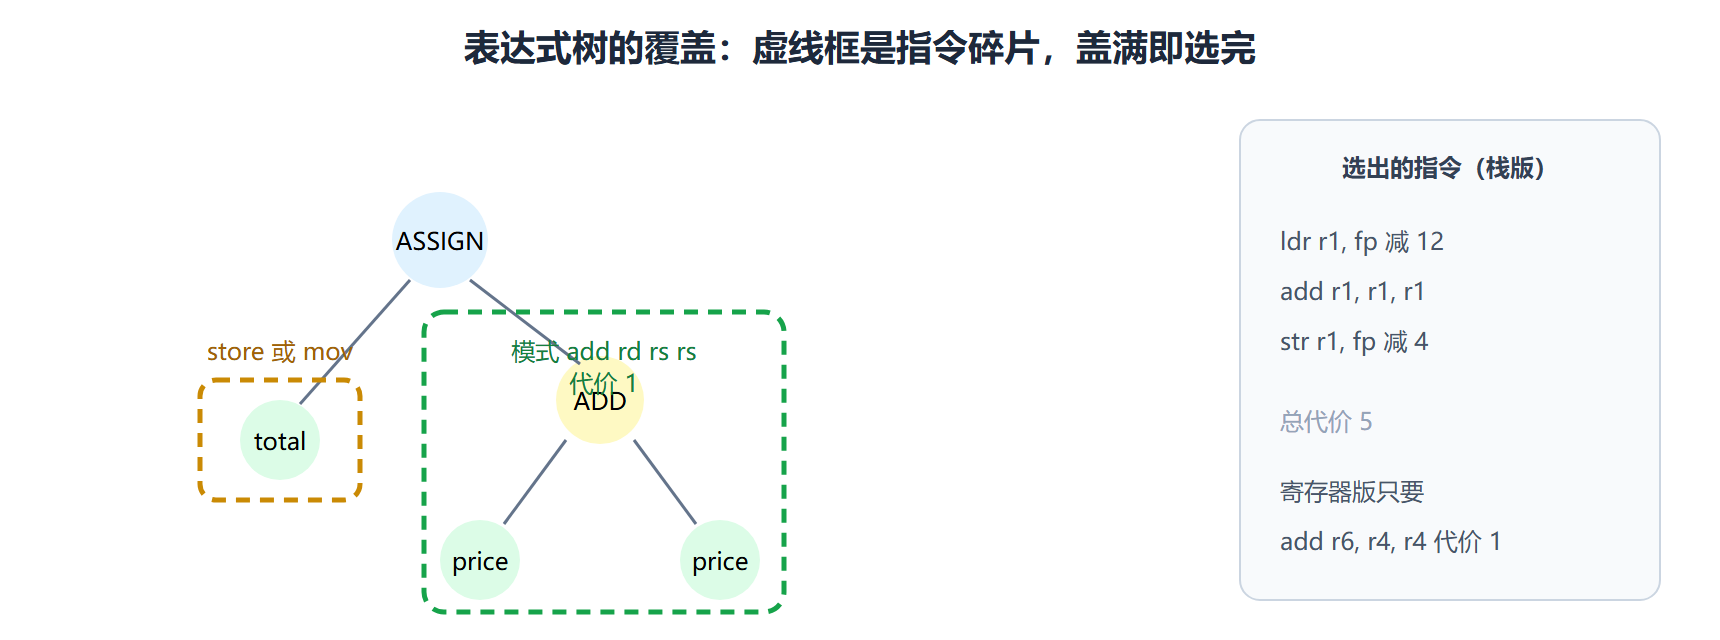
优化后的主线树是 total = price + price(加法两操作数同名)。覆盖打分过程:
树形: ASSIGN / \ total ADD / \ price price 叶子 total、price:模式 B(ldr)代价 2,或"已在寄存器"代价 0(假设前序分配) ADD 节点:模式 C(add rd, rs, rs)恰好覆盖"两操作数同源加法",代价 1 ASSIGN 节点:模式 store 代价 2,或寄存器间 mov 代价 1 最小覆盖(price 在 r4、total 在 r6 的分配前提下): add r6, r4, r4 代价 1,一条收工 无分配前提时(栈上变量,rbp 为帧基址): ldr r1, [rbp, 12] 取 price,代价 2 add r1, r1, r1 自加,代价 1 str r1, [rbp, 0] 存 total,代价 2 总代价 5 —— 与 6.1 节方案一吻合
同一条 IR 两份答案的差价再次说明:指令选择与寄存器分配互相纠缠。工业后端的流程是先按"理想寄存器假设"选指令,分配失败再回头改写。LLVM 的实现把这个动态规划做成了表驱动:目标机用表格描述指令模式与代价,选择器自动生成。
两台机器的两份汇编
同一 IR 落到两种指令集,风格差异立现:
IR:total = price + price(栈上变量版) ARM(RISC,load-store): ldr r1, [fp, #-12] ; 载入 price:只有 ldr 能访存 add r1, r1, r1 ; 三操作数,自加清晰 str r1, [fp, #-4] ; 存回 total x86-64(CISC,内存操作数): movsd xmm0, [rbp-24] ; price 是浮点,走 SSE 寄存器 addsd xmm0, xmm0 ; 浮点自加 movsd [rbp-8], xmm0 ; 存 total ;若整型版本:add dword [rbp-8], 直接内存累加,两条甚至一条 差异解读: 一、ARM 任何运算前必须先进寄存器,x86 运算可直接吃内存操作数 二、x86 浮点走专门的 xmm 寄存器族,与整型分家 三、x86 的"一条顶三条"机会多,但代价估算更依赖微架构
窥孔优化:最后一道打磨
指令选定后,对生成结果做滑动窗口式的局部替换,叫窥孔优化。窗口里看到已知的低效模式就换掉:
模式一 冗余载入存储: str r1, [fp-4] ldr r2, [fp-4] ← 刚存就取,换成 mov r2, r1 模式二 冗余传送: mov r2, r1 mov r3, r2 ← 链式搬运,换成 mov r3, r1 模式三 无用跳转: jmp L1 L1: ... ← 跳到下一行,直接删 模式四 强度机会: mul r1, r2, 8 ← 乘 2 的幂,换 lsl r1, r2, 3(左移 3 位) 模式五 简单代数: add r1, r1, 0 ← 加零,删 sub r1, r1, 0 ← 同上
窥孔的窗口通常只有几条指令宽,规则表驱、实现便宜,是老式编译器与汇编器(优化汇编输出的汇编器选项)的主力,也是现代编译器在指令选择之后的收尾清洁工。
图 树覆盖:碎片盖满表达式树
⚠️ 常见坑:以为指令选择只看单条指令代价。模式之间的衔接同样花钱——选了"值留在内存"的模式,下一条指令就得补一次载入。树覆盖的动态规划之所以对整棵树打分,就是要让"碎片拼起来的总账"最小,局部贪心可能拼出全局次优。
💡 关键直觉:把指令选择想成贴瓷砖——每条机器指令是一块固定形状的瓷砖,表达式树是待贴的墙面,动态规划保证瓷砖总造价最小。指令集越复杂(x86),瓷砖形状越多,贴法越灵活,也越依赖描述表格的完备性。
选指令的实战问答
问:为什么同一份代码不同编译器产出的汇编差别很大? 指令模式的描述完备度、代价估算口径、窥孔规则表都不同。x86 一条复杂指令可顶三条简单指令,选不选它取决于描述表里有没有这条模式;同档位下汇编行数差两三成很常见。读汇编做优化时先确认编译器与版本,是基本功。
问:反编译是不是指令选择的逆操作? 形似而质不同。反编译从机器码猜高级结构(循环、类型),是模式识别问题,答案不唯一;指令选择从结构化 IR 挑指令,是覆盖优化问题,有明确的最优目标。方向相反、难度悬殊——这也是为什么发布版二进制还能被逆向,却几乎不可能还原出原始源码。
补一问:窥孔优化会不会和指令选择打架? 偶尔会。窥孔删掉一条指令后,相邻指令的最优选择可能改变(原本因下一条指令而保留的加载变得可删)。处理办法是迭代到不动点(窥完再窥),或把高频窥孔模式前移进指令选择的覆盖规则。两道工序的边界一直在微调,这正是后端流水线分 pass 的艺术。
本节要点回顾
- 模式即碎片:每条指令覆盖固定树形,覆盖满即选择完
- 动态规划打分:每节点记各模式最小代价,根回溯取指令
- 两机对照:ARM 先载后算三步走,x86 内存操作数可一条吃下
- 纠缠关系:理想寄存器先选、分配失败回头改写,是工业标准流程
- 窥孔收尾:冗余存取、链式传送、无用跳转、乘法换移位,便宜的大扫除
指令选定,下一章前先把变量安顿好:图着色寄存器分配,主线语句的最后一道后端工序。