8.1 过程间分析与优化
8.1 过程间分析与优化
本节摘要:过程间优化把视野从函数扩大到整个程序的调用图:内联展开消掉调用开销并暴露跨函数的优化机会,跨过程常量传播让"藏在别处的常量"显形,别名分析回答"两个名字是否指向同一内存"这个一切优化的前置难题。本节逐个拆解三件工具的机理与代价,并说明链接时优化如何让它们落地。
阅读完本节,你应当能够:
- 估算一次内联的收益与代价,说明深度内联的膨胀风险
- 解释跨过程常量传播为何需要全程序调用图支撑
- 描述别名分析的问题、难点与保守解
- 说明 LTO 的工作方式与构建流程的改变
视野升级:从函数到程序
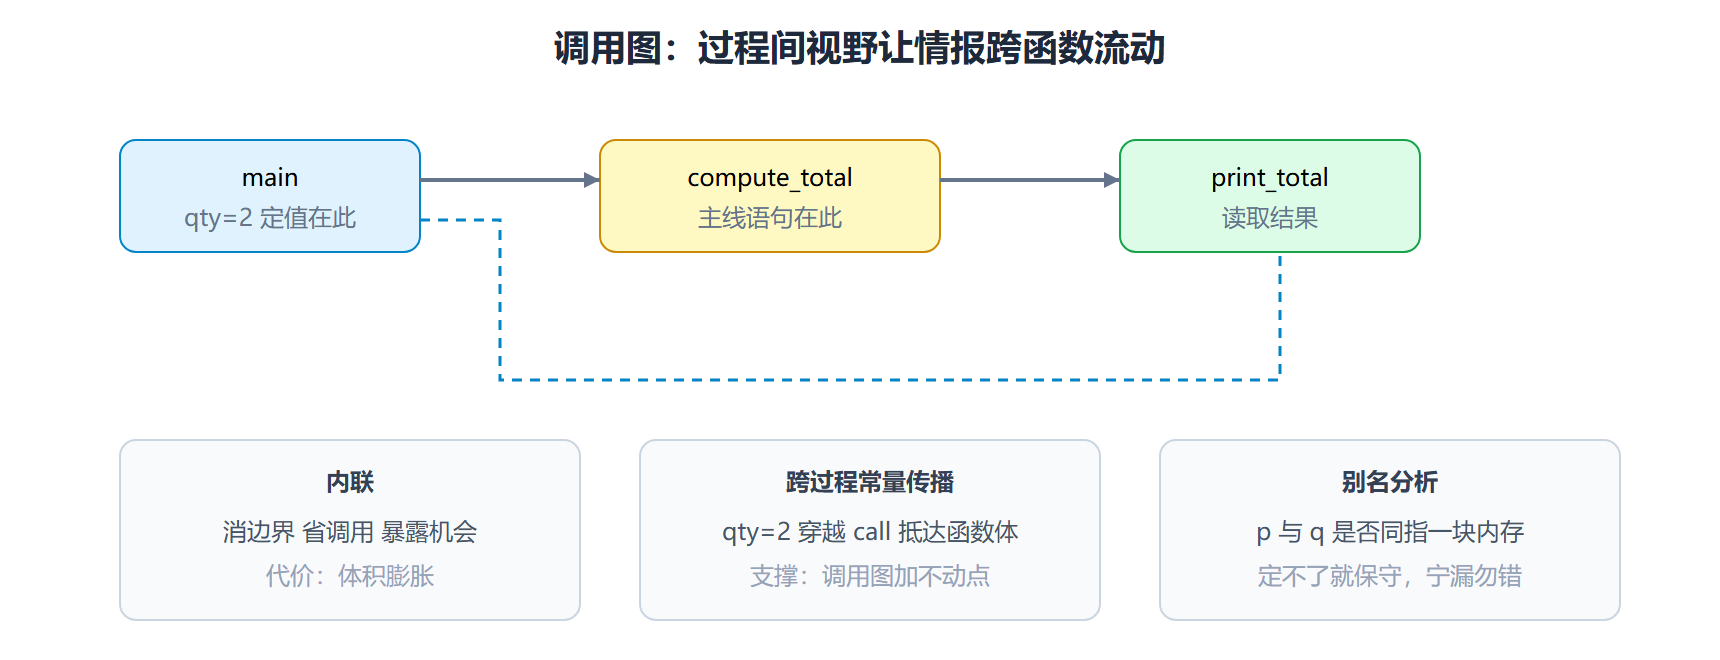
第 5 章的所有优化都困在函数边界内:compute_total(price, qty) 被调用时,函数体里的乘法拿不到"qty 恒为 2"这个事实——它藏在调用方。过程间分析把调用图画出来(谁调用谁、以什么参数),信息就能跨边界流动。三件主工具:内联消边界、常量传播送情报、别名分析排地雷。
内联:最暴力也最有效的一招
内联把函数体复制到调用点。收益有两层,明层是省掉调用开销(搭帧拆帧、传参、跳转,通常几十个周期);暗层更重要——边界消失后,函数内的优化器突然看见了调用点的常量与上下文,第 5 章的全套手术可以对展开后的代码再来一遍。
内联前: r0 = qty ;传参 r1 = price bl compute_total ;调用开销 ...函数体:load 载入、运算、返回... 内联后(qty=2 已知): t = price + price ;常量折叠直接算完——调用、传参、帧全没了 收益公式(粗略): 每次调用省 C 调用开销 加 展开后新增优化收益 代价:函数体每复制一份,代码体积涨一份 体积膨胀不是美学问题:指令缓存命中率下降,可能反向拖慢整个程序
深度内联的连锁反应值得警惕:A 内联进 B、B 内联进 C,指数级的体积增长。工业编译器的对策是给每个函数设内联预算(按函数大小、调用频次、是否循环内打分),贪心地_inline 高性价比调用,并设全局膨胀上限。
跨过程常量传播
主线语句在跨过程视野下的变化最能说明问题:
主程序里:qty = 2; discount = 0.0; ← 常量在这里定值 compute_total 内部:total = price * qty - discount; 函数内优化器视角:qty、discount 是参数,不知道值 → 只能生成通用乘法减法 全程序分析器视角:追踪 qty 的定值穿过调用边界——所有调用点都传 2 → qty 在函数内等效常量,第 5 章的折叠削弱全套生效 → 最终目标码:total = price + price,与第 5 章殊途同归
支撑它的是全程序调用图加"参数取值集合"的数据流求解——迭代到不动点后,每个形参的候选值集合收缩,单元素集合即常量。代价是编译期要装载全程序信息,这正是下一节 LTO 存在的理由。
别名分析:绕不开的前置难题
一切内存优化的天问:p 和 q 指向同一块内存吗? 若可能指向(别名),通过 p 的写会打乱通过 q 的读,一半的优化(重排、缓存值于寄存器、删除冗余载入)都要停手。指针的别名关系在编译期极难精确判定:
void f(int *p, int *q) { *p = 1; *q = 2; ← 若 p 与 q 别名,这行会覆盖上面的写 x = *p; ← 此处读 1 还是 2?取决于别名关系 } 调用 f(a, a) 与 f(a, b) 两种现场,函数体必须兼容两者
别名分析的解法光谱:流不敏感分析(全程只回答一次,快而粗)、流敏感分析(逐程序点回答,慢而准)、指针分析(追踪指针可能指向的集合,介于两者)。C 家族还有语言层的救兵:restrict 关键字显式声明"无别名",编译器据此放开手脚——把程序员的常识变成优化器的证据。Java 与 Go 靠类型系统(无指针算术)让别名分析天然更容易,这是语言设计给编译器的礼物。
图 调用图上的信息流动与三件工具
LTO:让过程间优化落地
传统构建流程每个源文件独立编译成目标文件,过程间信息在文件边界处蒸发。链接时优化的方案:编译器把中间表示(而非机器码)存进目标文件的专用段,链接器收齐全部 IR 后再统一优化、统一生成机器码——跨文件的过程间分析由此成为可能。工程上的代价:链接期变慢、内存占用大、构建缓存策略要重新设计;收益:跨模块内联与常量传播常常带来两位数百分比的性能提升,各大编译器与主流大型项目已默认开启。
⚠️ 常见坑:以为内联只是"快一点的函数调用"。内联的最大价值是暴露跨边界优化机会——单纯省调用开销的场景(大函数、冷函数)内联常常得不偿失;判断标准是"展开后能触发多少新优化",而不是"调用省了几拍"。
💡 关键直觉:过程间优化的本质是信息经济学——函数边界既是工程上的防火墙,也是优化上的信息壁垒。内联拆墙、常量传播递情报、别名分析排雷,三件事合起来就是"在程序全局做第 5 章做过的事"。
全程序视野的边界
问:动态链接会不会破坏过程间分析? 会。共享库在运行时才绑定,编译期看不到库函数体,只能按接口约定处理——内联库函数、对库代码常量传播都做不到。部分对策是链接时优化覆盖静态链接部分,或运行时(即时编译)在加载后补做。分析视野的边界始终等于可见代码的边界,动态性每前进一步,静态视野就退一步。
问:内联是不是永远值得? 有一个常被忽视的反例:被内联进热循环的函数体如果包含异常路径或很少走到的分支,体积膨胀会稀释指令缓存的密度。现代编译器用内联预算加调用点评级控制,语言侧(显式内联提示)只能建议不能命令——编译器保留否决权,因为它看得到调用者,写代码的人看不到全部调用者。
本节要点回顾
- 视野升级:调用图让常量、上下文跨函数流动
- 内联双层收益:省调用是明层,暴露优化机会是暗层;膨胀要设预算
- 跨过程常量:形参取值集合收缩到单元素即常量,需全程序分析
- 别名分析:一切内存优化的前置天问,语言设计(restrict、无指针算术)能救场
- LTO:IR 进目标文件、链接期统一优化,默认开启已成趋势
视野扩到全程序了,下一节转向宽度:多核与向量单元的并行红利,编译器怎么帮你拿。