8.2 并行编译
8.2 并行编译
本节摘要:"并行编译"一词有两义:编译器为并行硬件产出并行代码(自动向量化、指令级并行),以及编译过程本身的并行化(并行构建、分布式缓存)。本节两条线都走:SIMD 向量化的安全条件与收益模型、超标量处理器上的指令调度,再到构建系统的依赖图并行、模块化与编译缓存——大项目把编译时间从小时压到分钟的全部手段。
阅读完本节,你应当能够:
- 说明 SIMD 向量化的工作模型与安全条件
- 判断一段循环可否向量化,找出阻碍因素
- 解释超标量乱序执行下编译器指令调度的角色
- 描述并行构建的依赖图原理与分布式缓存的命中条件
目标侧:向量化,一条指令的批发价
现代 CPU 的 SIMD 单元一条指令能同时处理 4 到 16 个数据(256 位宽的寄存器装 8 个 32 位浮点)。主线语句若是数组版,收益立现:
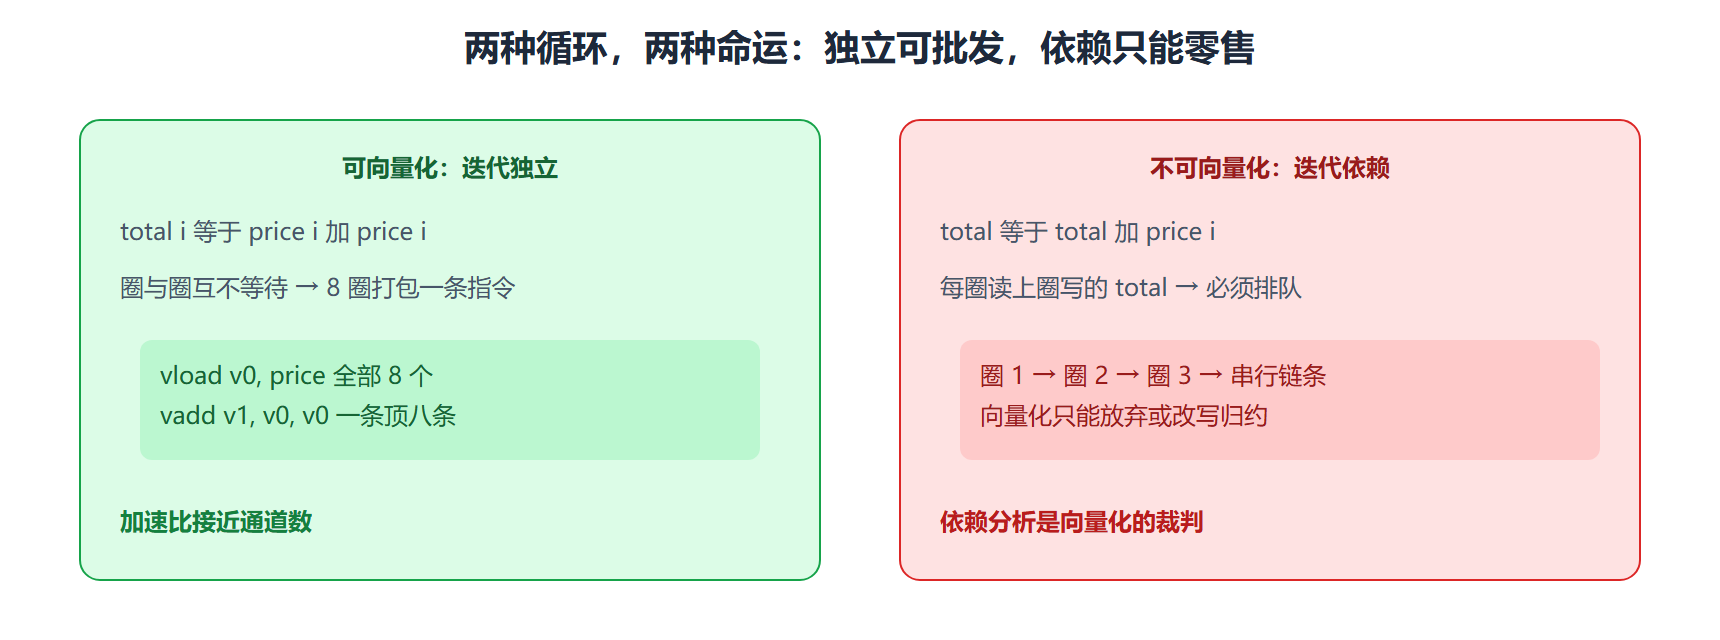
标量版循环: for i in 0..7: total[i] = price[i] + price[i] ;8 次加法,8 条指令 向量化版(8 路同时): vload v0, price[0..7] ;一次载 8 个浮点 vadd.f32 v1, v0, v0 ;一条指令 8 个加法同时算 vstore total[0..7], v1 ;一次存 8 个 3 条指令完成 8 条语句的活——理论加速接近 8 倍
向量化不是白拿的,安全条件有三:循环迭代彼此独立(total[i] 的写不能影响 total[i+1] 的读,数据依赖检查)、内存区域不重叠(又见别名分析——price 与 total 若可能别名,只能保守放弃或插运行时检查)、控制流平坦(循环内到处分支的代码向量化的收益打折)。编译器对循环做依赖分析,逐条验证;满足不了就部分向量化或放弃。主线语句的累加版 total = total + price[i] 因迭代间有依赖(每圈读上圈写的 total),是向量化的经典反例——要改成"归约"模式(分块累加再合并)才能并行。
图 向量化:数据依赖决定能否批发
目标侧:指令级并行与调度
即使不写向量指令,超标量 CPU 每拍也能发射多条标量指令,乱序执行窗口内自动找并行。编译器能帮的忙是指令调度:在不改变依赖关系的前提下重排指令,把互不依赖的运算填进同一拍、把载入尽早发出以隐藏访存延迟(第 5 章的循环优化"展开"正是为调度创造更多可搬动的指令)。这条线与第 6 章的代价模型直接衔接——真实芯片的发射端口、延迟表成为调度器的输入数据。
工具侧:并行构建
编译目标并行了,编译过程本身也得并行——大项目全量构建动辄以小时计。三板斧:
依赖图并行。构建单元(源文件到目标文件)之间天然独立,头文件依赖连成有向无环图,调度器按拓扑序并行调度。ninja 与 make 的 j 参数干的就是这件事,八核机器上接近八倍加速。
构建依赖图(示意): utils.o ← utils.c + common.h lexer.o ← lexer.c + common.h ← 三者互不依赖,可同时编 parser.o ← parser.c + tree.h app 链接 ← 上面全部 ← 必须等齐 调度:8 核同时编 3 个,全完成后链接
模块化。C 与 C++ 的头文件机制让一个公共头的改动触发全量重编。模块(C++20 modules、Rust 的 crate)把接口编译成预处理的二进制中间产物,依赖变更的爆炸半径大幅缩小——这是语言设计层面对构建并行性的支援。
分布式与缓存。编译结果按"源码、编译器版本、参数、依赖哈希"作键缓存,命中即免编——同一份代码在持续集成集群里第二次构建几乎零成本。分布式编译再把单个目标的编译分发到集群几十台机器。三者叠加,大型项目把小时级全量构建压到分钟级。
| 手段 | 作用点 | 加速来源 |
|---|---|---|
| 依赖图并行 | 单机多核 | 独立构建单元同时跑 |
| 模块化 | 依赖传播 | 缩小重编译半径 |
| 编译缓存 | 重复构建 | 哈希命中直接复用 |
| 分布式编译 | 集群 | 机器数量线性堆叠 |
⚠️ 常见坑:向量化收益被内存带宽吃光。计算密集的循环向量化后速度翻倍,访存密集的循环向量化后纹丝不动——瓶颈在数据搬运不在运算时,再多运算通道也无济于事。性能优化先看瓶颈类型,再谈并行手段。
💡 关键直觉:两个"并行"是同一枚硬币——编译器产出并行代码,是在替程序员利用硬件的并行;构建系统并行编译,是在替团队利用机器集群的并行。判断两者时问同一句话:哪里有"互不依赖的工作单元",哪里就有并行的红利。
并行红利的边界
问:为什么不能自动把所有循环向量化? 三个拦路虎:迭代间依赖(前一圈的结果喂后一圈)、别名不确定性(两个数组可能重叠,编译器不敢打包)、控制流复杂(循环里到处分支,打包需要掩码,收益归零)。依赖可以靠归约改写,别名可以用运行时检查兜底,分支只能重写代码——最后一个只能靠人,这就是向量化指导指令(提示编译器无依赖)存在的原因。
问:构建并行度拉满还是慢,瓶颈在哪? 三个常见卡点:依赖链上的巨型翻译单元(一个上万行的头文件衍生品,独占一个核几十分钟)、链接这个串行终点(所有目标文件到齐才能开工)、磁盘与缓存的带宽争抢。前两个靠模块化拆解,第三个靠分布式缓存分流——三板斧之外没有银弹,构建提速永远是工程活。
补一问:GPU 上的并行编译和本节讲的一样吗? 模型不同。GPU 是众核单指令多数据的 extreme:数千线程按组执行,向量化思想被放大成整个编程模型(内核函数、线程网格),编译器的工作从挑指令变成排布线程与访存合并。本节的依赖分析与别名检查仍是地基——数据不依赖才能并行,这条判据从 CPU 到 GPU 从未变过。
本节要点回顾
- 向量化:SIMD 一条指令批发多个数据,安全条件是迭代独立与无别名
- 依赖裁判:迭代间数据依赖决定能否批发,归约需改写后才能并行
- 指令调度:乱序硬件之上的软件重排,展开为调度创造空间
- 构建三板斧:依赖图并行、模块化缩小重编半径、缓存与分布式叠加
- 瓶颈意识:计算密集才吃向量红利,访存密集先解决数据搬运
硬件与工具的并行讲完,最后一节把编译搬到运行时:JIT 如何用运行时信息做出静态编译器做不到的优化。