4.2 文件IO
4.2 文件 I/O
文件操作只有一个主推姿势:
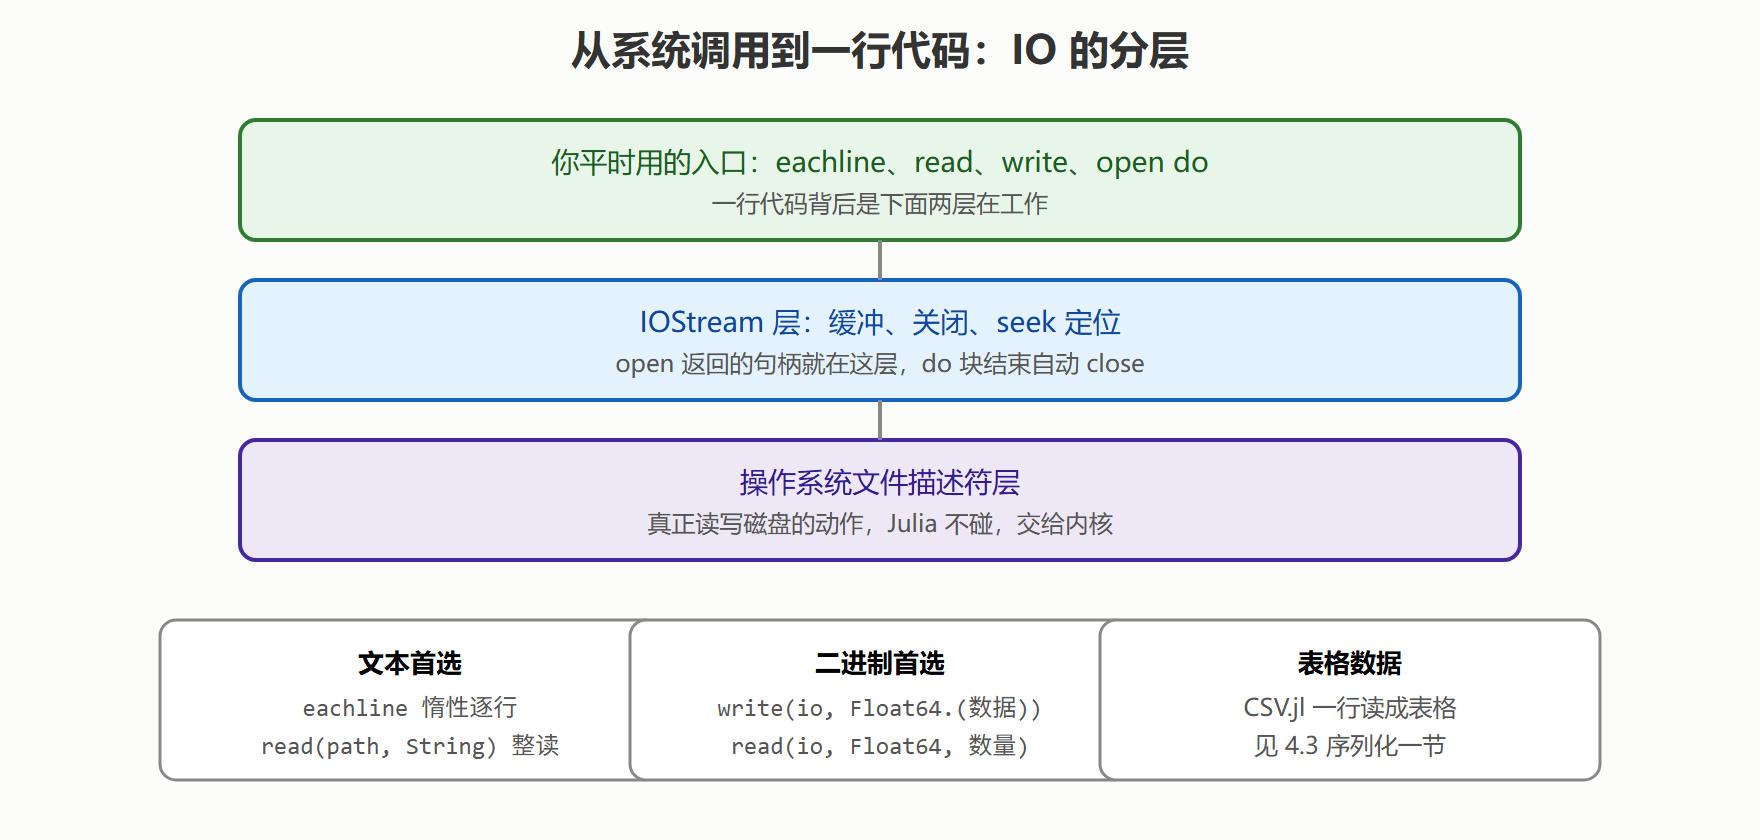
open(路径, 模式) do io ... end,用完自动关闭。其余按数据形态选:逐行读用eachline,整块读用read,二进制用write/read配类型。
文本读写实战
写一个文件、再读回来,完整跑一遍:
# 写:注意 "w" 模式会覆盖已存在文件 open("notes.txt", "w") do io println(io, "第一行:实验参数 alpha=0.01") println(io, "第二行:迭代 1000 次") end # 逐行读(惰性,内存友好) for (i, line) in enumerate(eachline("notes.txt")) println("第 $i 行 → $line") end # 一次性读成字符串 content = read("notes.txt", String)
追加写用 "a" 模式——日志类文件的标准选择:
open("run.log", "a") do io println(io, "run at $(now())") end
IO 抽象层次与常用入口
二进制读写:存一个大数组
数值数组直接按字节落盘,速度最快、体积最小:
data = rand(10^6) open("data.bin", "w") do io write(io, length(data)) # 先写长度,读回时才知道读多少 write(io, data) # 数组按内存布局整体写出 end open("data.bin") do io n = read(io, Int) # 按写入顺序读回 v = read!(io, Vector{Float64}(undef, n)) end
💡 关键直觉:
write/read!走的是裸字节,没有元数据。谁写谁负责记录形状与类型——这也是为什么真实项目更常用 4.3 的 JLD2:它把类型信息一起存了。
目录与路径操作
readdir("some_dir") # 列目录 mkdir("results") # 新建目录 ispath("results") # 存在性检查 mv("a.txt", "b.txt") # 移动或重命名 rm("b.txt") # 删除文件;删目录加 force=true joinpath("results", "run1") # 跨平台拼路径,别手写斜杠
⚠️ 常见坑:Windows 与类 Unix 路径分隔符不同,手工拼
"/"会在 Windows 上出诡异问题。永远用joinpath,或写原生字符串raw"C:\data"避免反斜杠转义。
案例:解析一个不规范的真实日志
背景:仪器导出的日志格式常有杂质——空行、注释行、逗号空格混用。手工解析正是文件 IO 的主场。样本长这样:每行"时间,数值",夹杂以 # 开头的注释。第一步,写解析器:
function parse_log(path) rows = Tuple{Float64,Float64}[] # 结果容器,类型具体 for line in eachline(path) s = strip(line) # 去首尾空白 (isempty(s) || startswith(s, "#")) && continue # 跳过空行与注释 parts = split(s, ",") t = tryparse(Float64, strip(parts[1])) v = tryparse(Float64, strip(parts[2])) (isnothing(t) || isnothing(v)) && continue # 坏行跳过并计数更佳 push!(rows, (t, v)) end rows end rows = parse_log("sensor.log") length(rows) # 有效数据行数
解读这段代码的防御层次:strip 处理行尾空白,tryparse 把"转不成数字"从异常降级为 nothing,两道 continue 保证任何脏行都只被跳过而不炸掉整趟解析。变式:把 continue 换成收集坏行号到数组,最后打印报告,就成了一个可以交给运维的日志体检工具——从"能读"到"能诊断",中间只差一个记录动作。
大文件逐块处理的边界情况
几 GB 的日志一次 read 进内存会直接顶爆。三个对策按优先级排:首选 eachline,它是惰性迭代器,任意大的文件内存占用恒定;其次 open 拿到流后 read(io, n) 手动分块,适合定长二进制记录;最后才是 mmap(内存映射),把文件映射进地址空间按数组访问,适合"频繁随机访问局部区域"的场景。一个经验数字感:逐行处理一千万行日志,eachline 循环体保持类型稳定的话,整个任务几十秒、内存不到百兆——性能瓶颈从来不在 IO 抽象本身,而在循环体里每次迭代做了多少分配。
另一个边界是权限与容错:目标文件被别的进程占用时 open 抛 IOError,脚本批量处理文件时把 open 包进 try/catch、记下失败路径继续跑,比让整个批任务停在第三个文件上有用得多。
概念辨析:文本模式与二进制模式的本质差异
同是 read,按 String 读与按字节数组读走的是两条路。文本读法假设内容是某种编码的字符序列,按行切分、可以做 strip/split 等字符级操作;二进制读法拿到的是 Vector{UInt8},一切结构靠你按偏移量解释——本节开头的 data.bin 例子就是"先写 8 字节的长度、再写裸数据"的自定义协议。两者之间可以互转:String(copy(bytes)) 把字节按 UTF-8 解释成文本(不 copy 会共享底层,谨慎原地修改)。选哪种的判断标准只有一条:文件是人类写的还是程序写的。人类写的必然是文本,程序写的高性能中间数据必然选二进制,混合场景(如日志头部带元信息)则文本头加二进制体,用 position 与 seek 在流里跳着读。
本节要点回顾
open ... do自动关闭,忘掉手动close的写法;eachline惰性逐行,大日志文件不爆内存;- 二进制
write/read!最快,但要自己记录元数据; - 路径操作用
joinpath,跨平台零烦恼; - 覆盖用
"w"、追加用"a",动手前想清楚。