4.3 数据序列化与反序列化
4.3 数据序列化与反序列化
序列化方案选型一句话:给 Julia 自己用选 JLD2,给人类和 Excel 用选 CSV,跟其他系统交换选 JSON。选错方向的代价是精度、类型或可读性三者丢其一。
JLD2:Julia 世界的存盘标准
任意 Julia 对象(包括自定义 struct)连类型一起存,读回来即用:
] add JLD2 using JLD2 struct Params lr::Float64 epochs::Int end p = Params(0.01, 100) results = (loss=[0.9, 0.4, 0.2], acc=[0.6, 0.8, 0.91]) @save "run01.jld2" p results # 一行存多个变量 @load "run01.jld2" p results # 按名读回,类型完整复原
CSV:面向人和表格软件
] add CSV DataFrames using CSV, DataFrames df = DataFrame(a=1:3, b=["x", "y", "z"]) CSV.write("table.csv", df) df2 = CSV.read("table.csv", DataFrame)
CSV 是文本,人类可读、任何工具能开,但它没有类型元数据——整数可能被猜成浮点,日期要手动指定格式。
JSON:面向系统交换
] add JSON3 using JSON3 config = Dict("name" => "exp1", "params" => [0.1, 0.2]) str = JSON3.write(config) back = JSON3.read(str, Dict{String, Any})
存盘方案选型矩阵
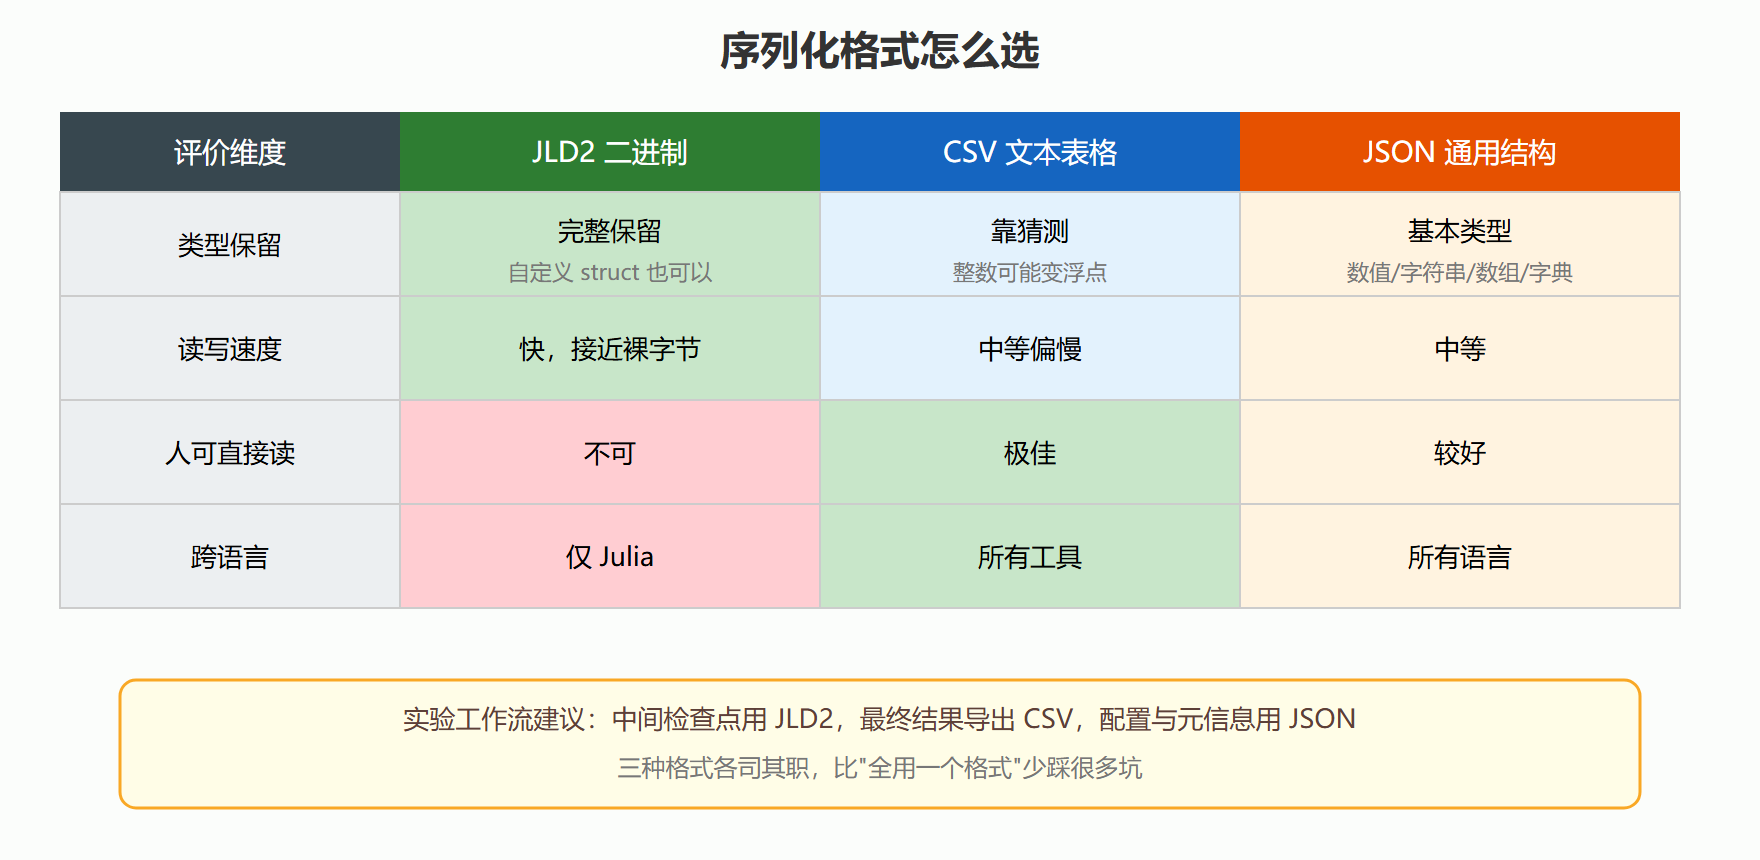
动手:一个完整的检查点方案
把"训练中断可续跑"的存取逻辑写成一个函数对:
function save_checkpoint(path, iter, params, loss_hist) jldopen(path, "w") do f f["iter"] = iter f["params"] = params f["loss_hist"] = loss_hist end end function load_checkpoint(path) jldopen(path, "r") do f (iter=f["iter"], params=f["params"], loss_hist=f["loss_hist"]) end end # 用法:每 100 轮存一次 save_checkpoint("ckpt.jld2", 300, rand(10), [2.0, 1.5, 1.1]) state = load_checkpoint("ckpt.jld2") state.iter # 300
jldopen 的 f["键"] 语法让你按需读取大文件里的单个变量,几十 G 的存档也不必整体加载。
⚠️ 常见坑:JLD2 文件跟 Julia 大版本相关度低但跟 struct 定义相关度高——改了字段名再读旧文件会报错。存档里附带一个版本号键是便宜保险。
案例:一次"读不回来"的事故复盘
背景:一个跑了两天的参数扫描,结果全部用 CSV 存盘,读回来后发现 Bool 列变成字符串、日期变成 Missing,部分数值精度还被表格软件自动四舍五入。复盘根因:CSV 没有类型元数据,一切靠读取侧"猜"。操作层面的修复分两步。第一步,重跑前先把输出改为 JLD2 为主、CSV 为辅:
# 主档:JLD2 保真存全部类型 @save "sweep.jld2" grid results flags # 副档:CSV 只给人看,明确声明列类型防止误猜 using CSV, DataFrames tbl = DataFrame(param=grid, best=minimum(results; dims=1)[1, :]) CSV.write("sweep_summary.csv", tbl; delim=',')
第二步,读回时显式指定类型,不再依赖自动推断:
df = CSV.read("sweep_summary.csv", DataFrame; types = Dict(:param => Float64, :best => Float64))
结果解读:JLD2 读回的 flags 仍是 Vector{Bool},一行转换代码都不用写;CSV 只要还有人类读者就继续产,但定位降为"报表"。变式:如果结果要交给 Python 同事的流水线,主档可以再加一份 JSON3 输出,三格式各服务一个受众——事故的教训不是"CSV 不能用",而是"保真与可读是两种需求,别让一个文件同时扛"。
序列化的性能边界
体积与速度的量级感值得建立:一千万个 Float64 的数组,JLD2 落盘约 80MB、秒级完成;CSV 同样数据膨胀到两百多 MB(十进制文本更占空间)且慢一个数量级;JSON 再慢一截。所以"每轮迭代都存 CSV"是常见的隐性性能坑,改成 JLD2、收工时再导出 CSV 报表,是零成本的结构优化。另一个边界是跨版本:JLD2 对 struct 改名的容忍度低,重要长期存档在文件里塞一个 schema_version 键,读取时先检查版本再决定走新逻辑还是旧逻辑,这个模式在本节检查点代码上只需三行就能补上。
常见错误与排错
JLD2 读档报"类型未定义":文件里存了自定义 struct,读档会话里没有这个定义,先 include 或 using 定义它的模块再 @load。JSON3 读回键找不到:JSON3.read(str) 默认返回只读的 JSON 对象而非字典,用 JSON3.read(str, Dict{String,Any}) 指定目标类型即可像普通字典一样取键。CSV 列类型猜错:整列数字里混了一个 "N/A",整列被当成字符串读入,用 types 参数显式声明、并配 missingstrings=["N/A"] 把占位符归一为 missing。这三类报错的共性是"格式边界没对齐"——序列化永远是写读双方的一场约定,约定没写明的部分,读取侧只能猜。
本节要点回顾
- JLD2 存 Julia 中间结果:类型完整、速度快、按键随机读;
- CSV 面向人与表格:可读但类型靠猜;
- JSON 面向系统交换:通用但表达不了任意对象;
- 检查点模式:
jldopen+ 版本号键,可续跑的工程标配。