5.1 并行计算基础
5.1 并行计算基础
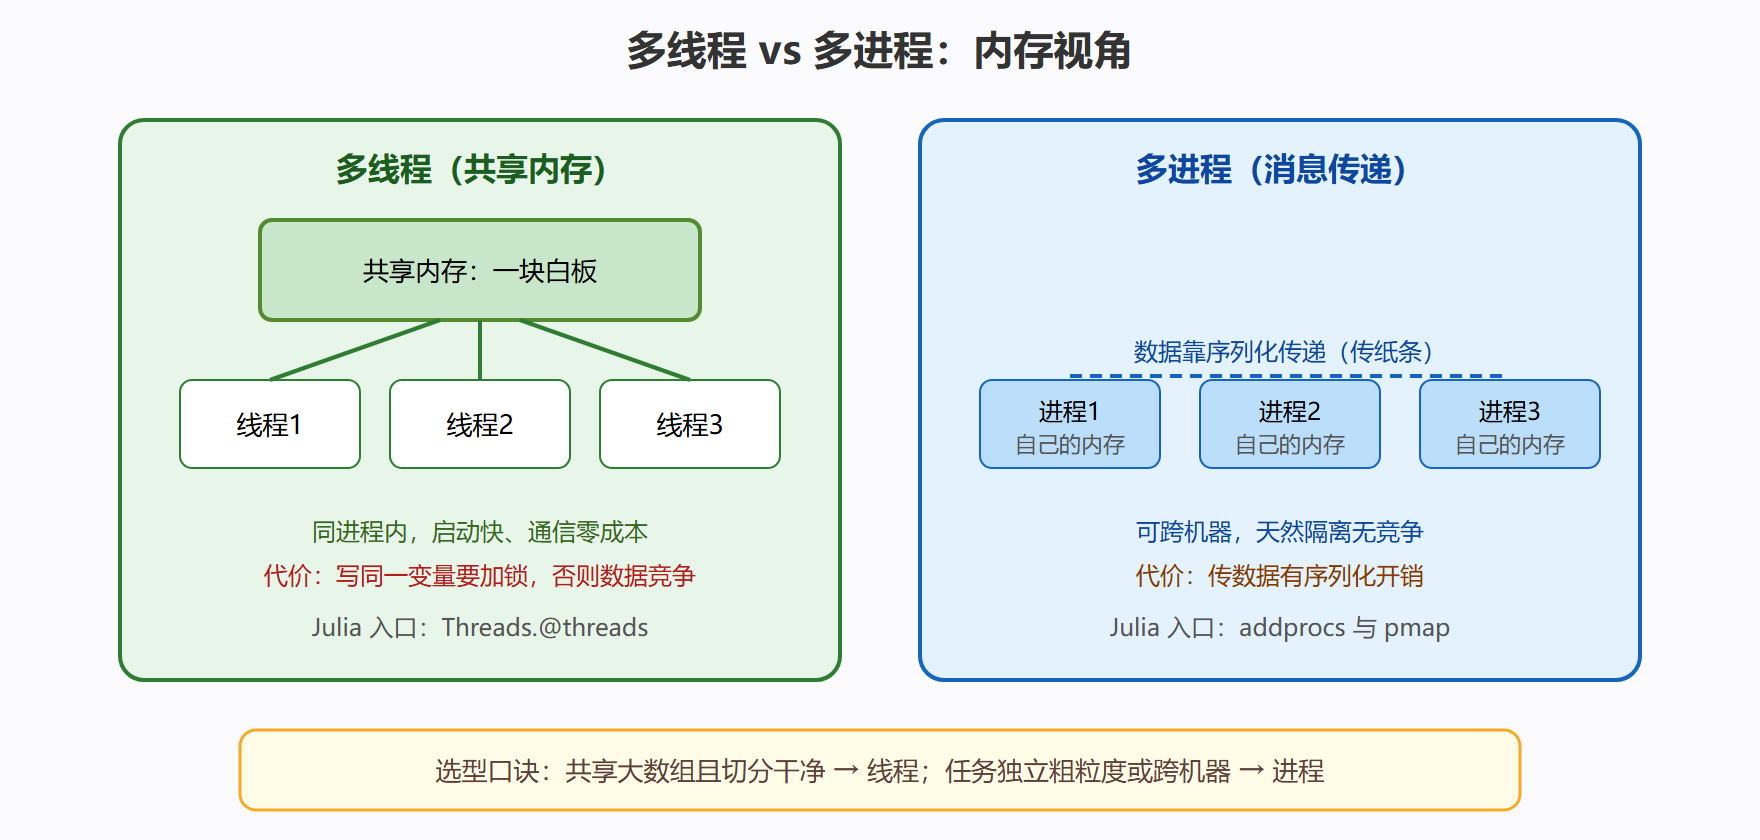
并行只有两种基本形态:多线程共享内存(同一屋檐下抢一块白板)与多进程消息传递(各自有白板,靠传纸条协作)。Julia 两种都原生支持,选型取决于任务切分后要不要频繁共享数据。
先感受加速:一个蒙卡特罗求 π
function mc_pi(n) hits = 0 for _ in 1:n x, y = rand(), rand() hits += (x^2 + y^2 <= 1) end 4 * hits / n end @time mc_pi(10^8) # 单核版,先跑一次编译,再跑一次计时
这是"完美可并行"的任务:每次抽样互不依赖。现在看两种并行形态分别怎么接手。
两种并行模型的结构差异
加速从哪来:阿姆达尔定律
程序里不可并行的部分会卡死加速上限。设串行部分占 20%,哪怕核数无穷:
# 加速上限 = 1 / (串行占比 + 并行占比/核数) speedup(n) = 1 / (0.2 + 0.8 / n) speedup(4) # 2.5 speedup(16) # 3.6 speedup(10^6) # 5.0 —— 上限 5 倍,不是 100 万倍
动手改上面的公式里的串行占比,感受一下:串行占 5% 时 16 核能到 10 倍;占 30% 时 16 核只有 3.5 倍。先压缩串行段,再买核数。
⚠️ 常见坑:数据竞争不报错,只给错答案。多线程累加一个普通变量是教科书级错误,正确做法见 5.2 的任务分片方案。
进程与线程:概念落到操作系统层面
把两种形态的差异讲透需要落到具体行为上。线程是同一进程内的执行流,共享同一块地址空间:一个线程写的数组,另一个线程直接能看到,好处是零拷贝通信,坏处是任何写冲突都可能毁掉结果。进程是独立的地址空间,互相看不见对方的内存,Julia 的分布式进程间传数据要把对象序列化后经网络/管道送达,收件方再反序列化——数据大时这一来一回的开销能吃掉全部并行收益。用一组量化感受:传一个 10 元素的参数元组几乎无感,传一个 1GB 的矩阵则要秒级的序列化加拷贝。由此得出选型口诀:频繁共享大块数据选线程,任务独立且每个都算得久选进程。
# 感受两种形态的启动成本 Threads.nthreads() # 线程数:启动时定,如 julia -t 8 → 8 using Distributed nprocs() # 当前进程数:默认 1(只有主进程) addprocs(4) # 新拉起 4 个工作进程,各有一份独立内存 workers() # 列出工作进程的编号 rmprocs(4) # 用完可以收回
注意两套计数互不相干:nthreads 管线程、nprocs 管进程,一个 8 线程的 Julia 还可以再 addprocs(4),两者叠着用不是不行,但调度分析会变复杂,初学阶段保持只用一套。
案例:参数扫描为什么是并行教科书任务
背景:需要对模型参数 α 从 0.1 扫到 1.6,共 16 个取值,每个取值跑一次 30 秒的仿真,串行要 8 分钟。分析这个任务的结构:每次仿真只读自己的 α,写自己的结果文件,仿真之间零通信——这正是"无依赖任务"的定义,理论上 16 核可以压到 30 秒。动手前先做两步检查:
# 检查一:单次仿真本身是否类型稳定(避免 16 个核一起跑慢代码) @code_warntype simulate(0.5) # 阿姆达尔定律立刻给出上限的量级 speedup(n) = 1 / (0.1 + 0.9 / n) speedup(16) # 6.4 —— 10% 的串行段就把 16 核封死在 6 倍附近
结果解读:这类"外层并行、内层已经优化过"的任务实际能拿到理论值的八九成,8 分钟变 70 秒左右。变式:如果仿真间需要共享一个不断更新的"最优解",任务就沾上了通信,属于另一种形态(动态负载 + 共享状态),要换 5.2 的 @spawn 方案加原子操作。识别任务"干不干净",比记住任何 API 都重要。
并行正确性的三道检查
写出并行代码只是第一步,确认它"算对了"才是难点。第一道:结果确定性检查——固定随机种子后,串行版与并行版输出必须逐位一致,不一致几乎必有数据竞争。第二道:规模缩放检查——用 1、2、4 线程各跑一遍,加速比应接近线性;4 线程只快 1.5 倍,说明有锁竞争或负载不均。第三道:极端输入检查——任务数少于线程数、空任务、单元素集合,这些边界最容易触发调度层的死角。三道检查各只需几行断言,却是并行代码评审的标准动作。
扩展定律: Gustafson 的另一面
阿姆达尔定律容易让人悲观,但它的前提是"问题规模固定"。真实科研里核多了往往把问题也做大——模拟更大的系统、抽更多的样本,这就是 Gustafson 视角:并行部分随规模增长,串行部分(初始化、汇总)几乎不变,此时加速比随核数近似线性。两个定律不矛盾,分界在"你加核之后干什么"。固定问题规模追延迟(如实时控制),按阿姆达尔压缩串行段;扩大问题规模追吞吐(如参数扫描、更高分辨率模拟),按 Gustafson 放心堆核。判断自己属于哪类,是并行投入决策的第一步:
# 并行部分随核数放大,总完成的工作量线性增长 work(n) = 1 + 0.9 * n # n 核完成的"工作量单位" work(16) / work(1) # ≈ 14.6,接近线性
伪共享与缓存行:线程性能的隐形税
即使逻辑上无竞争,两个线程频繁写相邻内存也会互相拖慢——CPU 缓存以 64 字节缓存行为单位,线程 A 写自己那格 counts[1] 会把线程 B 缓存里的同一行(含 counts[2])判为失效,逼 B 回内存重取。本节分片方案里每线程一个 Int 槽位,相邻格子共用缓存行,高写入频率下能看到明显的伪共享损耗。修法是给每线程的槽位垫上填充,让它们落在不同缓存行。这个知识点日常未必用上,但解释了一个常见疑惑:"代码明明无竞争、加速却只有理论值的六成",此时用 @btime 对比垫填充前后的耗时,经常能找回丢掉的两成性能。
本节要点回顾
- 两形态:共享内存多线程、消息传递多进程,Julia 均原生;
- 无依赖任务(如抽样、参数扫描)是并行最佳拍档;
- 阿姆达尔定律:串行占比决定加速上限,先减串行再并行;
- 数据竞争静默出错,写共享状态前先想锁或分片。