5.2 并行计算常用工具
5.2 并行计算的常用工具
三件工具打天下:
@threads改写循环(多线程)、@spawn手动派任务(动态负载)、pmap逐任务映射(多进程)。掌握启动方式与适用边界,90% 的科学计算并行需求就覆盖了。
第一步:启动多线程
线程数在启动时指定,REPL 里可以用环境变量方式:
Threads.nthreads() # 默认是 1
启动命令 julia -t auto 会取物理核数。确认线程数后再谈并行——nthreads() == 1 时 @threads 只是普通循环,测不出任何加速。
@threads:最常用的并行循环
把 5.1 的求 π 改成线程版,用"每线程独立累加、最后求和"的分片模式避开竞争:
function mc_pi_threads(n) counts = zeros(Int, Threads.nthreads()) # 每线程一格 @threads for i in 1:n x, y = rand(), rand() if x^2 + y^2 <= 1 counts[Threads.threadid()] += 1 # 各写各的格子,无竞争 end end 4 * sum(counts) / n end @time mc_pi_threads(10^8) # 8 线程下约为单核的 7 倍
⚠️ 常见坑:老代码常见
threads[threadid()] += ...的"数组分线程"写法,在动态调度的循环里 threadid 可能重复,官方已不推荐。更稳的替代是下面@spawn的 per-task 方案。
@spawn:动态任务的积木
任务长度不均时,静态切分会让先干完的线程闲着。@spawn 把任务丢给调度器,配合 fetch 收结果:
using Base.Threads: @spawn function parallel_map(f, xs) tasks = map(xs) do x @spawn f(x) # 每个元素一个异步任务 end fetch.(tasks) # 等全部完成 end parallel_map(x -> sum(rand(10^x)), [6, 7, 6, 8]) # 任务大小不均也能自动均衡
pmap:多进程映射
进程级并行要先加工作进程,代价是数据要序列化传输,适合"每个任务计算重、数据小"的场景:
using Distributed addprocs(4) # 加 4 个工作进程 @everywhere function heavy(x) # @everywhere 让所有进程都定义这个函数 s = 0.0 for i in 1:10^7 s += sin(x * i) end s end results = pmap(heavy, 0.1:0.1:1.6) # 16 个任务自动分给 4 个进程
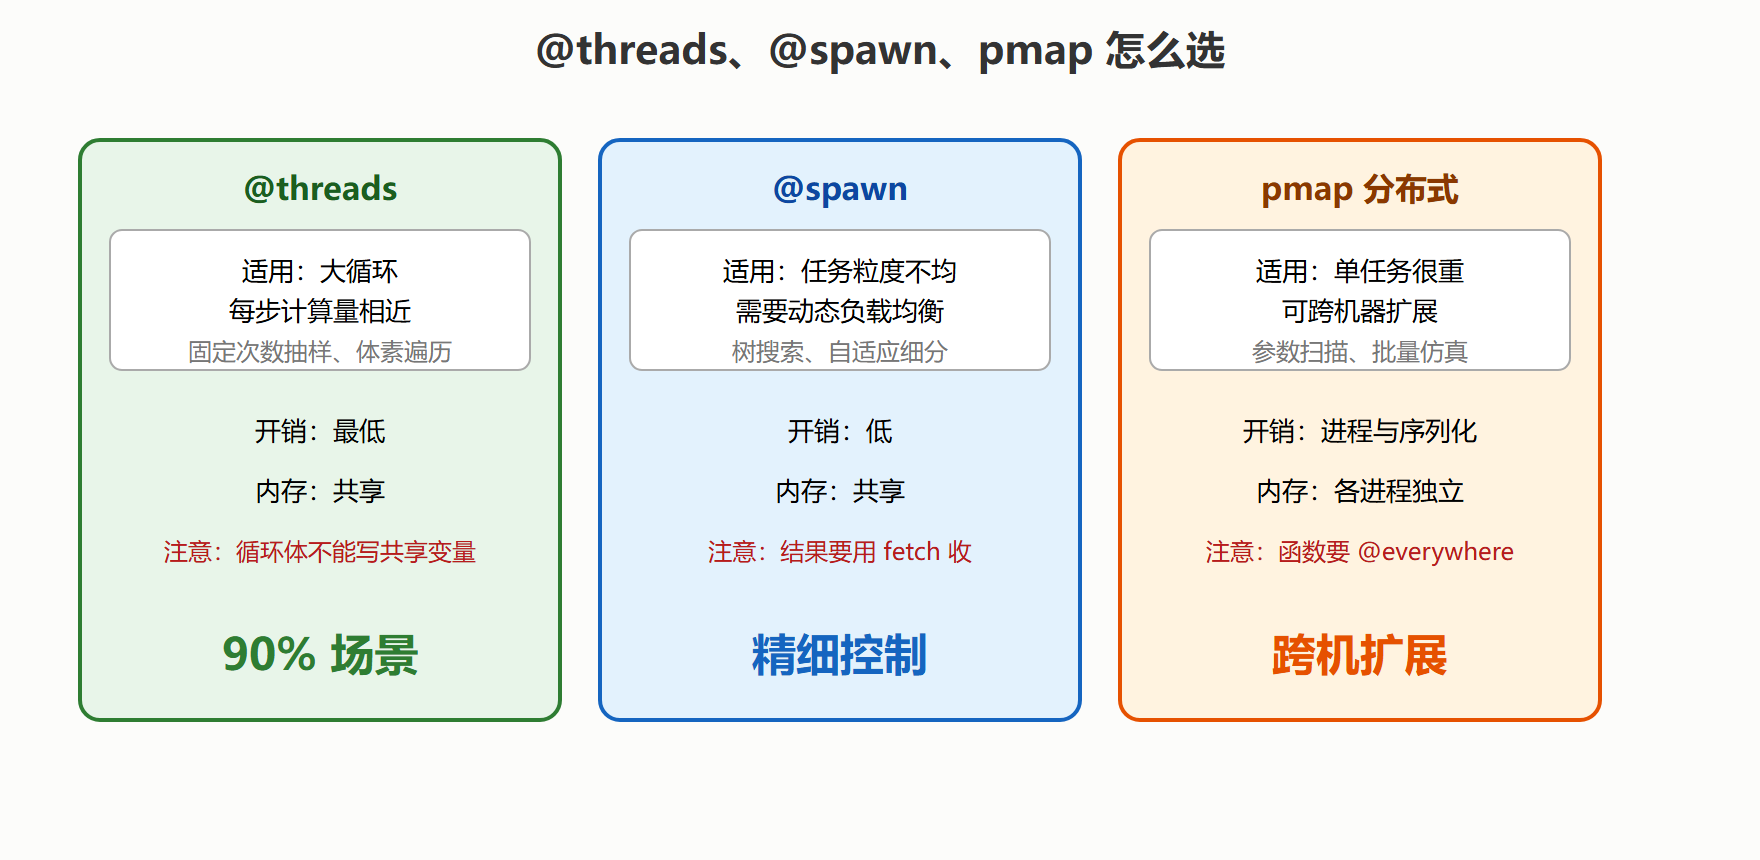
并行工具选型对照
案例:用 @spawn 写一个带进度的并行下载器骨架
背景:要处理 200 个来源的任务,单个耗时在 0.1 到 10 秒之间剧烈不均,静态切分必然出现"7 个线程完工、1 个线程还在干活"的尾巴。@spawn 的动态调度正是解药。骨架代码:
using Base.Threads: @spawn, nthreads function run_uneven(tasks) chunks = [Tuple{Int,Float64}[] for _ in 1:nthreads()] # 每任务格 ts = map(tasks) do t @spawn (myid = Threads.threadid(); # 记录执行线程 dur = heavy_work(t); # 真实工作负载 (myid, dur)) end fetch.(ts) # 收齐所有结果 end heavy_work(t) = (sleep(t); t) # 用 sleep 模拟不均匀耗时 res = run_uneven([0.1, 3.0, 0.2, 5.0, 0.1, 2.0, 8.0, 0.3])
操作后看结果分布:长任务被自然摊开,总耗时接近最长那个任务而非任务总时长,这就是动态负载均衡的直观形态。解读与变式:给 run_uneven 加一个进度打印(每完成一个任务 print 一个点),就成了带反馈的批量处理器;再加上 5.3 的 @btime,可以量化"静态切分 vs 动态调度"在真实负载下的差距——不均程度越高,@spawn 优势越大。
三个工具的排错现场
一是 @threads 循环里调用了会抛异常的函数:异常在哪个线程抛出不易控制,整个循环的善后逻辑(比如已写入一半的文件)要做幂等设计,重跑前先清理半成品。二是分布式场景忘了 @everywhere:主进程有函数定义、工作进程没有,报 UndefVarError 且错误信息指向工作进程编号,新手常误以为是自己代码里的拼写错误;排查口诀是"报错带进程号,先查 everywhere"。三是 pmap 的任务粒度太细:每个任务的传输与调度开销约毫秒级,任务本身若只算微秒,并行反而比串行慢十倍——合并小任务成批次,是分布式永远的第一优化。
混合方案:任务分块的通用模板
实际项目里最常用的不是单一工具,而是"分块 + 任务"的混合:把 n 个工作项切成大约线程数 × 4 的块,每块一个 @spawn 任务。块数多于线程数让调度器能填空隙,块又足够大不至于被任务开销吃掉。这个模板值得背下来:
using Base.Threads: @spawn, nthreads function chunked_foreach(f, items) nblk = nthreads() * 4 blocks = [items[i:min(i + cld(length(items), nblk) - 1, end)] for i in 1:step=length(items)÷nblk+1:length(items)] # 上面用区间切出块;更简单的写法是 Iterators.partition ts = map(b -> @spawn foreach(f, b), blocks) fetch.(ts) end chunked_foreach(x -> heavy_work(x), 1:100)
Iterators.partition(1:100, 25) 是切块的现成工具,配合这个骨架,从批处理文件到参数扫描都是"填一个 f"的事。模板的关键取舍只有块大小:块太小任务开销占比上升,太大负载不均,从"总数除以四倍线程数"起步再按实测微调即可。
本节要点回顾
- 线程数启动时定:
julia -t auto,nthreads()先确认; @threads+ 分片累加是固定循环的标准写法,别写裸共享变量;@spawn+fetch处理不均匀任务,调度器自动均衡;pmap面向重计算任务与多机,函数记得@everywhere;- 并行收益先用
@time实测,理论加速不等于实际加速。