5.3 性能优化技巧
5.3 性能优化技巧
性能优化是流程不是玄学:测时间 → 看分配 → 查类型 → 减内存 → 再并行。本节把这条流水线走一遍,每步都有配套宏或工具,全部可以在 REPL 里复现。
第 0 步:正确的测量姿势
用 BenchmarkTools,别用裸 @time:
] add BenchmarkTools using BenchmarkTools function slow_sum(v) s = 0 for x in v s += x end s end v = rand(10^6) @btime slow_sum($v) # $ 表示把变量"注入"基准测试,避免全局变量失真
@btime 多次运行取统计,输出时间与内存分配。看到 xxx allocations 高,基本就能锁定问题。
案例:一段代码的四轮优化
待优化的目标:向量各元素 sin·cos 之和。
四轮优化的时间与分配对比
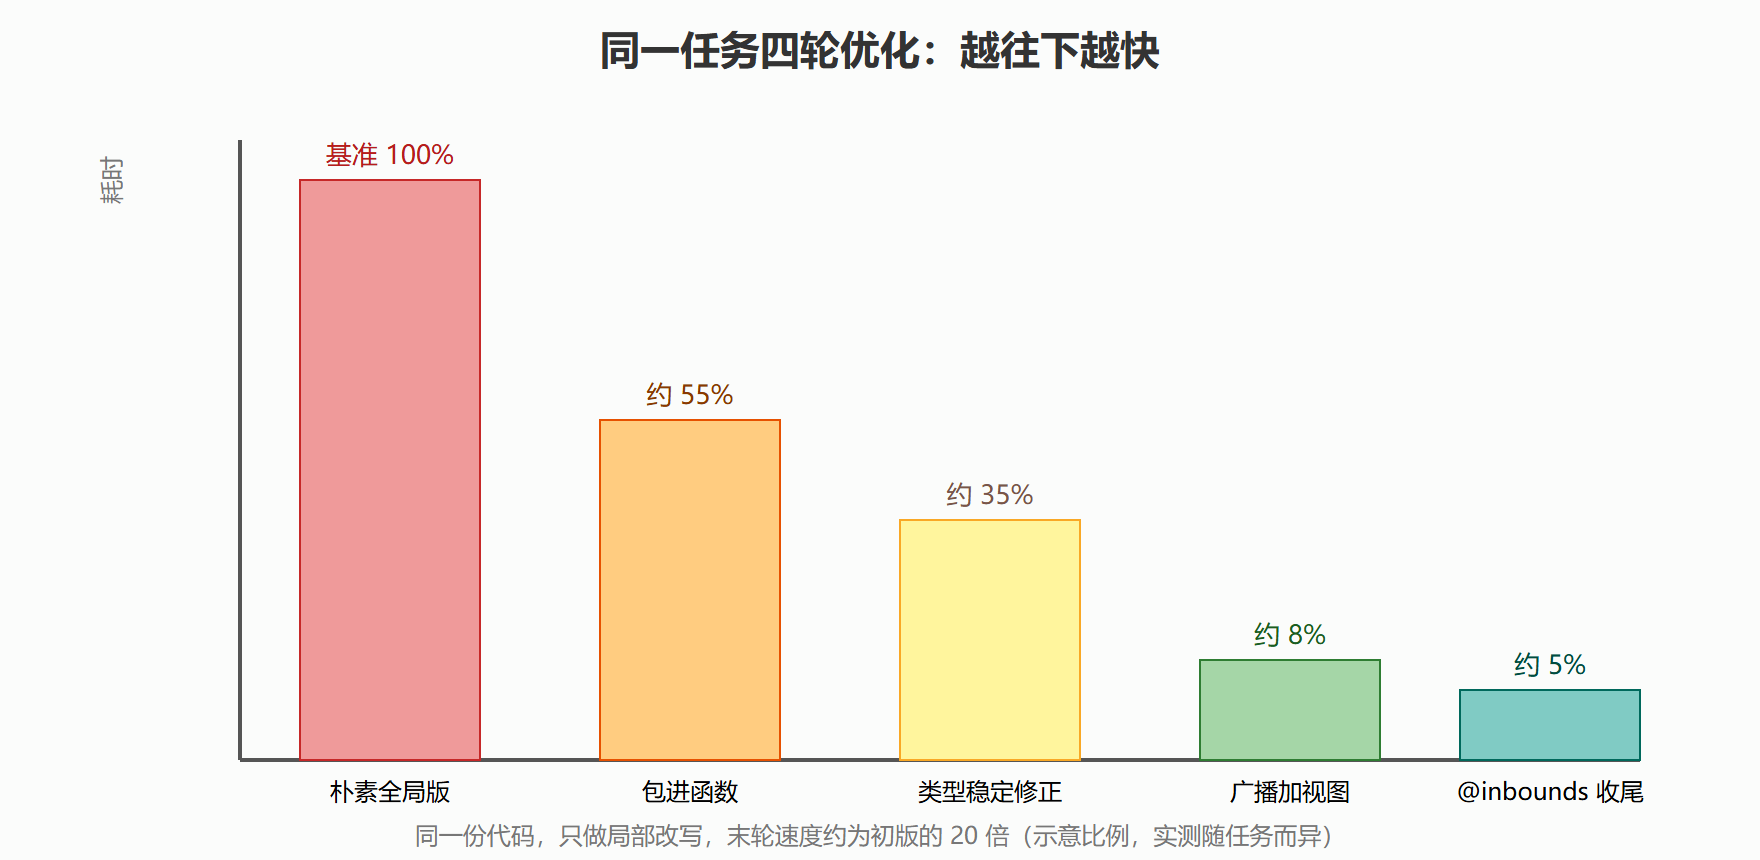
第一轮:包进函数。 顶层脚本的变量是全局的,类型不稳定:
f1(v) = begin s = 0.0 for x in v s += sin(x) * cos(x) end s end
第二轮:修正类型。 若初始值写成 s = 0(Int),累加 Float 时每次都在类型间转换,改成 0.0 并可用 @code_warntype f1(v) 验证已无黄色标注。
第三轮:广播替代临时量、视图替代切片。
f2(v) = sum(sin.(v) .* cos.(v)) # 广播融合,无中间数组 g(M) = sum(@view M[:, 1]) # 大矩阵取列用视图
第四轮:@inbounds 关掉边界检查(确认索引不会越界时才加):
function f3(v) s = 0.0 @inbounds for i in eachindex(v) s += sin(v[i]) * cos(v[i]) end s end
找热点:@profile
不知道哪慢就上 profiler:
using Profile @profile begin slow_sum(rand(10^6)) slow_sum(rand(10^6)) end Profile.print() # 调用树里行宽最大的就是热点
VS Code 的 Julia 提供火焰图插件,把同一份数据画成图,热点一眼可见(第 8 章会配套讲)。
⚠️ 常见坑三连:①拿第一次运行计时(含编译);②用全局变量做基准;③先并行后优化。三条都违反,优化方向必然跑偏。
💡 关键直觉:Julia 里"分配内存"比"多做算术"更贵。看到 allocations 高,优先消灭临时数组,往往比换算法见效更快。
深挖分配:Allocations 从哪来
"减少分配"说起来容易,得知道分配藏在哪。三类高发点按出现频率排。第一类,循环内构造临时数组:[(x, f(x)) for x in v] 每次迭代产一个小数组与一个小元组,百万元素的循环就是百万次分配,改成预分配结果数组加 @inbounds 写入,分配可降为零。第二类,字符串拼接做日志:热循环里 s = s * ", $x" 是 O(n²) 的分配灾难,日志攒进 IOBuffer 最后统一取出。第三类,捕获全局变量的闭包:匿名函数引用了外层非 const 变量,每次调用都触发装箱。用 @btime 的分配计数逐一验证:
using BenchmarkTools v = rand(10^6) # 版本 A:广播生成两个中间数组再加一个结果数组 @btime sum(sin.($v) .+ cos.($v)) # 约 11 MB 分配(三个临时数组) # 版本 B:写循环,手写累加 function sc(v) s = 0.0 @inbounds for x in v s += sin(x) + cos(x) end s end @btime sc($v) # 0 分配,且通常更快
两版语义完全相同,分配却一个天上一个地下——这就是"广播融合能省中间数组、但手写循环连融合都省了"的实证。变式:真要保留函数式写法,mapreduce(x -> sin(x)+cos(x), +, v) 也能做到零分配,风格与性能可以兼得。
优化的优先级陷阱
三个真实项目里反复出现的弯路。陷阱一:过早换算法。看到慢就怀疑算法复杂度,冲去写 O(n log n) 版本,结果瓶颈其实是 IO——先 @profile 再动手,一小时能省一天。陷阱二:微优化宏滥用。@inbounds、@simd、@fastmath 层层叠加,代码难读还引入数值差异(@fastmath 会改变浮点结合顺序),这些宏是"确认瓶颈后的最后一击",不是调味料。陷阱三:优化不可复测的代码。基准脚本依赖当次 REPL 状态,第二天测出相反结论——把基准写成独立文件、固定数据生成、记录机器状态,性能结论才有档案价值。三条的共同解药都是"先测量、后动手、留记录"。
编译期优化:预编译与首调延迟
首调延迟本身也能被优化。三个手段按投入产出排。第一,PrecompileTools 的 workload 模式:在包里录制一段典型调用,用户安装时提前编译,正式使用时首调几乎无延迟,发布自己包时的标配。第二,@codetypespeed 或直接读 @code_llvm 的输出验证关键函数是否真的编译成了紧凑机器码,偶尔能发现"看着稳定实则装箱"的漏网之鱼。第三,别在热路径上用运行时构造的小函数对象(如每次迭代新建闭包),把闭包提出循环,编译器才能复用同一份特化代码。这些属于"最后 10%"的优化,但做科学计算的包若要给别人用,首调体验就是第一印象,值得投入。
类型稳定的自查清单
四条快速判据,命中任何一条就值得跑一次 @code_warntype:函数有分支且各分支返回不同字面量类型;入参来自 Vector{Any} 或未类型化的字典取值;循环里出现 s = 0 起手然后累加 Float;返回值是三元表达式两侧类型不同。清单背后是同一个原理——编译器推断出的类型必须是唯一的,任何"可能是 A 也可能是 B"都会降级为动态路径。养成扫一眼签名就能预判稳定性的直觉,是本章与第 2 章知识的合流点。
本节要点回顾
@btime+$是测量的标准姿势;- 优化顺序:函数化 → 类型稳定 → 广播/视图 →
@inbounds→ 并行; @code_warntype抓类型病灶,@profile找时间热点;- 分配即成本,先减 allocations 再谈算法替换;
- 每一步都重新测量,防止"优化"变"负优化"。