6.2 从Volume到PVC:存储的申领制度
6.2 从 Volume 到 PVC:存储的申领制度
Volume 为容器提供文件系统之外的存储落点;PersistentVolumeClaim(PVC) 是应用侧的存储申领单——声明需要多大、什么访问模式;PersistentVolume(PV) 是供给侧的存储资源,StorageClass 负责按策略自动撮合两者。应用只写需求,不关心背后是云盘还是本地盘,这是存储的声明式革命。
容器文件系统随容器消亡,这句话在 1.3 节的 sidecar 案例里已经见识过(emptyDir 随 Pod 消失)。订单服务无状态可以不在乎,orders-db 的数据却绝不能随副本重建蒸发。本节沿着"临时卷、节点卷、申领卷"三级台阶,把存储从"运维手工挂盘"讲成"一行声明自动到位"。
存储的申领制度
先按台阶拾级而上。第一级 emptyDir:Pod 生命周期内的临时空间,Pod 删除即清空,1.3 节的日志共享卷就是它。第二级 hostPath:挂节点本机目录,Pod 重建后只要还在同一节点就能读回——但调度器不保证"同一节点",所以它只配 DaemonSet 这类绑定节点的负载用(4.3 节的日志采集器)。第三级才是主角:生命周期独立于 Pod 的持久卷。
申领制度三个角色一张图:
图 6-2:PVC 申领、PV 供给与 StorageClass 撮合
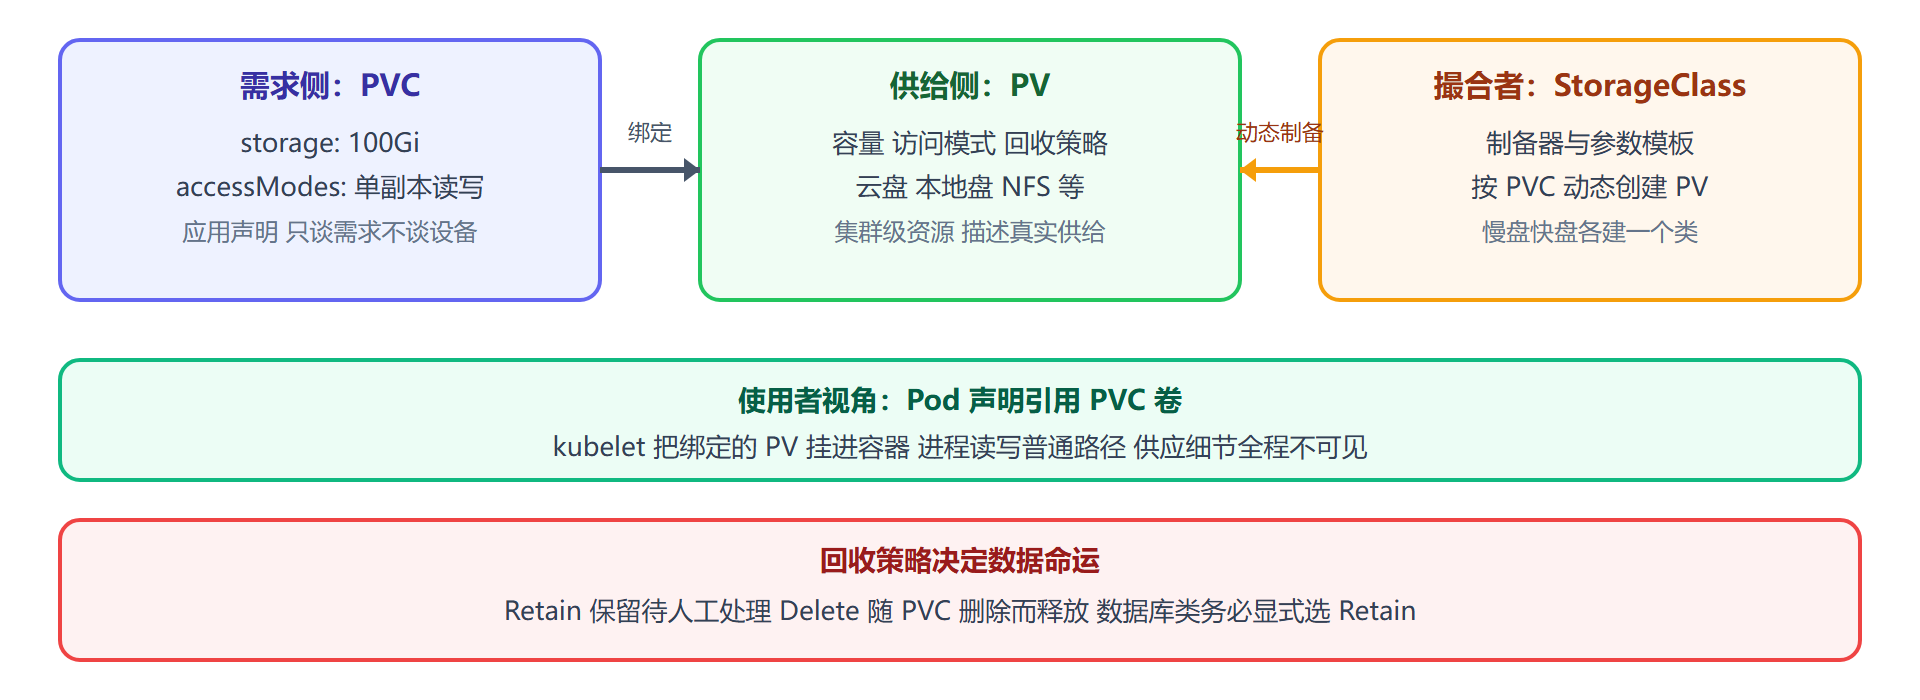
一张申领单写起来有多朴素,直接看:
apiVersion: v1 kind: PersistentVolumeClaim metadata: name: orders-data namespace: production spec: accessModes: ["ReadWriteOnce"] # 单节点独占读写 storageClassName: fast-ssd # 指定撮合策略:高性能盘 resources: requests: storage: 100Gi # 要多大
提交后 StorageClass 的制备器按模板创建 PV 并完成绑定:
kubectl apply -f orders-data-pvc.yaml # persistentvolumeclaim/orders-data created kubectl get pvc orders-data -n production # NAME STATUS VOLUME CAPACITY ACCESS MODES STORAGECLASS AGE # orders-data Bound pvc-3f8a2c11-... 100Gi RWO fast-ssd 12s # STATUS 为 Bound:申领成功,可被 Pod 挂载 kubectl get pv pvc-3f8a2c11-... # NAME CAPACITY ACCESS MODES RECLAIM POLICY STATUS STORAGECLASS # pvc-3f8a2c11-... 100Gi RWO Delete Bound fast-ssd # RECLAIM POLICY 是 Delete:PVC 删除时数据一并释放,数据库场景要当心
访问模式(accessModes)是申领单里最容易选错的一项,三种语义要分清:
| 模式 | 缩写 | 语义 | 典型用途 |
|---|---|---|---|
| ReadWriteOnce | RWO | 单节点读写 | 数据库、大多数有状态服务 |
| ReadOnlyMany | ROX | 多节点只读 | 配置分发、只读数据集 |
| ReadWriteMany | RWX | 多节点读写 | 共享文件系统场景(需 NFS 等支持) |
⚠️ 常见坑:多副本 Deployment 给同一个 PVC 配 RWX,指望"副本间共享磁盘"。即使卷支持 RWX,多个数据库实例写同一块盘也是数据灾难;共享数据应当走对象存储或专用共享文件系统,而不是把数据库盘共享出去。
案例:orders-db 的申领、验证与一次容量升级
背景:orders-db(三副本 StatefulSet)上线三个月,主库数据量逼近 100Gi 上限,需要扩到 200Gi,且要求不停机。
操作:
# 第一步:StatefulSet 的卷来自 volumeClaimTemplates(4.3 节),先看现状 kubectl get pvc -n production | grep orders-db # NAME STATUS VOLUME CAPACITY STORAGECLASS # data-orders-db-0 Bound ... 100Gi fast-ssd # data-orders-db-1 Bound ... 100Gi fast-ssd # data-orders-db-2 Bound ... 100Gi fast-ssd # 第二步:在线扩容——直接改 PVC 的 storage 字段(前提:StorageClass 允许扩容) kubectl patch pvc data-orders-db-0 -n production \ -p '{"spec":{"resources":{"requests":{"storage":"200Gi"}}}}' # persistentvolumeclaim/data-orders-db-0 patched # 第三步:观察扩容状态流转 kubectl get pvc data-orders-db-0 -n production # NAME STATUS VOLUME CAPACITY STORAGECLASS # data-orders-db-0 Bound ... 200Gi fast-ssd # STATUS 短暂经过 FileSystemResizePending 后回到 Bound,容器内文件系统已扩
结果:三个 PVC 依次扩容完成,数据库在线完成容量升级,全程副本保持就绪。
解读:在线扩容能成立,靠的是申领制度的两层配合——制备器先扩底层卷,kubelet 再触发文件系统扩展。但两个前提缺一不可:StorageClass 的扩容开关打开;访问模式是 RWO(多数支持扩容的驱动只支持 RWO)。缩容则从来不被支持,存储申领只涨不跌,规划容量时要按"只增不减"设计。
变式:跨集群迁移数据的标准路径是快照加恢复——用 VolumeSnapshot 给当前卷拍照、在新集群按快照建新 PVC,比冷拷贝文件优雅得多;本地盘集群(对延迟极敏感的场景)可用 Local PV 换取性能,代价是调度被绑定到盘所在节点,需配合存储感知的调度策略。
本节要点回顾
- 三级台阶:emptyDir 随 Pod、hostPath 随节点(仅 DaemonSet 场景)、PVC 独立于 Pod 与节点;
- 申领三角色:PVC 说需求、PV 是供给、StorageClass 撮合并支持动态制备;
- 访问模式定语义:RWO 是数据库默认答案,RWX 留给真正的共享文件系统;
- 回收策略定命运:数据库类显式 Retain,默认 Delete 会在 PVC 删除时连数据一起清场;
- 扩容有前提:只支持在线扩大、不支持缩小,依赖制备器能力与 RWO 模式。
两条补给线全部贯通,主线声明至此完整:负载、副本、入口、围墙、配置、存储。最后一章切换到运行的另一面——看得见(可观测)、修得好(排障)、带得走(Helm 与 GitOps 的规模化分发)。