第7章 运行之后:可观测、排障与声明规模化
第7章 运行之后:可观测、排障与声明规模化
章节摘要:本章跟着一条线走——声明完整兑现、流量与补给就位之后,运维视角的三个新问题:怎么看见它(日志、指标、追踪三支柱),怎么修它(一套按层排查的现场手册),以及怎么把它复制到一百个环境(Helm 模板化与 GitOps 自动同步)。声明的旅程在此从"部署一次"走向"运营一套"。
一条主线
orders-api 已经在集群里稳定运行:副本守恒、滚动有序、入口稳定、配置外置。但第2章到第6章的所有机制都建立在一个前提下——你得看得见它。看不见的控制器在调和、看不见的探针在判罚、看不见的调度在选址,出了问题你只能对着 Pending 发呆。本章第一节先装上眼睛:日志回答"发生了什么",指标回答"现在怎么样",追踪回答"请求经过了哪里"。
第二节的排障手册把前六章的知识点串成作战序列:按"资源层、声明层、落地层、流量层"四层排查,每层有固定命令与判读口径。第三节解决规模化的最后一公里:一份 orders-api 的声明要变成一百个环境的配置,靠复制粘贴注定失控,Helm 用模板参数化声明,GitOps 用仓库做唯一真相源、让集群自动向仓库收敛。
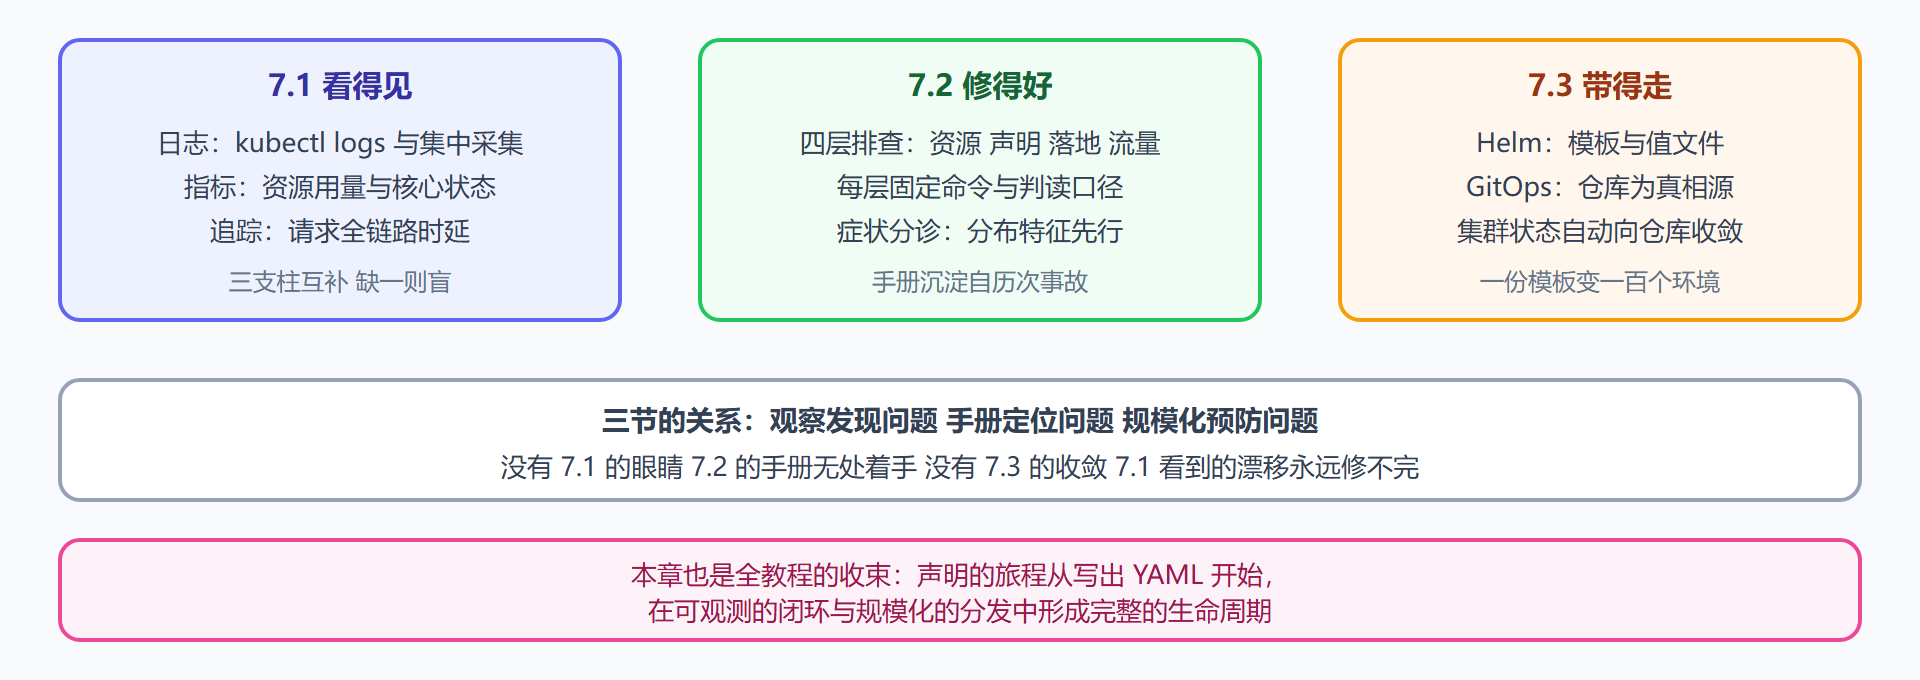
图 7-1:从一份声明到一套运营体系
沿途站点
- 7.1 可观测三支柱:日志、指标与追踪:kubectl logs 的正确姿势(含上一实例与伴随容器)、指标体系从 cAdvisor 到告警规则的链路、追踪对"请求到底慢在哪一跳"的判别力,以及三者如何拼成完整现场。
- 7.2 排障现场:当声明与现状不一致时:四层排查法(资源、声明、落地、流量),把前六章的 describe、endpoints、探针、事件等工具编成固定序列,配一个完整的综合案例。
- 7.3 声明的规模化分发:Helm 与 GitOps:模板与值文件的参数化、发布与回滚的版本管理、Argo CD 式的自动同步闭环,以及"声明漂移"这个规模化时代的新故障形态。
拐点与结论
本章的认知拐点在 7.3:规模化时代最大的故障源不是组件坏,而是声明漂移——有人手工 kubectl 改了线上、有人跳过评审改了值文件,集群实际状态与任何记录都对不上。GitOps 的解法不是更强的纪律,而是机制:集群对仓库做单向收敛,手工修改会被自动纠正,一切变更都变成一次提交。
结论一句话:前六章教你把声明送进集群,这一章教你长期拥有它——看得见、修得好、带得走,声明式体系才算真正落地。
读完你应该
- 熟练使用 logs 及其参数(上一实例、伴随容器、时间窗)完成第一现场取证;
- 说明指标从采集到告警的链路,并为服务配置利用率与错误率两类核心告警;
- 用追踪数据定位一次慢请求的责任方(应用、依赖还是网络);
- 按四层排查法处置 Pending、CrashLoop、端点空名单三类典型故障;
- 用 Helm 把一套声明参数化为多环境配置,并解释 GitOps 单向收敛的防漂移价值。
下一章的接力
本章是终章。教程主线里那份 orders-api 的声明,从 1.2 节的第一行 YAML 走到 7.3 节的一百个环境,走完了 Kubernetes 声明式体系的全程。合上教程后的下一步属于你自己的集群:把自己的应用写成第一份声明,让它在调度、自愈与观测的守护下运行起来。