3.1 索引原理与全表扫描事故
3.1 索引原理与全表扫描事故
本节摘要:MongoDB 索引默认是 B 树,把字段值按序组织,使等值与范围查询免于扫描全集合。本节从一次线上停摆事故讲索引的原理、explain 执行计划的读法与常用索引类型。
事故档案 06:三条查询打停一个集群
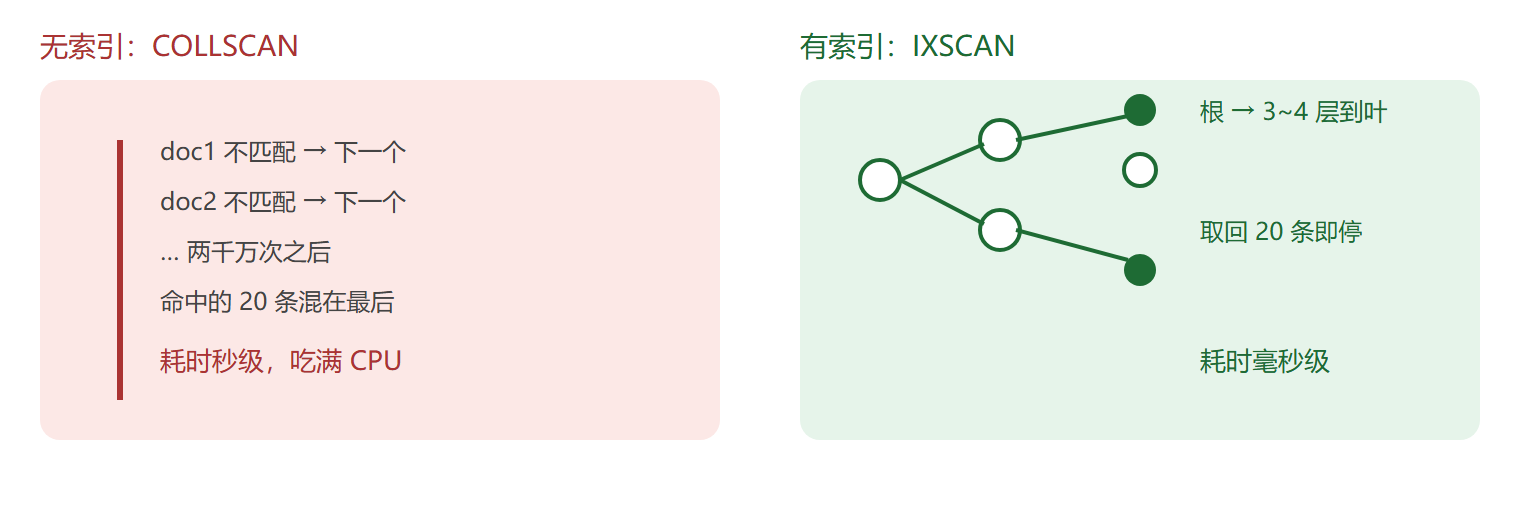
社交产品上线"好友动态"页,后端按 ownerId + createTime 查动态集合,2000 万文档,没有对应索引。上线十分钟后主库 CPU 打满,所有请求排队,整站不可用二十分钟。事后 explain 复盘,三条并发查询全是 COLLSCAN。
// 事故查询 db.feeds.find({ ownerId: "u88", createTime: { $gt: ISODate("...") } }) .sort({ createTime: -1 }).limit(20); // explain 关键输出 db.feeds.find({...}).explain("executionStats") // stage: "COLLSCAN" ← 全表扫描 // nReturned: 20 docsExamined: 20000000 totalDocsExamined: 20000000
docsExamined: 两千万,nReturned: 20——这就是全表扫描的账单:为 20 条结果摸了两千万个文档。
B 树为什么快
B 树把索引键按序放在多叉树里,从根到叶通常只有 3–4 层,一次等值查找只需几次页访问。代价是每次写入都要同步维护所有索引的顺序:索引不是越多越好,写多读少的集合堆索引,等于给每次写入加税。
常用索引类型:
| 类型 | 建法 | 场景 |
|---|---|---|
| 单字段 | createIndex({uid: 1}) | 最基础 |
| 复合 | createIndex({a: 1, b: -1}) | 多条件查询,见 3.2 |
| 多键 | 自动,字段是数组 | 标签、成员列表 |
| 文本 | createIndex({txt: "text"}) | 分词搜索 |
| 地理 | createIndex({loc: "2dsphere"}) | 附近的人 |
| TTL | createIndex({ts: 1}, {expireAfterSeconds: 3600}) | 日志自动过期 |
同一查询的两种命运
💡 把 explain("executionStats") 写进代码评审清单:凡是新增查询,贴一次执行计划,COLLSCAN 一票否决。
事故复盘:二十分钟停摆的完整时间线
回看这二十分钟。第 0 分钟新页面上线,三条并发查询进入主库;第 2 分钟 CPU 监控告警,此时请求队列已开始堆积,连接数被慢查询占满,后续包括健康检查在内的所有请求排队;第 5 分钟运维介入,第一反应是重启应用——无效,查询会立刻重新压上来;第 8 分钟有人执行 db.currentOp() 才看到三条执行中的 find,每条的 secs_running 都在飞涨,db.killOp() 终止后 CPU 回落,页面回滚,服务恢复。从告警到恢复的二十分钟里,真正有效的动作只有两个:看 currentOp、杀操作。前面十几分钟浪费在对应用层的无差别怀疑上。
事后给所有查询路径补 explain 时发现一个细节:这个查询在测试环境毫秒级返回,因为测试集合只有两万文档,COLLSCAN 也很快。全表扫描的可怕之处就在这——它的耗时与数据量成正比,环境之间不可外推。预防手段是把 explain 断言写进集成测试:对关键查询断言 stage 不是 COLLSCAN,数据量小不影响计划选择,索引缺失在测试期就能暴露。
// 运行中操作的现场观察 db.currentOp({ active: true, secs_running: { $gt: 1 } }); // { desc: "conn123", command: { find: "feeds", ... }, secs_running: 42, ... } db.killOp("conn123:78901"); // opid,杀掉单个失控查询 // 长期方案:服务端限制单查询执行时长 db.adminCommand({ setParameter: 1, maxTimeMSOpOnly: true }); db.runCommand({ find: "feeds", filter: {...}, maxTimeMS: 3000, singleBatch: true });
maxTimeMS 是应用侧的自保手段:查询超时被服务端主动终止并报错,一条失控查询烧完自己的时间预算就出局,不再拖垮整个实例。给所有用户触发的查询都加这个参数,是我认为性价比最高的一条工程规范。
explain 输出的三层读法
很多初学者打开 explain 就找 COLLSCAN 一个词,其实输出分三层,各回答一个问题。queryPlanner 层回答"选了什么计划":看 winningPlan 里的 stage 序列,IXSCAN 之后如果还有 FETCH,说明索引命中后要回表取文档;如果看到 PROJECTION_COVERED,说明覆盖索引生效,连回表都省了。executionStats 层回答"执行得多差":三个数字 nReturned、totalKeysExamined、totalDocsExamined 构成效率比,理想状态三者接近或相等,比值每大一个数量级,就多浪费一个数量级的 IO。allPlansExecution 层回答"有没有更好的选择被放弃":候选计划的对比数据都在这里,索引设计调优时最有用。
db.feeds.find({ ownerId: "u88" }) .sort({ createTime: -1 }).limit(20) .explain("executionStats").executionStats; // { nReturned: 20, totalKeysExamined: 20, totalDocsExamined: 20, // executionTimeMillis: 2 } ← 三值相等,健康
本节要点回顾
- COLLSCAN = 全表扫描,docsExamined 与 nReturned 的比值就是浪费倍数;
- B 树以写入维护成本换查询速度,索引数量要克制;
- TTL 索引可让日志类数据自动过期;
- explain 三阶段:planSummary 看走没走索引,executionStats 看扫描量。