3.2 索引设计与维护事故
3.2 索引设计与维护事故
本节摘要:复合索引设计遵循最左前缀与 ESR 原则(等值在前、排序居中、范围在后)。本节从一次"建了索引却不走"的事故讲索引设计的规则、常见失效写法与索引运维(隐藏索引、冗余清理)。
事故档案 07:建了索引,查询还是慢
档案 06 修复后,工程师给动态集合建了 {createTime: -1, ownerId: 1}。查询依旧慢——explain 显示走了索引但 keysExamined: 1500000,因为查询条件是 ownerId 等值 + createTime 范围,而索引把 createTime 放在前, ownerId 只能在索引内逐条过滤。
复合索引的顺序不是并列,是包含关系:查询必须能从索引的最左列开始连续命中。
ESR 原则
复合索引字段顺序按三类排:
- Equality 等值:
ownerId: "u88",放最前,最大限度缩小范围; - Sort 排序:
createTime: -1,让索引序替代内存排序; - Range 范围:
createTime: {$gt: ...},放最后,因为范围之后无法继续用索引收敛。
// 修复:等值在前,排序/范围字段复用 createTime db.feeds.createIndex({ ownerId: 1, createTime: -1 }); // explain 变化:keysExamined 从 150 万降到 20 出头,scanAndOrder 消失
常见索引失效写法
db.users.find({ phone: 13800138000 }) // 字段是字符串,数字查 = 隐式不匹配 db.users.find({ name: /^张/ }) // 前缀正则可以走索引 db.users.find({ name: /张$/ }) // 后缀正则 = 全扫 db.users.find({ age: { $ne: 18 } }) // 否定条件基本不收敛 db.users.find({ $where: "this.a > this.b" }) // 脚本执行,永远全扫 db.users.find({ score: { $gt: 60 }, level: 3 }) // 索引只有 {score:1} 时 level 靠过滤
类型不匹配是最阴的一类:不报错、返回空或慢,索引存在但等于不存在。
索引生命周期视图
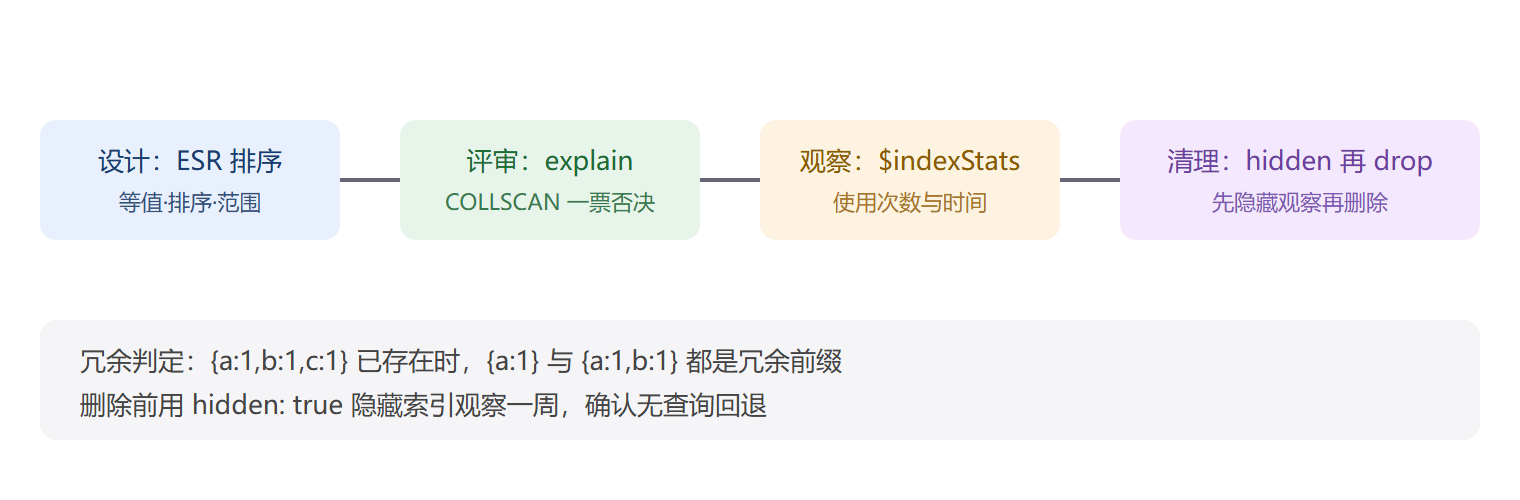
索引运维命令
db.collection.getIndexes(); // 列出全部 db.collection.aggregate([{ $indexStats: {} }]); // 每个索引的使用统计 db.collection.hideIndex("ownerId_1_createTime_-1"); // 隐藏而非删除 db.collection.dropIndex("ownerId_1"); // 确认冗余后删除
⚠️ 建索引默认是前台构建时代的遗留恐惧,现代版本后台构建仍会消耗 IO 与缓存,大集合建索引要避开业务高峰;复制集环境下还应滚动建。
事故复盘:为什么第一版索引"差一个身位"
这起事故的定位花了半小时,过程很典型。explain 显示走了 IXSCAN,按 3.1 的标准似乎"健康",但 keysExamined 高达 150 万——索引在用,只是用错了方向。索引 {createTime: -1, ownerId: 1} 的最左列是 createTime,查询里的 createTime 是范围条件(最近一周),范围条件在最左列意味着索引先框出"最近一周"的全部数据(正是那 150 万条),再在索引内逐条核对 ownerId。等值条件 ownerId 被降级成了过滤器。把两个字段顺序对调,等值的 ownerId 先把候选集缩到单个用户的几十条,排序和范围都在这个小集合内完成——同一个索引、同样的字段,顺序决定了是先收敛再过滤,还是先框大圈再挑人。
ESR 之外还有一个反直觉的边界情况:当等值列的取值特别集中(比如 90% 文档的 status 都是 "active")时,把低选择性的等值列放最前反而可能劣化,查询计划器有时会直接放弃这个索引。原则是给原则留余地——ESR 是起点,最终以 explain 的三个数字为准,规则负责让你第一次就接近正确,测量负责确认正确。
冗余索引与看不见的成本
索引运维里最容易被忽视的是冗余。{ownerId: 1} 是 {ownerId: 1, createTime: -1} 的前缀,前者可以被完全替代;每多一个冗余索引,每次写入多一份 B 树维护、缓存多一份占用、复制集多一份同步开销。用 $indexStats 找出 accesses.ops 全为零的索引,它们就是纯成本:
db.feeds.aggregate([{ $indexStats: {} }]) // { name: "ownerId_1", accesses: { ops: 0, since: ISODate("...") }, // host: "node1:27017" } // ops 为 0 且 since 超过一个业务周期的索引,进入下线候选
下线流程固定三步:hideIndex 让优化器不再选择它但对写入照常维护,观察一到两个业务周期(覆盖月度任务类查询);确认无回归后 unhideIndex 再 dropIndex 物理删除;删除前后各记录一次写入延迟,大索引消失后写吞吐的改善通常会立竿见影。4.4 之前的版本没有 hide 能力,替代做法是先在应用配置里移除依赖再删,风险窗口更长。
部分索引与稀疏索引
两类"缩小索引体积"的武器值得对比着记。部分索引用 partialFilterExpression 只索引满足条件的文档,例如只给 status 为 "paid" 的订单建索引,历史已取消的几亿条文档完全不进 B 树;稀疏索引 sparse 则只跳过"字段缺失"的文档。前者的过滤条件更丰富(等值、范围、存在性都行),后者只认字段存在与否,实践中我几乎总是选部分索引——它表达力更强,且能与唯一约束组合,实现"只在子集上唯一"这类关系库要用条件索引才能表达的需求。
// 只给有效订单建索引,体积缩小约 60% db.orders.createIndex( { userId: 1, createdAt: -1 }, { partialFilterExpression: { status: "paid" }, name: "idx_paid_user_time" } ); // 注意:查询必须显式含 status: "paid" 才可能命中该索引
TTL 索引的维护细节也提一句:过期删除由后台任务每 60 秒批量执行,删除高峰会形成写入压力尖峰,日志类集合如果每分钟过期量巨大,用固定集合 capped collection 替代往往更平稳。
本节要点回顾
- ESR 原则:等值 → 排序 → 范围;
- 最左前缀:跳过最左列的查询用不上复合索引;
- 失效清单:类型不匹配、后缀正则、否定条件、$where;
- 删除走两步:hidden 观察,再 drop。