5.1 建模原则与滥用内嵌事故
5.1 建模原则与滥用内嵌事故
本节摘要:MongoDB 建模的第一抉择是内嵌还是引用,判断依据是访问模式而非实体关系。本节从一次 16MB 文档撑爆的事故讲三大建模原则与两类结构性风险。
事故档案 10:一条文档长到 16MB
头部主播的直播间,把弹幕全部内嵌在直播间文档的 comments 数组里。爆房时弹幕每秒上千条,半小时后写入全部报错:
BSONObjectTooLarge: Document in liveroom liveroom:10086 exceeded maximum allowed size 16777216
直播间还在,但这条文档再也写不进去,修复只能紧急迁移。这不是参数问题,是结构问题:把无界增长的数据塞进了有上界的容器。
三大建模原则
- 一起读的放一起:一份订单与其商品行内嵌,一次查询取全;
- 无界增长的拆出去:评论、消息、日志用独立集合加引用;
- 避免超深嵌套:三层以上的嵌套会让更新与索引都变别扭,通常预示着建模错位。
// 正确形态:直播间的弹幕独立成集合,按 roomId 引用 db.comments.insertOne({ roomId: 10086, ts: ISODate(), user: "u1", text: "666" }); db.comments.createIndex({ roomId: 1, ts: -1 }); // 分页拉取吃索引
内嵌与引用的对照
| 维度 | 内嵌 | 引用 |
|---|---|---|
| 读取 | 一次查询 | 至少两次(或 $lookup) |
| 写入 | 整文档竞争,数组大时代价高 | 各自独立写 |
| 上界 | 16MB 硬顶 | 无 |
| 适用 | 组成部分、量有上界 | 无界列表、多方共享 |
| 典型 | 订单-商品行 | 用户-订单、直播间-弹幕 |
一个实用的自问:这段数据的数量上限,我敢写进合同吗? 商品行敢(一单几十条封顶),弹幕不敢——不敢就拆。
判断流程
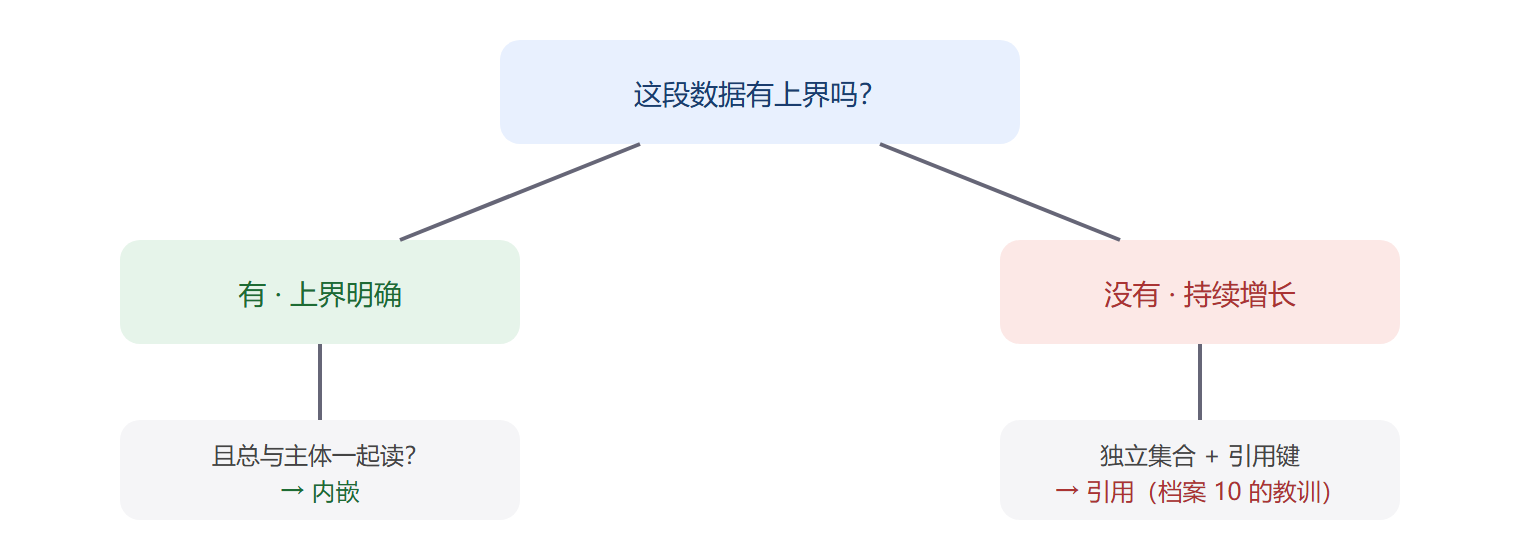
⚠️ 内嵌不是"高级用法",引用也不是"退回关系库"。两者都是工具,判据只有一个:数据的生长方式与读取方式。
事故复盘:一条 16MB 文档的死亡过程
文档不是瞬间撞顶的,它经历了漫长的濒死期。事后看监控,弹幕数组在开播后第 14 分钟突破 8MB,此时每次 append 弹幕都是一次"读出 8MB、追加一条、写回 8MB"的整文档重写,WiredTiger 的写放大让弹幕接口延迟从 10 毫秒悄悄爬到 300 毫秒,但仍在可忍受范围,没人告警。第 22 分钟超过 12MB,写放大继续恶化,缓存里挤满了这条文档的历史版本。第 29 分钟,BSON 序列化时长度超过 16777216,服务器拒绝写入并抛错——这一刻问题才可见,而结构早已病入膏肓。更糟的是读侧:房间页每次拉取直播间信息,都会把这条巨型文档整个传输回来,前端只为了拿房间标题。
紧急修复分三步:新建 comments 独立集合,写入侧双写新旧结构;用聚合把存量弹幕从巨型文档里 $unwind 出来回填新集合;核对后删除旧数组字段。整个迁移耗时两天,其中一天花在验证"回填没有丢弹幕"上。
// 存量迁移:把巨型数组展开回填 db.liveroom.aggregate([ { $match: { comments: { $exists: true } } }, { $unwind: "$comments" }, { $merge: { into: "comments", on: "_id", whenMatched: "fail" } } ], { allowDiskUse: true }); // 验证数量一致后,再 $unset 清掉旧数组 db.liveroom.updateMany({}, { $unset: { comments: "" } });
预防层面,评审时问"数量上限敢不敢写进合同"之外,再加一条技术检查:对含数组的文档建立平均大小的月度监控,db.collection.stats() 的 avgObjSize 持续上涨的集合就是下一个撞顶候选,提前动手比事故当天从容一百倍。
写竞争:内嵌的第二个代价
16MB 之外,内嵌还有一条不那么显眼的代价:并发写竞争。数万观众同时给直播间点赞、同时给商品加购物车,落到同一条文档上就是文档级的写锁竞争,驱动侧表现为 WriteConflict 重试增多、延迟抖动。分拆成独立集合后,不同弹幕是不同文档,写天然并行。经验法则:当一个数组既是高频读热点又是高频写热点时,无论会不会撞顶都该拆——读写同文档的并发度需求,是比容量更早到来的约束。
反过来也要防矫枉过正。把订单商品行拆成单独的"订单行"集合、每次展示订单都 $lookup 拼装,是另一个极端:一次页面渲染变成几十次查询,还引入了跨文档一致性负担(第 8 章会看到多文档事务的代价)。商品行有天然上界、与订单同生共死、永远一起读——教科书级的内嵌场景。判断宁可朴素:先按三问走,摇摆时选读写次数更少的那边。
监控与预警的落地
把 avgObjSize 监控真正落地的团队不多,原因是缺一个可执行的阈值。实践中好用的做法是同时监控两个比值:集合平均文档大小相对 16MB 上限的占比,以及月环比增速。前者超过 3%(约 500KB)就值得看一眼结构,后者连续两个月超过 10% 就该进入拆分排期。整数阈值拍脑袋没用,关键在于让"文档在长大"这件事从不可见变成每月自动出现在容量评审的表格里。
// 每月容量巡检:找出均文档最大与增长最快的集合 db.getMongo().getDBNames().forEach(d => { db.getSiblingDB(d).getCollectionNames().forEach(c => { const s = db.getSiblingDB(d).getCollection(c).stats(1024 * 1024); if (s.avgObjSize && s.avgObjSize / 16 > 0.03) print(d + "." + c, "avgMB=" + (s.avgObjSize).toFixed(2), "pct=" + (s.avgObjSize / 16 * 100).toFixed(1) + "%"); }); });
巡检脚本只解决发现问题,解决问题仍靠评审期的三问。两条线合在一起,才构成对无界数组这类结构性风险的完整防线:评审挡住新问题,巡检兜住漏网的旧问题。
本节要点回顾
- 16MB 是文档硬顶,无界数组是最常见的撞顶方式;
- 判断依据是访问模式:怎么读就怎么摆;
- 三问:有上界吗、一起读吗、嵌套几层;
- 结构问题参数救不了,上线前评审比事后迁移便宜一百倍。