5.2 文档结构与模式设计事故
5.2 文档结构与模式设计事故
本节摘要:常见建模模式包括分桶、扩展引用、属性模式、子集模式等,用于在"内嵌太快撞顶、引用太多次往返"之间找平衡;Schema Validation 用 $jsonSchema 在写入端挡住脏结构。本节从一次时序数据写入崩溃讲这些工具的用法。
事故档案 11:每秒一万个文档的传感器
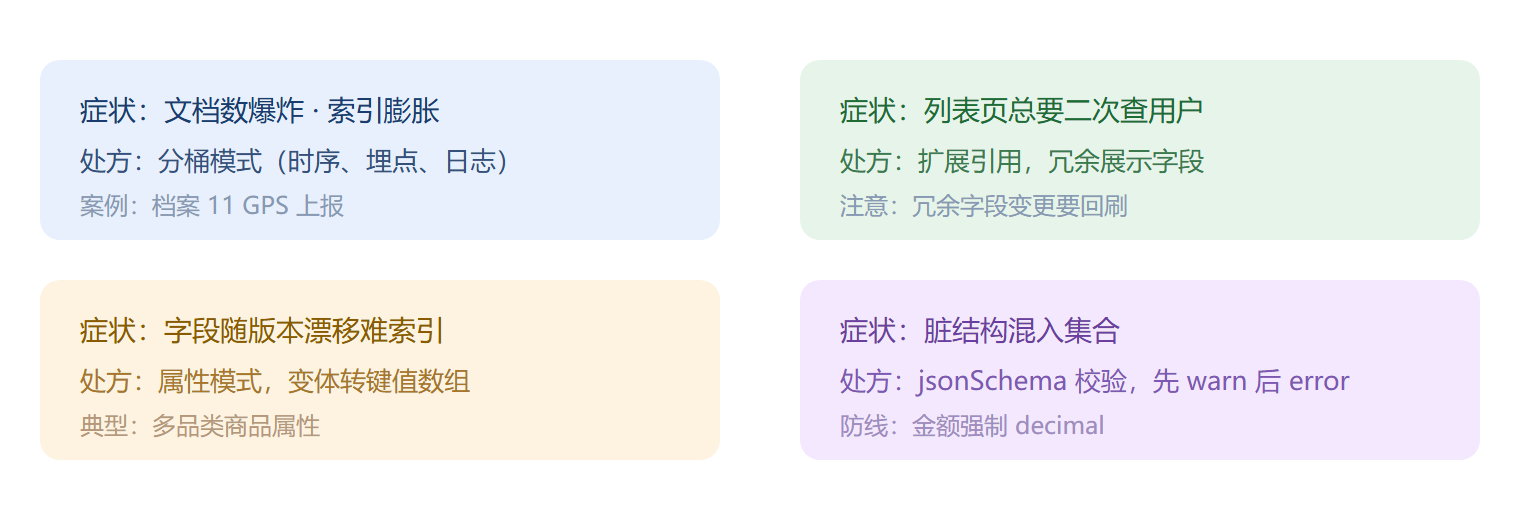
车队平台每车每秒上报一次 GPS,直接一报一文档。三万辆车一天写入 26 亿文档,索引膨胀、查询分页越来越慢。修复用的是分桶模式:一辆车一分钟的状态聚成一个文档,文档数砍掉 60 倍。
// 分桶前:一条上报一个文档 { carId: "沪A123", ts: ISODate(), lng: 121.4, lat: 31.2, speed: 62 } // 分桶后:一分钟一个文档 { carId: "沪A123", minute: "2026-08-22T10:05", samples: [ { ts: 10, lng: 121.4, lat: 31.2, speed: 62 }, /* ... */ ] }
模式速览
| 模式 | 做法 | 解决什么 |
|---|---|---|
| 分桶 | 多条时序数据聚进一个文档 | 文档数爆炸、索引膨胀 |
| 扩展引用 | 引用时冗余常用字段 | 免去二次查询 |
| 属性模式 | 变体字段改成键值数组 | 字段漂移、跨字段统一索引 |
| 子集模式 | 热点少量内嵌、全量另存 | 大列表只需前 N 条 |
| 计算模式 | 写时聚合好统计值 | 高频重算 |
// 扩展引用:订单里冗余用户昵称,列表页不用再查 users db.orders.insertOne({ uid: "u42", userName: "老王", amount: NumberDecimal("59.00") }); // 子集模式:文章内嵌前 5 条评论,全量评论另存 { pid: "p9", title: "...", topComments: [/* 5 条 */] }
Schema Validation:给灵活画一条线
文档库不做强约束,不等于不能约束。$jsonSchema 在集合层定义必填字段与类型,写入端拦截:
db.createCollection("orders", { validator: { $jsonSchema: { required: ["orderId", "amount", "currency"], properties: { orderId: { bsonType: "string" }, amount: { bsonType: "decimal" }, // 档案 04 的防线 currency:{ enum: ["CNY", "USD"] } } }}, validationLevel: "strict", validationAction: "error" // 违规拒绝写入;error 改 warn 只记日志 });
存量集合也能加:collMod 挂 validator,先以 warn 观察存量脏数据比例,再切 error。
模式选择速配
💡 模式不是选完就终身的。访问模式变了(比如评论要独立搜索了),就该重估内嵌/引用——预留一次结构演进的窗口,比预测未来靠谱。
事故复盘:26 亿文档是怎么把集群吃垮的
26 亿不是一个夸张数字:三万辆车、每车每秒一条、一天八万六千秒,乘出来就是 26 亿。问题在三个层面同时爆发。存储上,每条上报虽小(约 200 字节),但四条索引(车号、时间、车号加时间、地理位置)让索引体积五倍于数据本体,磁盘两个月告急。查询上,"回放某车某段轨迹"要按车号加时间范围扫描,分页越深越慢。运维上,每天的插入峰值让 oplog 与主从同步持续高压,第 6 章的复制原理会解释为什么写入洪峰会直接威胁复制延迟。
分桶的收益是复合的。按"一辆车一分钟一个文档"聚合后,文档数从每天 26 亿降到 4320 万,索引键同比例减少;每个文档约 60 个样本、几 KB 大小,远在 16MB 之内且大小稳定;回放轨迹一次查询拿到整分钟数据,网络往返也少了。代价是查询语义变了:查"某时刻全车队位置"这种横向查询,从一次索引扫描变成先算时间桶再聚合,写侧还要在应用层维护"当前分钟桶"的 $push 追加。时序场景这个代价完全值得,横向查询为主的数据则要慎重——模式跟着访问模式走,分桶不是万能药。
// 分桶写入:当前分钟的桶 $push 追加,跨分钟时新建桶 db.gps.updateOne( { carId: "沪A123", minute: "2026-08-22T10:05" }, { $push: { samples: { ts: 5, lng: 121.4, lat: 31.2, speed: 62 } }, $setOnInsert: { createdAt: new Date() } }, { upsert: true } ); // 回放:一次查询拿到整段轨迹 db.gps.find({ carId: "沪A123", minute: { $gte: "10:00", $lt: "10:10" } });
补一个容量对照:mongo 官方时序集合(5.0 起的 timeseries collection)把这类分桶做成了内建能力,写入时自动分桶、自动压缩索引。新项目可以直接用它,代价是部分查询与索引能力受限;已有分桶实现迁移前要评估兼容性。自建分桶的价值在于完全可控,两者不是替代关系。
属性模式与字段漂移
属性模式针对的痛点在多 SKU 电商最典型:不同类目商品的字段完全不同(手机有内存、服装有尺码、图书有作者),要么字段无限膨胀,要么跨字段建索引建到手软。改成键值数组后,一个通用索引覆盖所有变体字段:
// 属性模式:变体字段统一为 k-v 数组 { sku: "P100", attrs: [ { k: "color", v: "黑" }, { k: "ram", v: "12G" } ] } db.products.createIndex({ "attrs.k": 1, "attrs.v": 1 }); // 查询改写:跨所有变体字段一次索引命中 db.products.find({ attrs: { $elemMatch: { k: "color", v: "黑" } } });
代价同样明确:单字段取值变啰嗦(要 $elemMatch)、无法直接对变体字段做范围排序、聚合要额外 unwind。字段种类多且查询以等值筛为主的场景赚,字段稳定且要复杂分析的场景亏——和所有模式一样,先看访问模式再上工具。
本节要点回顾
- 分桶对抗文档数爆炸,时序数据首选;
- 扩展引用/子集在往返次数与冗余间折中;
- $jsonSchema 把类型纪律(如金额 decimal)落到写入端;
- 校验先 warn 后 error,避免上线即拦截存量流量。