6.1 复制集原理与脑裂事故
6.1 复制集原理与脑裂事故
本节摘要:复制集由一个主节点与多个从节点组成,写操作只发生在主节点并记录到 oplog,从节点回放 oplog 保持一致;主节点失联时由多数派选举新主。本节从一次机房网络抖动导致的脑裂表现讲这套机制。
事故档案 12:一边能写,一边只读
三节点复制集跨两个机房部署(2+1)。机房间网络抖动 40 秒,少数派侧的 mongod 进入 SECONDARY 且 rs.status() 里主节点标记不可达;应用若连到少数派侧,全部写入被拒:
NotWritablePrimary: not primary
这不是脑裂造出两个主——MongoDB 的多数派原则不允许——而是少数派侧主动降级为只读以保数据一致。等网络恢复,旧主以从节点身份重新加入。真正的风险在于:抖动期间发生在旧主上、尚未同步到多数派的写入,会在恢复时被回滚(见 6.3)。
oplog:复制的载体
// oplog 是一个固定大小的集合 local.oplog.rs use local db.oplog.rs.findOne() // { ts: Timestamp(...), op: "i", ns: "orders.orders", o: { ... } } // 查看复制进度:从节点 lag rs.printSecondaryReplicationInfo();
oplog 是幂等操作流水,固定容量意味着只保留最近的窗口。窗口太短的经典事故:从节点下线维护两天,回来发现自己的同步点已被覆盖,只能全量重同步——所以 oplog 大小要按"最长可容忍离线时长 × 写入速率"规划。
心跳与选举常数
- 心跳每 2 秒一次,超过 10 秒未响应判定失联;
- 选举需要多数派节点同意(3 节点要 2 票,5 节点要 3 票);
- 因此偶数节点没有意义:4 节点容错能力与 3 节点相同,多数派都是最多挂 1 个。
一次故障转移的时间线
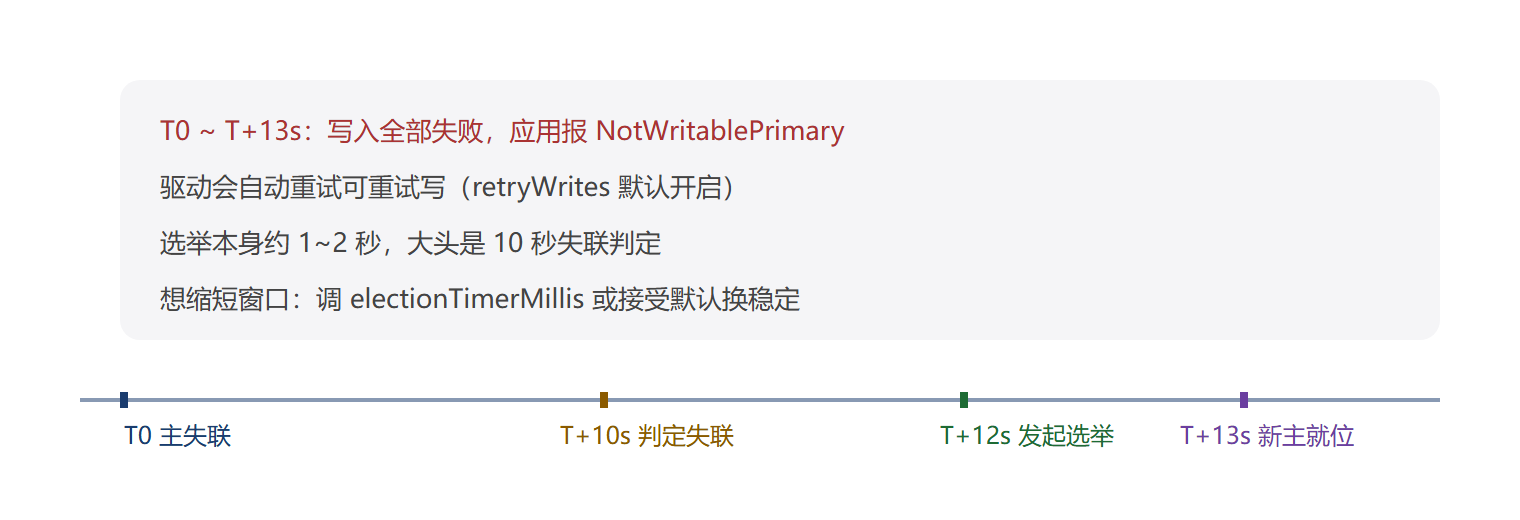
💡 高可用是"少数服从多数":部署时先问一句——拔掉任意一个机房,剩下的票数还过半吗?
事故复盘:四十秒网络抖动的三段式影响
把那次 40 秒抖动逐段拆开,能看清复制集的每个机制在什么时刻起作用。第 0 秒,机房间链路丢包,B 机房的两节点互相心跳正常、但收不到 A 机房主节点的心跳。第 10 秒,心跳超时阈值到达,B 机房侧(两票,多数派)发起选举,从两个从节点中选出新主;A 机房的旧主只握一票,无法当选也无法确认多数派存活,主动降级。第 10 到 40 秒,连接 A 侧的应用开始收到 NotWritablePrimary,驱动按默认 30 秒重试窗口自动发现新主并切流量——配置了 retryWrites 的驱动此时表现为短暂报错后自愈,没配置的老驱动则需要应用层重启才能恢复连接。第 40 秒网络恢复,旧主重新加入,对比自己的 oplog 与新主时间线,发现分叉点,把分叉后未同步的写入回滚出去(6.3 的主角)。
三个常被误解的点值得点破。第一,"脑裂"在这个协议下不会产生双主——降级是旧主的自我行为,不依赖外部仲裁。第二,降级瞬间到选举完成之间(默认十几秒)整个复制集不可写,这是设计出来的窗口,不是缺陷;应用侧的正确姿势是启用驱动的自动重试而不是手动干预。第三,读也受影响:默认 readPreference 是 primary,主没了读也一并失败,能把读切到从节点的配置(6.3 的表)可以让"只读模式"撑过选举窗口。
// 抖动期间在少数派侧看到的现场 rs.status().members.map(m => ({ name: m.name, state: m.stateStr, lastHeartbeat: m.lastHeartbeat })) // [ { name: "mongo-a", state: "(not reachable/healthy)" }, // { name: "mongo-b", state: "PRIMARY" }, { name: "mongo-c", state: "SECONDARY" } ] rs.hello().isWritablePrimary; // false —— 少数派侧只读的铁证
oplog 的工程细节
oplog 之所以能被从节点幂等回放,是因为它记录的不是语句而是"操作的最终形态":一次 $inc 被记录为设置后的绝对值,一次 updateMany 被拆成逐文档的更新。这带来一个重要推论:oplog 条目数与语句数不成正比,一条影响百万文档的更新会生成百万条 oplog——批量操作的真实复制成本按受影响文档数计,不按语句数计。第 2 章那种 deleteMany({}) 清库事故,在 oplog 里就是几百万条删除记录,从节点回放的 IO 压力与主库执行时同级。
use local db.oplog.rs.stats(); // 看 maxSize 与当前占用 // 粗估窗口时长:最早的 oplog 时间戳到现在 db.oplog.rs.find().sort({ $natural: 1 }).limit(1).next().ts; // 建议公式:可容忍从节点离线天数 × 每日写入增量 × 1.5 倍余量
另一个实操细节是 oplog 的调整只能在从节点上逐个执行(replSetResizeOplog),把三节点的窗口从 10GB 调到 50GB,正确顺序是先从后主,每步确认复制健康再继续。很多人在主节点上直接改而碰壁,报错信息并不直白。
选举窗口里的读策略
三段式复盘里提到的"只读模式撑过选举窗口"值得再展开半步。把 readPreference 设为 primaryPreferred 后,驱动在主可用时读主、选举期间自动落到从节点,应用表现为约十几秒的陈旧读而不是报错。要为这份陈旧付多大代价,取决于业务:商品浏览页可以接受,账户余额页不可以。 MongoDB 给了 maxStalenessSeconds 参数来量化这份陈旧——驱动会跳过落后超过阈值的从节点,宁可报错也不读太旧的数据。把它设得比预期选举窗口长一点(比如 120 秒),是既有高可用又不踩一致性红线的常见折中。
// 连接串里声明读偏好与陈旧度上限 // mongodb://app:secret@mongo-a,mongo-b,mongo-c/?replicaSet=rs0 // &readPreference=primaryPreferred&maxStalenessSeconds=120 db.getMongo().readPrefMode(); // 驱动侧确认当前读偏好生效
本节要点回顾
- 写只在主,从节点靠回放 oplog 追平;
- 多数派原则防双主,少数派侧只读;
- oplog 窗口决定从节点可离线多久,按维护窗口规划大小;
- 节点数用奇数,偶数不加容错只加成本。