6.2 复制集部署与选举异常事故
6.2 复制集部署与选举异常事故
本节摘要:复制集部署要规划节点数、跨机房分布与优先级;仲裁节点(Arbiter)只投票不存数据。本节从一次"同机房三节点同时失效"的事故讲部署要点与选举调优。
事故档案 13:三节点在同一机柜
创业公司把三节点复制集全放在同一机柜。机柜交换机故障,三节点同时失联,服务完全中断四十分钟。复制集的容错前提是故障域隔离——三个节点共享一个电源或交换机,等于没有冗余。
标准部署
# 三个节点各自启动 mongod,replSet 同名 mongod --replSet rs0 --port 27017 --dbpath /data/db --bind_ip 0.0.0.0
// 任一节点执行初始化 rs.initiate({ _id: "rs0", members: [ { _id: 0, host: "mongo-a:27017", priority: 2 }, // 常规主 { _id: 1, host: "mongo-b:27017", priority: 1 }, { _id: 2, host: "mongo-c:27017", priority: 1 } ] }); rs.status(); // 看 stateStr 与 health
部署清单:
- 节点跨机房/机柜/电源,拔掉任一故障域仍过半;
- hostname 而非 IP 配置 members,换机器不改配置;
- 优先级决定谁倾向当主,把主留在资源更好的机房;
- 监控
rs.printSecondaryReplicationInfo()的 lag。
仲裁节点:省钱的投票人
rs.addArb("mongo-arb:27017"); // 只存投票数据,不存业务数据
两数据节点 + 一个仲裁 = 三票,容错一节点且省一台全量机器。代价:仲裁没有数据,不能升级成从节点,也帮不上读流量。它适合预算紧张的边缘场景,不适合成长期业务——数据量一涨就得换回三数据节点,不如一步到位。
部署形态对比
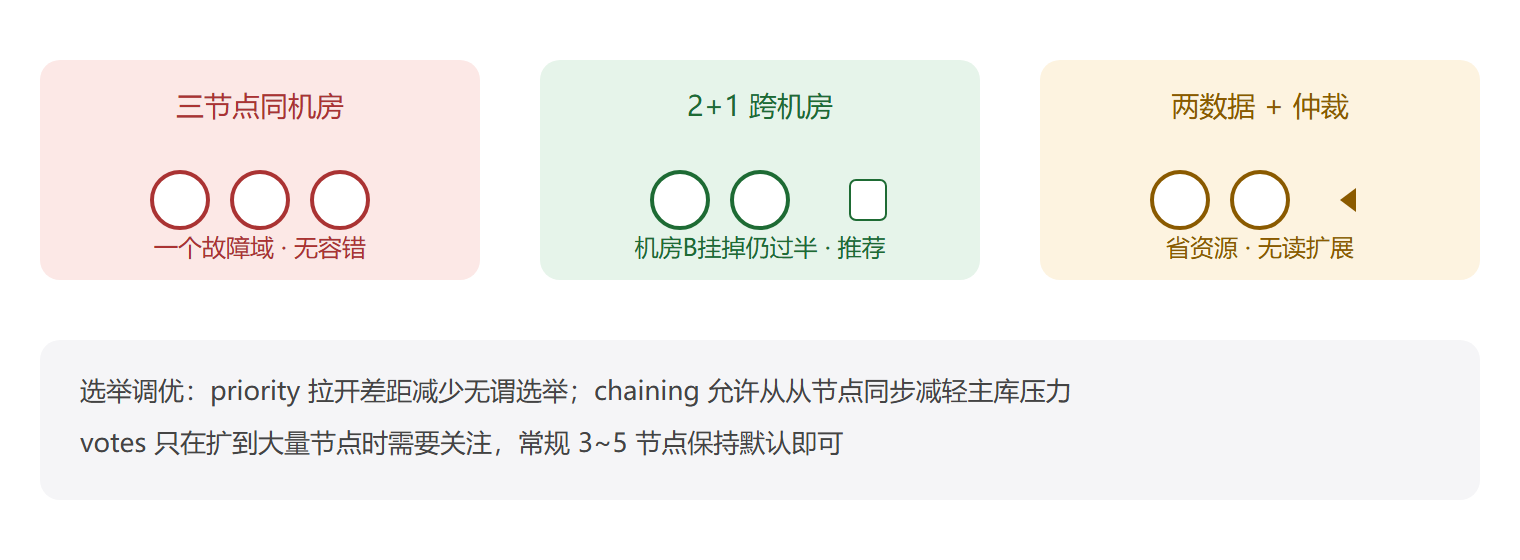
⚠️ 常见坑:为了"双机房各一半"把节点数配成 2+2。任何一侧失联都不过半,全局只读。跨机房永远配奇数票。
事故复盘:四十分钟里能做什么
机柜交换机故障后,三节点同时失联,应用全部读写失败。团队当时能做的只有两件事:把流量切到提前备好的单机应急实例(数据停在半小时前的备份),以及等机房把交换机换掉。复盘时算了一笔账:如果三节点分属两个机柜两个电源,这次故障最多是一次十几秒的选举;如果配了跨机房的延迟隐藏节点,至少读流量可以无感。事后重建部署时,他们选了三节点跨两机房(2+1),再加一个异地隐藏延迟节点做"后悔药"——这个形态也是中等规模业务的主流选择。
选举调优的实操部分展开讲三点。priority 设 0 的节点永远不参选,隐藏节点与延迟节点必须设 0,否则延迟节点可能带着旧数据当选,那是灾难;votes 只要是默认 1 就够,手工调 votes 的场景极少且容易出错。electionTimeoutMillis 默认 10 秒,调小能加快故障转移但容易在网络抖动时误触发选举(选举本身有开销,频繁误选比慢切换更伤);跨机房延迟高的环境反而可以适当调大。members 用 hostname 配置后,换机器就是"新机挂旧名"或一条 reconfig,不用改所有客户端的连接串——连接串里同样写 hostname,配合 DNS 轮换可以做到无感换机。
// 加一个延迟 1 小时的隐藏节点,专防误删类事故(回顾 2.2) rs.add({ _id: 3, host: "mongo-d:27017", priority: 0, hidden: true, secondaryDelaySecs: 3600 }); rs.conf().members[3]; // 确认配置生效 // 误删发生后:在延迟节点上把数据读出来,重放回主
延迟节点是第 2 章误删事故里"三层防线"的第一层落地:它比备份恢复快(不用 restore 全量),比 oplog 点恢复简单(数据就在一个活的节点上)。代价是它不服务读写、纯成本存在,通常只为最高价值的数据配。
部署自查清单
对照检查比背参数可靠:任意一个机柜、机房、电源被拔,剩余票数过半;所有 members 与连接串用 hostname;从节点复制延迟有告警(阈值建议 30 秒);oplog 窗口覆盖最长维护窗口;priority 0 只用于 hidden/delayed;每季度做一次真实的 kill -9 主节点演练——不演练的故障转移预案,等于没有预案。
第一次部署的完整会话
把部署要点串成一次可照抄的完整会话,比散落的片段更适合新手第一次上手。三台机器各自起 mongod 后,在第一台执行初始化,先只配自己一个成员,验证复制集成型,再把另外两台逐个加入——比起一次配三成员,分步初始化失败时更容易定位是哪台机器的网络或配置问题。
// 第一步:单成员初始化,等 stateStr 变成 PRIMARY rs.initiate({ _id: "rs0", members: [{ _id: 0, host: "mongo-a:27017" }] }); rs.status().members[0].stateStr; // PRIMARY // 第二步:逐台加入,每加一台确认复制健康 rs.add("mongo-b:27017"); rs.printSecondaryReplicationInfo(); rs.add("mongo-c:27017"); rs.printSecondaryReplicationInfo(); // 第三步(可选):把常规主的倾向调出来 var c = rs.conf(); c.members[0].priority = 2; rs.reconfig(c);
初始化完成后必须做的两项验证:在主上写入一条探针文档,到两个从节点上 secondary 读得到它,确认复制链路真实工作;把主节点进程 kill 掉,观察十几秒内自动选举、应用连接自愈,然后拉起旧主看它以从节点身份回归。这两项验证十分钟做完,覆盖了复制集九成的日常故障形态,比任何文档都直观。
本节要点回顾
- 故障域隔离是复制集容错的前提;
- priority 引导主节点位置,hostname 配置便于换机;
- 仲裁只投票不存数据,是省钱选项不是默认选项;
- 偶数节点无意义,跨机房要保证任意一侧失联仍过半。