7.1 分片架构与热点分片事故
7.1 分片架构与热点分片事故
本节摘要:分片集群由 mongos 路由层、config 配置服务器和若干分片(各为复制集)组成;数据按分片键划分成 chunk 分布在各分片。本节从一次热点分片事故讲三层架构与寻址过程。
事故档案 15:三个分片,一个在燃烧
社交平台用 {createTime: 1} 范围分片。所有新写入都落在时间最大的一段 chunk——只有最后一个分片在接写,另两个分片闲置。热点分片 CPU 90%,其余躺平,扩容花了三倍钱买不到一分性能。
根因:单调递增的范围键让写入永远追着"最右边"的 chunk 跑。两个解法:
// 解法一:哈希分片,写入均匀打散 sh.shardCollection("social.feeds", { ownerId: "hashed" }) // 解法二:复合键,高基数字段打头 sh.shardCollection("social.feeds", { ownerId: 1, createTime: -1 })
三层架构各司其职
- mongos:无状态路由。应用只连 mongos,它查 config 的路由表,把请求发往目标分片;不带分片键的 scatter-gather 查询会被发到全部分片再归并。
- config server:存集群元数据(chunk 分布、分片列表),本身是一个三节点复制集,是集群的大脑,要最高规格保护。
- shard:真正存数据的复制集。
// 查看数据分布:是否热点一目了然 sh.status(); db.feeds.getShardDistribution(); // 各分片的文档数与体积
查询的两条路径
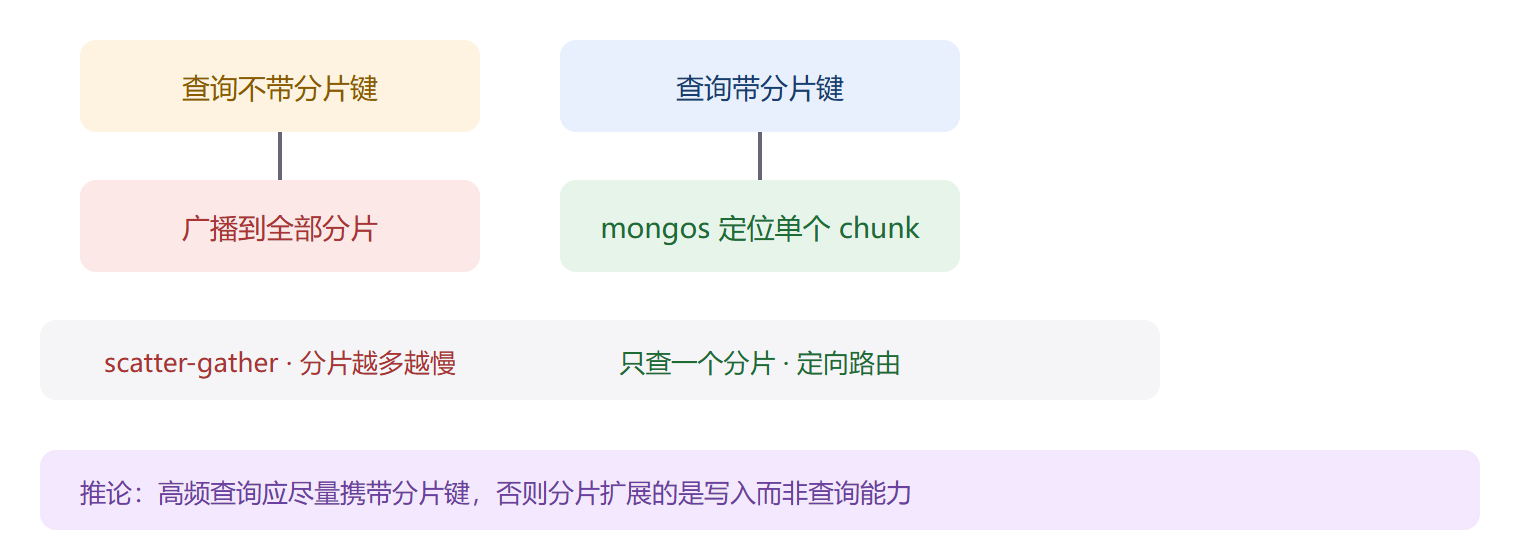
⚠️ 常见坑:指望分片自动加速所有查询。分片只对带分片键的查询做定向路由;不带键的查询每加一个分片就多一次全分片广播。
事故复盘:三倍的钱买不到性能
这次事故的讽刺之处在于扩容初衷是性能,结果性能反而恶化。扩容前两个分片,热点分片 CPU 约 70%;扩到三个分片后,写入仍全部落在时间最大的 chunk 所在的分片,热点没分到任何新流量,而 balancer 感知到新分片空闲、开始把旧数据往新分片搬——迁移流量又叠在热点分片上,CPU 冲到 90%。也就是说扩容当天,集群做了三件事:买新机器、热点照旧、还多背了搬迁负载。
定位过程很短,sh.status() 的 chunk 分布表上一眼就能看到最后一个 chunk 的体积是其他 chunk 的数十倍,db.feeds.getShardDistribution() 确认三个分片的写入比例是 49:49:2。真正花时间的是选整改方案。哈希 ownerId 能救写入分布,但产品核心查询"关注的人的最新动态"带的是 ownerId 等值加时间范围——哈希化后 ownerId 等值仍可定向路由(哈希键支持等值),范围部分在分片内完成,可接受;复合范围键 ownerId 加 createTime 同样定向,且保留时间局部性。团队最终选了复合键,理由是集合上有按时间的历史归档任务,范围键让归档总是落在连续 chunk 上。
// 整改观察:写入分布应趋于均匀 db.feeds.getShardDistribution(); // Shard rs0 { count: 6704123 } Shard rs1 { count: 6698801 } Shard rs2 { count: 6701204 } // 三分片写入比从 49:49:2 修复到 33:33:33
scatter-gather 的真实账单
不带分片键的查询被 mongos 广播到全部分片,这话说得轻巧,账单要算细。每个分片各自执行查询并返回 Top-N 给 mongos 归并,代价等于"最慢分片的延迟 × 分片数份的资源";sort 加 limit 的查询无法在分片间提前截断(limit 20 会放大成分片各查 20 条再归并,这尚可),但深分页广播是灾难(每分片扫十万条)。经验数字:广播查询的延迟通常是最优路由查询的 2 到 4 倍,随分片数线性恶化。所以分片键设计的第一条军规其实是——让最高频的查询全部携带分片键,其次才是写入分布。
读偏好与路由的关系也值得一提:mongos 层面同样可以设置从分片的从节点读(secondaryPreferred 路由到各分片的从节点),把报表类广播查询赶到从节点,能显著降低对主链路的影响,这是第 6 章 readPreference 在分片场景的自然延伸。
// 定向 vs 广播:explain 一看便知 db.feeds.find({ ownerId: "u88" }).explain().queryPlanner.winningPlan.shards // 1 个 shard —— 定向路由 db.feeds.find({ content: /六六六/ }).explain().queryPlanner.winningPlan.shards // 3 个 shard —— 广播,每分片一次正则扫描
三层组件的故障画像
记住架构的另一个办法是记住每层挂掉时的样子。mongos 无状态,挂一台应用侧表现为部分连接报错,驱动重连其他 mongos 即自愈,所以生产至少两台并与应用同机房部署。config server 是单点大脑:三节点复制集若多数派失联,整个集群进入只读——所有元数据操作(分裂、迁移、建索引的协调)全部停摆,但已建立路由的读写仍可继续,这解释了为什么 config 值得最高规格的机器。单个 shard 故障则表现为该分片上的请求失败,带分片键的查询按命中分片决定成败,广播查询部分成功部分失败,驱动返回的是聚合后的错误。把这张故障画像贴在值班室,比架构图更能救命。
# 三层健康各一条命令 mongosh --host mongos-a --quiet --eval 'db.adminCommand({ ping: 1 }).ok' mongosh --host mongos-a --quiet --eval 'sh.status().configsvrConnectionString' mongosh --host mongos-a --quiet --eval 'db.getSiblingDB("admin").runCommand({ listShards: 1 }).shards.length'
本节要点回顾
- mongos 路由 + config 记账 + shard 存数据,config 是大脑;
- 单调递增范围键 = 永久热点,写入只打一个分片;
- 哈希键救写入分布,代价是范围查询失去局部性;
- 不带分片键的查询走广播,分片越多越贵。