8.1 ACID与事务实现事故
8.1 ACID 与事务实现事故
本节摘要:MongoDB 多文档事务基于快照隔离,提交时以一条原子 oplog 记录落多数派,从而在复制集上实现 ACID。本节从一次事务超时连环回滚的事故讲实现机理与硬限制。
事故档案 18:转圈的重试
积分系统在事务里先查再算再写,中间夹了一次外部 HTTP 调用。外部服务一抖,事务超过默认 60 秒:
TransientTransactionError: Transaction exceeded 60 seconds...
驱动不断重试,每次都重新走一遍慢调用,形成"超时-重试-再超时"的死循环,锁与快照越积越多。两个错误:事务里做了外部 IO、重试的是同一个注定超时的逻辑。
实现机理一页纸
- 开启:事务拿到一个全库快照,此后读的都是这个时点视图(快照隔离);
- 执行:写操作暂存在事务私有视图,对并发读者不可见;
- 提交:所有写打包成一条 oplog 条目原子应用,配合 w:"majority" 落多数派——要么全部生效,要么全部不生效;
- 冲突:两个并发事务改同一文档,后提交者检测到写冲突,被整体中止。
// 正确姿势:短事务 + 显式关注点 + 有限重试 const session = db.getMongo().startSession(); for (let i = 0; i < 3; i++) { session.startTransaction({ writeConcern: { w: "majority" }, maxCommitTimeMS: 5000 }); try { const coll = session.getDatabase("points").user_points; coll.updateOne({ uid: "u42" }, { $inc: { balance: -100 } }); session.getDatabase("points").ledger.insertOne({ uid: "u42", delta: -100 }); session.commitTransaction(); break; } catch (e) { session.abortTransaction(); // 指数退避,且必须是 TransientTransactionError 才值得重试 } }
事务生命周期与红线
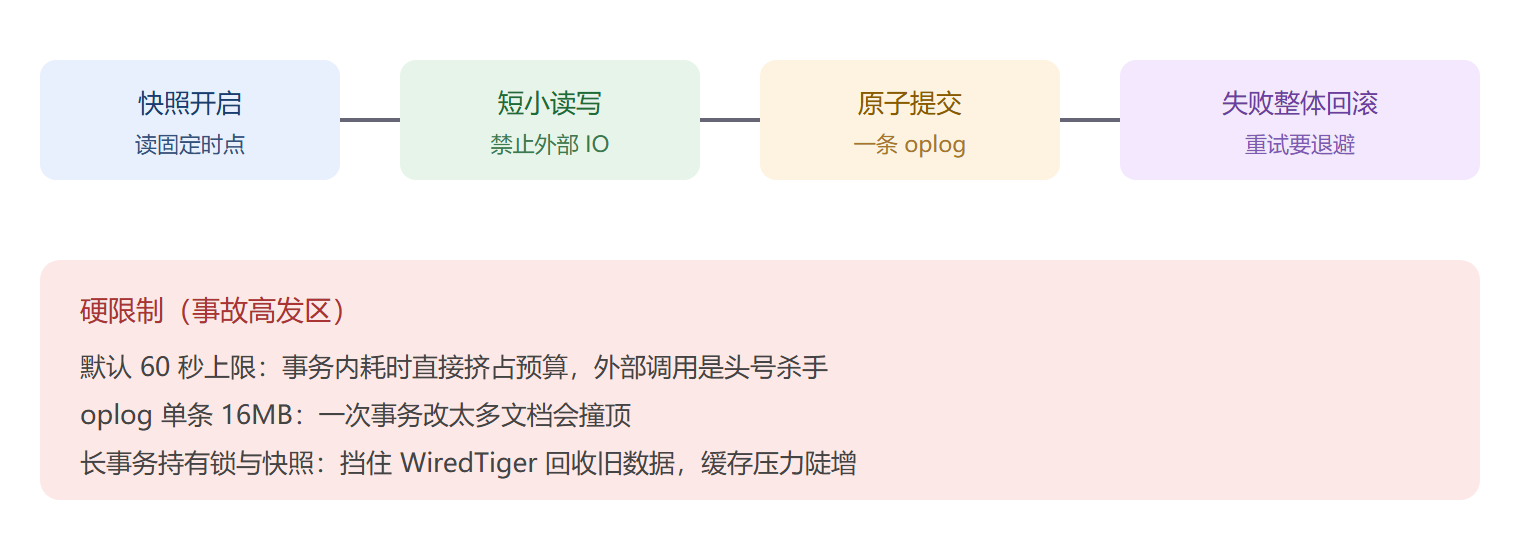
💡 事务时间预算里只该有数据库操作。凡是能在事务外做的查询与计算,全部挪出去。
事故复盘的完整六小时
把积分系统那次事故的六小时完整摊开。晚八点高峰开始,积分服务 P99 延迟从 40 毫秒爬到 2 秒,报警群里最先出现的是应用侧的 TransientTransactionError 堆栈。值班工程师第一反应查复制延迟,正常;查慢查询,也没有——事务里的语句在 profiler 里各自都很快,慢的是"事务整体持有时长"。切换思路看事务视图:db.currentOp 里挂着几十个 activeTransaction,每个的 transaction.parameters 已运行上千秒的时钟时间没有,但 dateStarted 与当前时间一减,普遍超过 40 秒,最长的 58 秒——离 60 秒红线一步之遥。
// 用 currentOp 看事务现场:谁在开着长事务 db.getSiblingDB("admin").aggregate([ { $currentOp: { allUsers: true, idleConnections: false } }, { $match: { "transaction.parameters.txnNumber": { $exists: true } } }, { $project: { client: 1, secs_running: 1, "transaction.parameters.startTime": 1 } } ]); // 输出示例:{ client: "10.2.3.14", secs_running: 57, ... } ← 濒临红线 db.killOp(opid); // 对已失控的长事务,果断杀掉让它重开
根因在代码层:事务块里夹着一次风控 HTTP 调用,超时设置 30 秒,外部服务抖动时事务必然逼近 60 秒。更糟的是驱动的重试封装没区分错误类别,UnknownTransactionCommitResult 和 TransientTransactionError 一律整单重试,而重试又从头走一遍那个慢调用——于是雪球滚起来。修复分三刀:外部调用挪到事务前,事务体只剩两次写;重试封装改为只重试可重试错误并加指数退避;maxCommitTimeMS 显式设为 5 秒,宁可快速失败也不拖满默认上限。上线后冲突率从百分之七掉到千分之一以下。
红线与参数速查
| 限制 | 默认值 | 含义与调法 |
|---|---|---|
| transactionLifetimeLimitSeconds | 60 | 事务最长存活时间,超时由后台清理线程中止 |
| maxCommitTimeMS | 无 | 单次提交的时间预算,应用侧自保定 |
| 16MB oplog 条目 | 硬顶 | 事务全部写打包成一条 oplog,超顶即 Abort |
| oplog 视图保留窗口 | 依赖 oplog 大小 | 长事务的快照读依赖 oplog,窗口不够会 NoSuchTransaction |
16MB 这条红线常以意料之外的方式命中:一个事务里批量插入几十万行,任何一条语句都没超限,但提交时打包的 oplog 条目超了,错误抛在 commit 而不是 insert,排查时极易误导。批量写入的正确姿势是分批提交,每批控制在一个保守的体量。
另一个值得记住的行为差异:事务里的读默认走快照,读到的数据可能是事务开始时刻的旧值;若业务需要"读到最新再决定写什么",得用 writeConcern 与合适的读关注组合,或干脆把这次决策性读挪到事务外先做。理解"快照是隔离的来源,也是陈旧的来源"这句话,事务里八成的诡异现象都能解释。
本节要点回顾
- 快照隔离 + 单条 oplog 提交是 ACID 的实现底座;
- 60 秒与 16MB 是最常撞的两条红线;
- 外部 IO 不进事务;
- 重试要识别可重试错误并退避,盲目重试等于放大事故。