8.2 事务场景与滥用事故
8.2 事务场景与滥用事故
本节摘要:MongoDB 的一致性工具箱有三层——单文档原子性、建模规避、多文档事务;事务是最后手段。本节从一次"全表流程事务化"的性能事故讲三层决策与典型场景。
事故档案 19:什么都用事务
团队从关系库迁移过来,把"下单-扣库存-记流水-发券"整条链路包进一个大事务,还嵌套了三段业务校验。高峰期事务冲突率飙升,大量订单因写冲突被中止重试,吞吐量反而低于迁移前的关系库。复盘:四个写操作里只有一个真正需要跨文档原子性。
一致性工具箱的三层
// 第一层:单文档原子性——免费的午餐 // 一条 updateOne 的操作符天然原子,多个字段一起生效 db.inventory.updateOne( { sku: "S1", stock: { $gte: 3 } }, // 条件即校验,防超卖 { $inc: { stock: -3 }, $set: { holdBy: "o100" } } ); // 第二层:建模规避——把"必须一起变"的数据放进同一个文档 db.orders.insertOne({ orderId: "o100", items: [ { sku: "S1", qty: 3 } ], status: "paid" }); // 订单与商品行同生共死,无需事务 // 第三层:多文档事务——确有跨集合原子需求时才上
决策阶梯
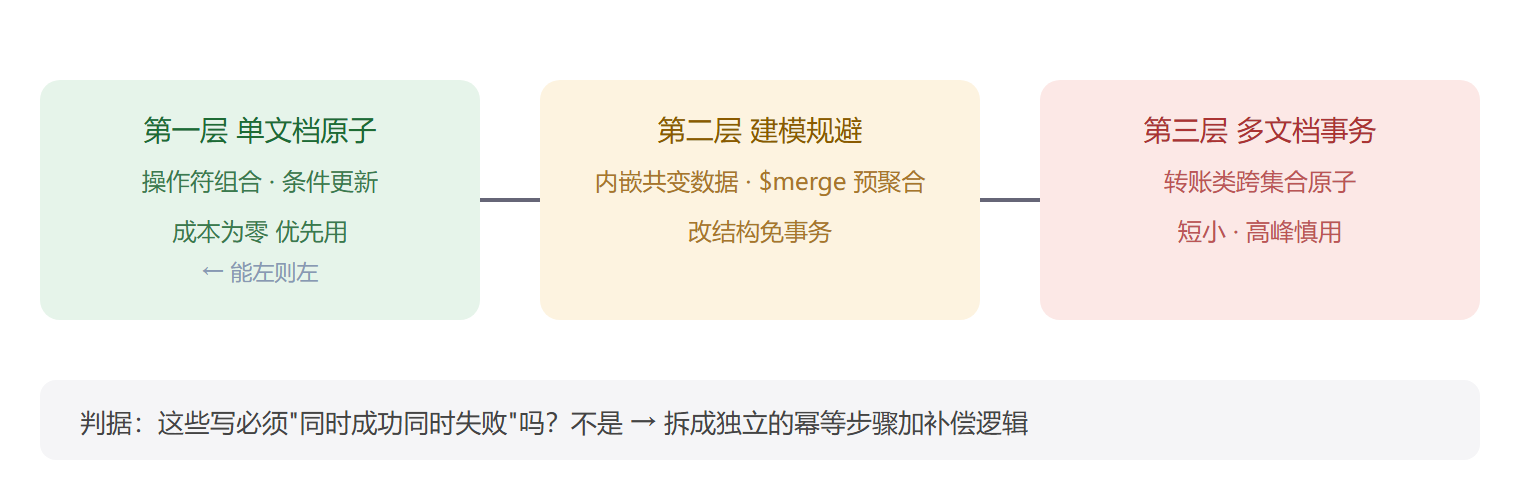
真正适合事务的场景
- 余额/积分转账:两个账户文档必须对称变化;
- 票务/座位:占用与订单创建需原子;
- 双写迁移期:新旧集合切换窗口的一致性。
且这些场景的共同点是事务体极小(几次读写、毫秒级)。下单链路那种长流程的正确做法是拆步骤:每步幂等、失败补偿,而不是一个大事务包圆。
⚠️ 分片集群上的事务要求访问的分片键路由明确,跨大量分片的事务成本显著上升。事务也要"局部性"——这也是 7.3 选键判据的延伸。
事故复盘:吞吐是怎么被事务吃掉的
滥用事故的数字值得留档。迁移后的下单接口压测:单文档原子写版本吞吐 4200 TPS,大事务版本 610 TPS,差七倍。三个因素叠加:事务对涉及文档加意向锁,热门商品文档成为全局瓶颈,并发全部排队;写冲突被中止后整单重来,高峰期冲突率百分之十八,相当于五分之一的订单做了两遍;事务持有快照期间 oplog 不能被清,写入高峰时段 oplog 窗口被压缩,从节点一次维护就触发全量重同步。一次"顺手包个事务",三个账单一起来。
正确的下单链路:拆步骤、幂等、补偿
四步链路里只有扣库存需要原子性,用单文档条件更新就够;其余步骤用状态机加幂等键串起来,每步落库、失败重试或补偿。订单文档上的 status 字段是状态机的载体,steps 数组记录每步的执行结果,任何一步重复执行都先查步骤记录——这就是幂等。
// 步骤一:创建订单(幂等键防重复下单) db.orders.insertOne({ _id: "o100", uid: "u42", status: "created", steps: { stock: "pending", ledger: "pending", coupon: "pending" }, idempotencyKey: "cart-88-u42" }); // 若 _id 冲突(重复请求),insert 报 DuplicateKey,直接返回已有订单 // 步骤二:扣库存——单文档原子,条件即校验 const r = db.inventory.updateOne( { sku: "S1", stock: { $gte: 3 } }, { $inc: { stock: -3 }, $set: { "steps.stock": "done" } }); // r.modifiedCount === 0 说明库存不足或并发抢先,走取消补偿 // 步骤三与四:记流水、发券——各自独立写,失败由对账任务补偿 db.ledger.insertOne({ orderId: "o100", delta: -3, ts: ISODate() }); db.orders.updateOne({ _id: "o100" }, { $set: { status: "paid" } });
补偿不等于回滚 SQL:发券失败时,对账任务发现 steps.coupon 仍是 pending,补发或标记人工处理。整套链路没有一处多文档事务,但每一步都可重入、可对账——这正是第 5 章"用建模消灭事务需求"的实战版。真正上事务的只剩一种残余场景:转账类两个文档必须对称变化,此时事务体控制在两次写以内,毫秒级提交。
| 场景 | 工具箱选择 | 理由 |
|---|---|---|
| 下单扣库存 | 单文档条件更新 | 条件即校验,天然原子 |
| 订单与商品行 | 内嵌建模 | 同生共死,见第 5 章 |
| 积分转账 | 多文档事务 | 两个文档对称变化,事务体极小 |
| 双写迁移窗口 | 多文档事务或幂等对账 | 一致性要求高、期限有限 |
| 长流程编排 | 状态机加补偿 | 事务超时红线撑不住长流程 |
识别滥用的事后体检
怎么在下一个事故前发现"事务正在被滥用"?三个信号足够。一是事务平均持有时长:serverStatus 的 metrics.transactions 里 currentActive 与 commit 的时间统计,平均超过 100 毫秒就该翻代码了。二是冲突率:TransactionsExpiredAbortedCount 或应用侧重试计数持续非零,说明并发写热点正被事务放大。三是事务体里语句数:日志里 transaction 的 ops 数长期大于五,多半是把流程编排塞进了原子性边界。把这三项做成月度体检表,滥用会在压测阶段暴露,而不是高峰期。
db.serverStatus().metrics.transactions; // 重点看:currentActive、commitTotalDurationMillis 的分布、 // 以及 retriedCommandsCount —— 重试命令数飙升是冲突风暴的前兆
还有一个纯粹的经验数字可以挂在工位上:事务里读写操作合计超过五次,先停下来画一遍数据流,通常能发现其中一半的操作本可以挪到事务外或用建模合并。事务体的大小与正确性无关,但与你的吞吐量成反比。
本节要点回顾
- 三层工具箱:单文档原子 → 建模规避 → 多文档事务,能左则左;
- 事务体要小,只包真正需要原子性的写;
- 长流程用幂等加补偿,不用大事务;
- 分片上的事务讲局部性,跨分片越少越好。