10.1 监控指标与缓存驱逐事故
10.1 监控指标与缓存驱逐事故
本节摘要:MongoDB 性能的第一现场在 WiredTiger 缓存:工作集超过缓存时发生频繁驱逐,延迟随之雪崩。本节从一次缓存驱逐事故讲核心监控指标、告警阈值与快速现场工具。
事故档案 22:每周三下午的延迟尖刺
业务每周三跑全量报表,之后 P99 延迟从 5ms 涨到 300ms 持续两小时。CPU、磁盘都不满,看似无解。serverStatus 揭晓:
db.serverStatus().wiredTiger.cache // "bytes currently in the cache" : 接近 max // "pages evicted from cache" : 平时每秒几十,尖刺期每秒上万 // "tracked dirty bytes in the cache" : 高位
报表扫描把业务工作集挤出了缓存,之后每次读写都要走磁盘,驱逐风暴就是延迟尖刺的本体。解法:报表读走从库(readPreference)、加大缓存、报表分批。
必看指标与阈值
| 指标 | 位置 | 告警参考 |
|---|---|---|
| cache used / max | serverStatus.wiredTiger.cache | 持续 > 95% |
| pages evicted | 同上 | 突增 10 倍于基线 |
| dirty bytes | 同上 | > 20% of cache |
| connections current | serverStatus.connections | > max 的 80% |
| opLatencies reads/writes | serverStatus.opLatencies | P99 突增 3 倍 |
| replication lag | rs.printSecondaryReplicationInfo | > 10s |
| queues read/write | mongostat qr | qw |
延迟雪崩的形成链
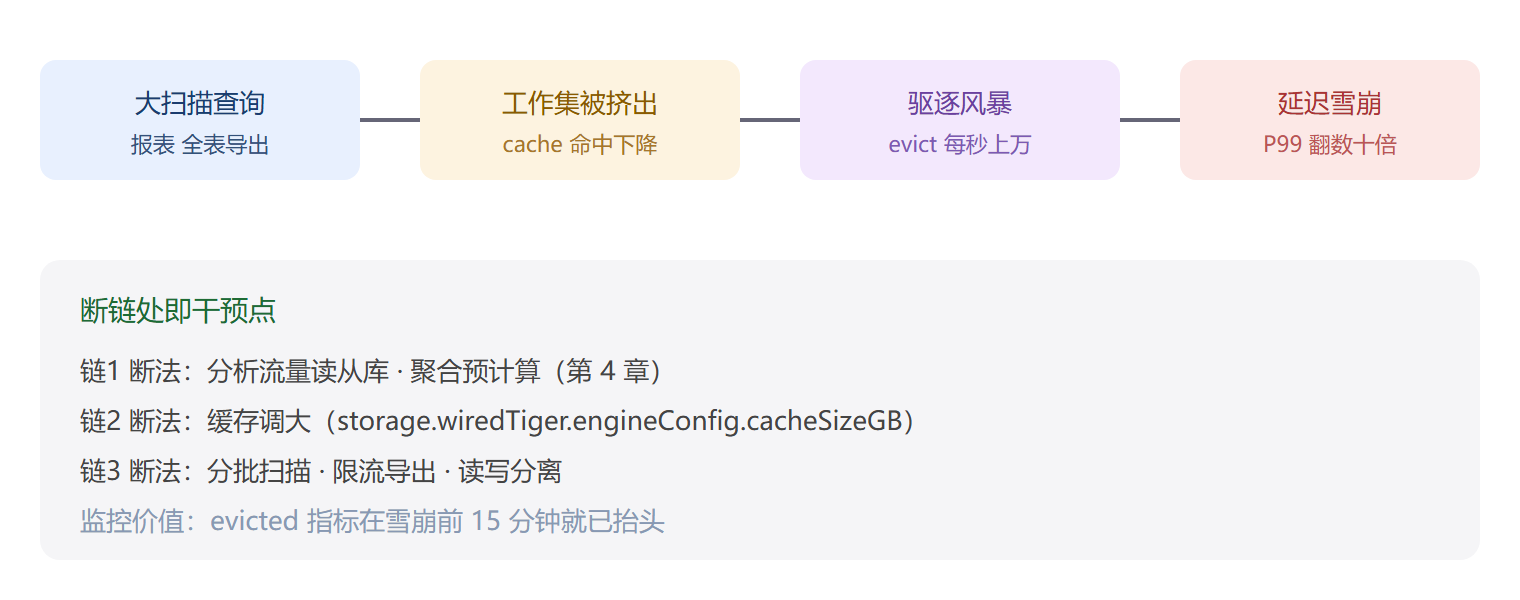
现场快照工具
# mongostat:一屏看全局——插入/查询/更新/删除、队列、缓存命中率 mongostat --uri "mongodb://tradeApp@mongo-a:27017" 5 # mongotop:哪个集合在吃读写时间 mongotop --uri "..." 5
⚠️ 常见坑:只盯 CPU 和磁盘。MongoDB 的病多半先体现在缓存驱逐与队列上,这两项在常规主机监控里根本看不到。
事故复盘:周三尖刺的三轮定位
这起事故值得完整复盘,因为它的定位走了三轮弯路。第一轮按直觉查 CPU:尖刺期 CPU 只有 40%,排除;第二轮查磁盘,IOPS 与吞吐都在水位内,再排除。两轮排除之后才有人想起看 serverStatus——第三轮命中。事后总结,前两轮浪费的四十分钟源于监控面板的布局:CPU、内存、磁盘放在首屏,数据库自己的缓存与队列指标藏在二级页面,而 MongoDB 的病恰恰先体现在后者。这个教训直接改成了动作:把缓存占用、驱逐速率、读写队列三个指标提到首屏,任何一台 mongod 的面板都按这个顺序排。
// 五分钟现场快照脚本:一次抓齐六个关键读数 const s = db.serverStatus(); const c = s.wiredTiger.cache; print("cache%=" + (c["bytes currently in the cache"] / c["maximum bytes configured"] * 100).toFixed(1)); print("dirty%=" + (c["tracked dirty bytes in the cache"] / c["maximum bytes configured"] * 100).toFixed(1)); print("evict/s≈" + (c["pages evicted by app thread"] + c["pages evicted by server"]); print("conn=" + s.connections.current + "/" + s.connections.available); print("qr|qw=" + s.globalLock.currentQueue.readers + "|" + s.globalLock.currentQueue.writers); // 尖刺期典型输出:cache%=96.8 dirty%=24 evict/s≈12000 —— 驱逐风暴实锤
修复的三板斧也按性价比排序讲清楚。最便宜的一招是 readPreference 把报表流量赶到从库,当天生效,主库 P99 立刻回落——代价是从库白天多了负载,报表时长从四小时变五小时,业务可接受。第二招加大缓存,把 cacheSizeGB 从默认的一半内存上调到六成,给工作集留余量,需要低峰滚动重启。第三招是治本:按天预聚合报表中间表(第 4 章 $merge 的用法),全量扫描从每周三一次变成每天凌晨一次小扫描,尖刺从此消失。三招合起来的启示是:驱逐事故的解法在"减少不该进缓存的数据",不在"加更大的缓存"这一条路上。
阈值的来源与调法
表里的阈值不是教条,给出推导逻辑:cache 95% 告警,因为 WiredTiger 在逼近上限时驱逐策略从后台清理转为应用线程同步清理,延迟直接受累,95% 正是策略切换的地带;dirty 20% 的依据是脏页触发检查点与驱逐的联动水位;队列只要持续非零就说明供不应求,它是最灵敏也最不该被忽略的指标。每个环境的合理值不同,正确做法是先采两周基线,再把告警阈值定为基线的三倍或策略切换点取低者。抄来的阈值要么从不触发、要么天天误报,两种都会让告警体系失去信誉。
两个反直觉的观察
驱逐事故里有两个反直觉现象,提前知道能少走弯路。其一,加内存不一定救得了:如果工作集真的大于任何可配的缓存,加内存只是把雪崩推迟,正确出路是第 4 章的预聚合或第 7 章的拆分。其二,重启能让症状立刻消失,因此极容易误判为已修复——重启只是把缓存清空后重新预热,下周三同样的扫描一来,尖刺准时回归。把这两条贴在值班手册里,能挡住一半的无效处置。
本节要点回顾
- 工作集 > 缓存 = 驱逐 = 延迟雪崩,三大信号:cache 占用、evicted、dirty;
- 队列与连接数是第二梯队必看项;
- 报表读从库加预聚合,把分析流量与交易流量隔开;
- mongostat/mongotop 是到场五分钟内建立全局观的两件工具。