10.2 慢查询分析与索引失效事故
10.2 慢查询分析与索引失效事故
本节摘要:慢查询定位的标准链路是 profiler 或日志抓语句、explain 看计划、索引与建模改造、回归验证。本节从一次"优化后又复发"的事故讲完整闭环与常见根因清单。
事故档案 23:治好又复发的慢查询
订单列表页慢,DBA 加了复合索引,一周后又慢回来。profiler 抓到真凶:
// 开启 profiler:记录超过 100ms 的操作 db.setProfilingLevel(1, { slowms: 100 }) db.system.profile.find().sort({ ts: -1 }).limit(3) // 抓到的语句 { op: "query", ns: "trade.orders", millis: 950, command: { find: "orders", filter: { buyerId: "u88", status: { $ne: "closed" } } } }
explain 显示 COLLSCAN——索引确实存在,但 $ne 让计划器放弃了它,且开发上周把过滤条件从 status in paid,shipped 改成了 not closed。同一个页面,换了种写法,绕开了索引。
定位闭环四步
// ① 抓:profiler 或日志 slowms db.setProfilingLevel(1, { slowms: 100 }); // ② 看:explain 三问 db.orders.find({ buyerId: "u88" }).sort({ createdAt: -1 }).explain("executionStats") // 一问 stage 是 IXSCAN 还是 COLLSCAN // 二问 keysExamined 与 nReturned 差多少倍 // 三问有没有 scanAndOrder(内存排序) // ③ 改:条件等价改写,消极条件换积极条件 // status $ne closed → status $in [paid, shipped, ...] // ④ 验:观察 profiler 同语句耗时分布回归正常
慢查询根因对照
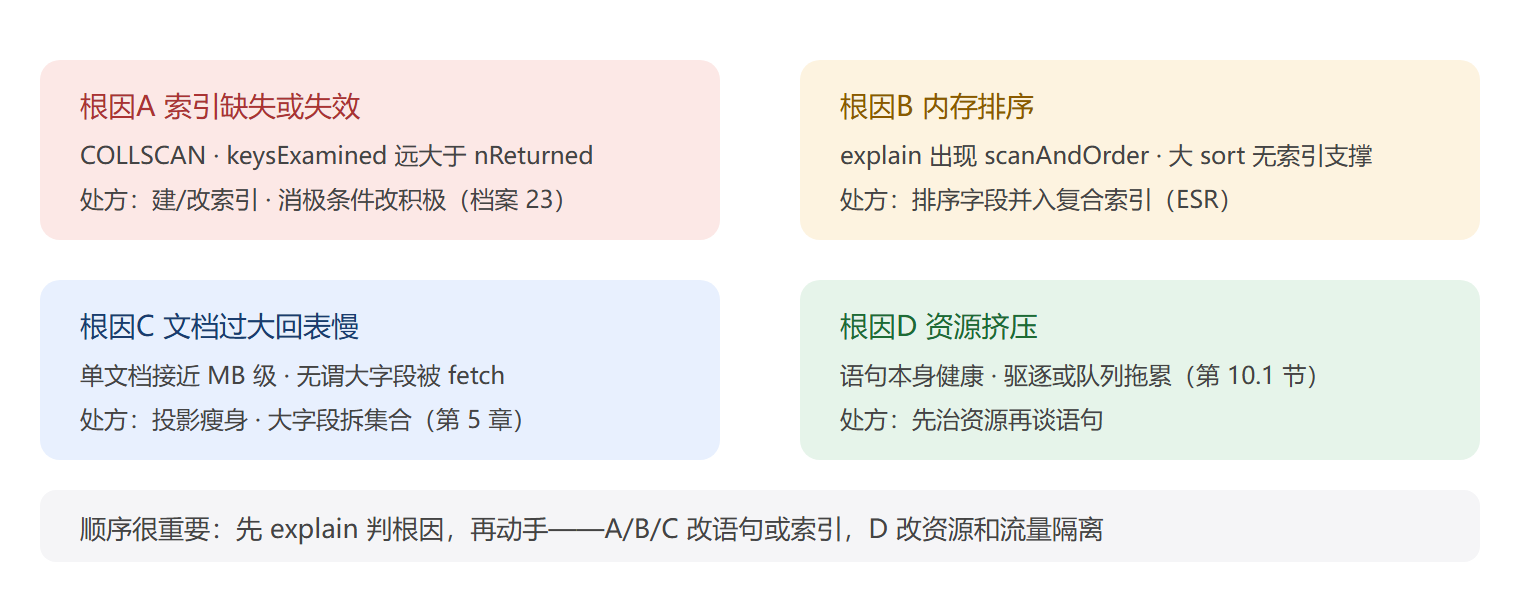
💡 把 profiler 的 slowms 长期设在 100ms 当"体温计",慢查询趋势图比任何单次救火都有价值。注意 profile 集合本身有开销,生产上常用日志方式(慢查询写进 mongod 日志)替代。
事故复盘:复发比首犯更值得复盘
首犯那次修复其实很规范:加复合索引 {buyerId: 1, createdAt: -1},验证通过,关闭工单。复发暴露的是流程漏洞——修复后没有沉淀"这个页面的查询长什么样"的基线,一周后开发改写过滤条件,没人知道索引已经被绕开。整改动作有两个:一是给核心接口建立查询画像,explain 的关键读数(stage、keysExamined 与 nReturned 比值)入库,每天巡检对比,计划从 IXSCAN 漂移到 COLLSCAN 当天就能发现;二是把"改过滤条件"纳入变更评审,枚举值变更时同步检查索引覆盖。技术修复十四天,流程补丁才是让事故不再回来的那一半。
// 查询画像的最小实现:核心语句每日跑一次 explain,读数入库 const st = db.orders.find({ buyerId: "u88", status: { $in: ["paid","shipped"] } }) .sort({ createdAt: -1 }).explain("executionStats").executionStats; db.query_baseline.insertOne({ day: new Date(), stage: st.executionStages.stage, ratio: (st.totalKeysExamined / st.nReturned).toFixed(1), millis: st.executionTimeMillis }); // ratio 从 1.2 漂到 999 意味着索引被绕开,告警
失效写法清单与改写对照
把高频失效写法连同改写列成对照表,评审时直接对号入座:
| 原写法 | 为什么失效 | 改写 |
|---|---|---|
| status ne closed | 否定条件无法走索引区间 | 改 in 积极枚举 | ||
| userId 字符串 vs 数字 | 隐式类型转换放弃索引 | 写入侧统一类型 |
| /^abc/ 正则前缀通配 | 前缀不定无法定位 | 后缀通配改前缀匹配 |
| find 后 sort 无索引 | 内存排序 scanAndOrder | 排序键并入复合索引 |
| where / regex 大表 | 逐文档执行脚本 | 改可索引操作符 |
最后一条排错经验:慢查询不全是索引问题。队列堆积时再好的索引也白搭,磁盘打满时一切皆慢。所以动手前先看 10.1 的三个指标确认不是资源性慢——先判根因再动手,是两节合起来的第一原则。
一个真实的一小时排错会话
把闭环串成一次可对照的完整会话。工单:支付回调接口 P99 八百毫秒。第 0 到 10 分钟看面板:缓存 78%、队列 read 3 持续、连接正常——轻度排队,不是驱逐,判断为计划性慢。第 10 到 25 分钟开 profiler 抓语句,命中 update 语句 filter 是 {orderNo: 1}(数字类型),而集合里 orderNo 存的是字符串,planSummary 显示 COLLSCAN 且 docsExamined 是全表。第 25 到 40 分钟与开发核对:新上线的回调服务把订单号parseInt 后传入,隐式类型不匹配绕开了 orderNo 上的唯一索引。修复是驱动侧去掉类型转换,改回字符串传参。
// 会话里的关键一步:profiler 记录里直接给了计划摘要 db.system.profile.find({ op: "update", millis: { $gt: 500 } }) .sort({ ts: -1 }).limit(1).pretty(); // planSummary: "COLLSCAN" docsExamined: 8123456 —— 全表更新扫描,实锤 // 修复后同语句:planSummary: "IXSCAN{ orderNo: 1 }" millis: 3
第 40 到 60 分钟做两件收尾:把修复版本上线并观察 profiler 分布回归个位数毫秒;给查询画像补上这条语句,并在失效清单的隐式类型一栏记下这个案例。一小时里真正花在"改"上的只有一行代码,其余时间都在证明该改哪一行——这就是慢查询分析的真实节奏。
本节要点回顾
- 四步闭环:抓语句 → explain 三问 → 改写/索引 → 回归验证;
- 消极条件(ne/nin)常绕开索引,优先改积极枚举;
- scanAndOrder 是大排序没吃索引,按 ESR 并入复合索引;
- 先判根因再动手,资源性慢查询改索引无效。