1.1 从一次大促压垮机房说起:为什么是Nginx
1.1 从一次大促压垮机房说起:为什么是Nginx
本节摘要:Nginx 是一款采用异步事件驱动架构的高性能 Web 服务器与反向代理软件。本节从一次真实的大促故障切入,对比传统架构与 Nginx 在高并发下的行为差异,说清它为什么成为流量入口的默认选择。
事故现场还原
某电商系统的秒杀活动,预计峰值每秒 3000 请求。入口是 Apache 的 prefork 模式,MaxClients 设到 400。活动开始后:
- 请求以每秒约 5000 的速度涌入(预热页刷新放大了流量);
- 30 秒内 400 个工作进程全部占满,每个进程约 30MB 常驻内存;
- 剩余请求进入监听队列,队列溢出后内核直接回 RST;
- 应用服务器因为入口超时重试,收到双倍请求,连带雪崩。
整个过程 40 秒。扩容来不及,降级开关藏在配置深处,最终回滚活动页了事。
为什么每连接一进程必然先倒
prefork 模型下,每个并发连接占用一个进程。资源消耗与连接数线性相关:
并发 100 → 100 进程 × 30MB ≈ 3GB,尚可接受 并发 1000 → 需 30GB 内存,单机装不下 并发 10000 → 进程切换本身就把 CPU 吃光
问题不在代码质量,在模型:连接数增长直接换算成进程数增长,而进程是操作系统里最贵的资源之一。上下文切换、内存 footprint、fork 开销,每一项都会在万级并发下被放大。
Nginx 的四个角色
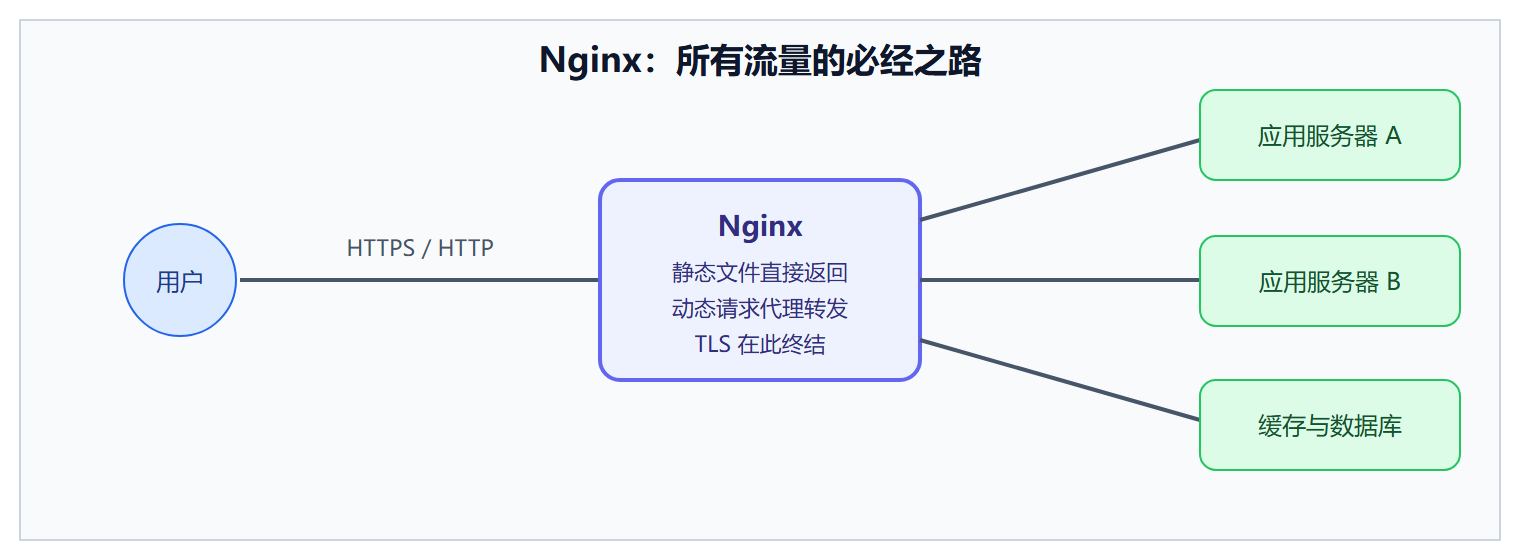
Nginx 用少量常驻进程处理海量连接,资源曲线近乎平坦。在实际架构里它通常身兼四职:
| 角色 | 场景 | 关键能力 |
|---|---|---|
| 静态 Web 服务器 | 托管前端构建产物、图片 | sendfile 零拷贝直接发文件 |
| 反向代理 | 把动态请求转给后端应用 | proxy_pass 转发、改写头部 |
| 负载均衡器 | 多台后端分摊流量 | upstream 多算法调度 |
| TLS 终结点 | 集中处理 HTTPS 卸载 | 单点证书管理、SNI |
图:Nginx 在架构中的位置
我的主张
如果今天从零搭建一个对外服务的 Web 系统,入口层我会直接上 Nginx,跳过"先用应用框架自带的 HTTP 服务顶一阵"这个阶段。理由很实际:入口层迟早要承担 TLS、限流、缓存、灰度这些事,越早把 Nginx 放进来,后面每次流量增长都只是在它上面加配置,而不是改架构。
反过来的场景也成立:如果你的服务并发长期在几百以下,且没有 TLS 卸载、动静分离的需求,引入 Nginx 的收益有限,多一层组件反而多一个故障点。技术选型看的是场景压力,不是简历好看。
复盘:事故的完整链条
把 40 秒的崩溃放慢逐帧看,每一帧都有止损机会:
- 流量放大:预热页每 3 秒自动刷新,峰值前请求量被人为放大了三倍。预防:活动页刷新策略在压测里一起评估;
- 进程占满:MaxClients 400 到顶后,新请求只能排队。预防:入口层先做并发限制,把超出容量的请求挡在应用之外(第四章限流的前身);
- 队列溢出:监听队列满后内核回 RST,客户端表现为连接重置。定位:当时若看过内核的队列溢出计数器,会看到它在进程占满后两秒内飙升;
- 重试放大:客户端SDK 对超时做三次重试,后端实际收到约 2.6 倍请求,等于往火里浇油。预防:重试必须有退避和上限,且只对幂等请求做。
事后验证用最小压测复现。在测试机上用压力工具直接对比两种入口的行为:
# 500 并发持续 30 秒打预热页 ab -c 500 -t 30 http://test-host/warmup.html # 观察 Apache 侧:进程数、内存、失败率 watch -n 1 "ps -C httpd --no-headers | wc -l; free -m" # 换 Nginx 后同样参数再打一遍,对比两轮的 Non-2xx 响应数
复现实验的价值在于把"事故故事"变成"可测量的行为差异":同一组参数下,prefork 的失败率随并发爬升,Nginx 的失败率为零而内存曲线不动。数字比结论有说服力。
概念辨析:并发、QPS 与延迟
排障和容量讨论里最容易混用的三个词需要一次说清。并发连接数是某一瞬间挂着的连接总量;QPS 是每秒完成的请求数,等于并发除以平均耗时;延迟是单个请求从发出到收完响应的时间。三者可以独立变化:把接口耗时从 200ms 优化到 100ms,并发不变的情况下 QPS 翻倍。事故里"5000 QPS 打垮 400 进程"换算过来,是每个请求平均占用进程 80ms 以上——进程数根本不够分。理解这层换算,后面的容量公式才有意义。
换一个角度算这笔账还能看到选型的时间成本。事故后的迁移分两个晚上完成:第一晚 Nginx 前置做纯转发,Apache 藏到后面,行为不变;第二晚逐段把静态资源切到 Nginx 直出。全程没有停机,回滚只需把 DNS 指回。对比"重写应用层"或"整体上云"这类方案,入口层替换是影响面最小、验证最快的止血手段——这也是为什么流量入口值得在系统早期就放一个专职组件:它后来承担的限流、缓存、灰度能力,都是在这种事故倒逼下一步步加上去的,而每次加能力的成本都只是"在 Nginx 上加配置"。
迁移之后半年的一组跟踪数据,可以给"值不值得换"一个量化回答:同样的四台应用机器,入口换成 Nginx 后大促峰值从"40 秒雪崩"变为平稳扛住 12000 QPS,入口层本身只增加了一台 4 核 8G 的机器与约 60MB 常驻内存;运维侧的额外工作是每季度一次的版本升级,单次约半小时。对比事故当晚的直接损失(活动回滚、客诉、团队通宵),这笔投入在第二次大促就回了本。技术决策最可靠的辩护从来不是原理,而是这份前后对照的成本账——第一章把它作为起点,也是给后面每一章的改造定下"必须给数字"的基调。
本节要点回顾
- 大促雪崩的根因:每连接一进程模型下,连接数线性兑换成进程数,资源在万级并发前耗尽;
- Nginx 的定位:静态服务器、反向代理、负载均衡器、TLS 终结点四合一的流量入口;
- 平坦的资源曲线是它对抗高并发的核心竞争力;
- 选型判断:有流量增长预期就早上 Nginx,纯低并发内部服务可以不上。