1.2 事件驱动架构:一万并发背后的原理
1.2 事件驱动架构:一万并发背后的原理
本节摘要:Nginx 的高并发能力来自"一个 master 加多个 worker、每个 worker 用 epoll 事件循环处理成千上万连接"的架构。理解 worker 进程模型与非阻塞 IO,是后面所有性能调优的认知地基。
一次请求在 Nginx 内部的旅程
worker 进程不"盯着"某个连接,而是把所有连接注册到内核的事件通知机制上,谁有数据到达就处理谁。以一次代理请求为例:
关键在"同时继续处理其他连接"这一行:worker 等待后端的时间里不是阻塞睡眠,而是在服务别的请求。等待被摊薄了,吞吐自然上去。
进程模型:master 与 worker
worker_processes auto; # 通常等于 CPU 核数
- master 进程:读取并校验配置、管理 worker 的生老病死、绑定端口。它不处理请求。
- worker 进程:真正干活的人,彼此对等,竞争 accept 新连接。
图:master-worker 进程模型
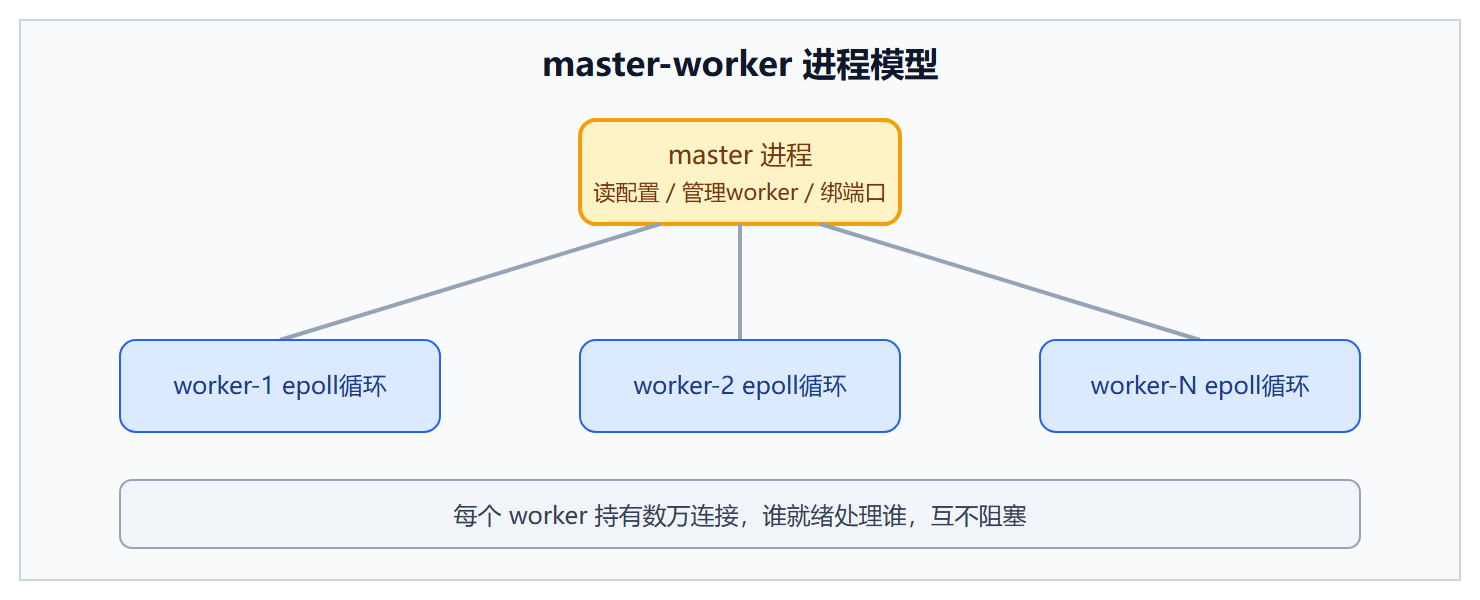
这个设计带来一个重要副产品:reload 是平滑的。master 收到 reload 信号后拉起新 worker 加载新配置,老 worker 处理完存量请求再退出,线上改配置不掉连接。第二章会反复用到这一点。
非阻塞 IO 与 epoll
传统阻塞 IO 的问题可以用银行柜台类比:一个柜员(进程)服务一个客户(连接),客户填单时柜员干等。epoll 则像叫号系统——所有客户先坐着填单,哪个叫到号柜员就服务哪个,柜员手上的"在办客户"可以有很多个。
Linux 上 Nginx 默认使用 epoll,无需手动指定;连接数的理论上限由每个 worker 的 worker_connections 决定:
events { worker_connections 40960; # 每 worker 最大连接数 multi_accept on; # 一次惊群 accept 多个连接 }
⚠️ 最大并发代理连接 ≠ worker_connections 本身:每个客户端代理请求占两个连接(客户端侧一个、后端侧一个),估算容量时要除以 2。
用数字验证架构收益
在同一台 4 核 8G 的机器上压测静态小文件,对比结果:
prefork Apache, MaxClients 400: 并发 1000 → 失败率 62%,load average 45 Nginx, 4 worker × 40960: 并发 10000 → 失败率 0%,load average 3.1 内存占用 4 × 18MB,几乎不随并发增长
资源曲线平坦不是魔法,是"等待不占线程"的直接后果。
worker 数量的边界讨论
"worker 等于核数"是起点而不是铁律,两类业务会偏离。CPU 轻而 IO 重的代理场景,worker 大部分时间在等 epoll 返回,8 核机器开 16 个 worker 也不会互相踩踏,反而能更满地利用等待间隙;反之 CPU 重的场景(开了高压缩级别、大量 SSL 握手)worker 数超过核数立即表现为上下文切换翻倍,吞吐不升反降。判断依据不是教条,而是现场观察:用状态工具看每个 worker 的 CPU 占用是否均匀,若个别 worker 长期打满而其他空闲,通常说明连接分配不均,而不是 worker 不够。验证 worker 数调整是否有效的方法同样朴素——改一个参数压一轮,对比 P99 与 load average:
# 观察 worker 进程的 CPU 分布是否均匀 top -H -p $(pgrep -d',' -x nginx | tr ',' '\n' | head -1) # 每轮压测记录三个数:QPS、P99、load average wrk -t8 -c2000 -d30s http://test-host/ | grep -E "Latency|Requests/sec"
长连接与事件模型的配合
事件驱动的收益要靠长连接兑现。HTTP/1.1 默认 keepalive,一条连接跑完一个请求不关闭,下个请求直接复用——对客户端省了建连往返,对 Nginx 省了反复注册事件的成本。若应用侧错误地在响应头里下发 Connection close,Nginx 的连接数会像短连接模式一样反复腾挪,Waiting 指标长期接近零。第六章的监控口诀里"Waiting 暴跌要查 keepalive"说的就是这种情况。反过来,keepalive_timeout 也不能无限拉长:空闲连接每个都占着一个事件槽位,海量僵尸连接会吃掉 worker_connections 的配额。30 到 60 秒是公网服务的常见区间,既覆盖用户的页面内跳转间隔,又不至于积压。
这套模型的边界也要诚实面对。事件循环是单线程串行的,一个 worker 内任何阻塞操作都会卡住它名下所有连接——磁盘打满、DNS 解析慢、动态模块里写了同步调用,都会让"事件驱动"退化成"全局排队"。所以 Nginx 的世界里所有可能慢的操作都被刻意做成了非阻塞或交给独立线程池,配置层面也应遵循同一原则:能用 map 预计算的不要用 if 现场算,resolver 要显式指定并配好超时。理解"不能阻塞事件循环"这条铁律,第五章讲 aio 与线程池时会有更深的体会。
验证这套理解是否到位,有一个自测问题:为什么 Nginx 不把 worker 数开到几百个,让每个 worker 少管点连接?答案藏在事件循环的成本结构里——连接在多个 worker 间分配需要 accept 竞争,worker 越多惊群与锁开销越大;每个 worker 还有独立的内存池与连接表,上百个 worker 的固定开销先吃掉可观内存;而单个 worker 管理数万连接的能力本来就绰绰有余。把 worker 数压到核数级,是让每个事件循环都满负荷、让操作系统调度队列最短的选择。能自己推导出这个结论,事件模型就算真正吃透了。
本节要点回顾
- master 管生命周期,worker 管请求,两者职责分离使平滑 reload 成为可能;
- epoll 事件循环让一个 worker 同时看护数万连接,等待被摊薄而非堆积;
- 代理请求占两个连接,容量估算要打对折;
- worker 数通常等于核数,多设无益反而增加切换开销。