1.3 生产环境安装与版本选型
1.3 生产环境安装与版本选型
本节摘要:生产环境的 Nginx 安装要回答三个问题——用稳定版还是主线版、用发行版包还是官方仓库、内核参数要不要动。本节给出可执行的决策路径与安装验证清单。
先做版本决策
Nginx 有两条发布线:mainline(单号版本,新特性)和 stable(双号版本,只修缺陷)。生产环境我的建议是 mainline——"stable"这个名字有误导性,它指的是分支特性冻结,而不是更可靠;缺陷修复反而先落在 mainline。除非你需要和第三方模块做严格兼容验证,否则跟着 mainline 走。
第二层决策是安装来源:
| 来源 | 优点 | 代价 |
|---|---|---|
| 发行版仓库 | 最省事,依赖自动处理 | 版本常落后一两年,缺新模块 |
| 官方仓库 | 版本新,升级及时 | 需要额外配置仓库源 |
| 源码编译 | 可裁剪、可嵌入第三方模块 | 升级维护成本全在自己 |
只有当你确定要用动态加载的第三方模块(第四章会用到)时,才值得走源码编译;大多数团队用官方仓库是性价比最高的选择。
安装与目录约定
以官方仓库为例,在基于 RPM 的系统上:
# 配置官方仓库后 sudo yum install nginx # 或 Debian 系 sudo apt update && sudo apt install nginx
装完先建立目录心智,生产配置建议按站点拆分:
/etc/nginx/ ├── nginx.conf # 主配置,只留全局与事件块,HTTP 内 include ├── conf.d/ │ ├── shop.conf # 每个业务一个文件 │ └── admin.conf └── mime.types
对应主配置里一行:
http { include /etc/nginx/conf.d/*.conf; }
单文件大配置在十几个站点之后会变成没人敢动的泥潭,按站点拆分是第一天就该养成的习惯。
内核参数配合
Nginx 装好只是半件事,内核默认参数撑不起高并发。两个必须检查的项:
# 临时生效 sudo sysctl -w net.core.somaxconn=65535 sudo sysctl -w net.ipv4.ip_local_port_range="1024 65535"
somaxconn 是监听队列上限,默认 128 在流量突增时直接丢连接;代理场景下 Nginx 作为客户端向后端发起大量出站连接,可用临时端口范围不够会报 "cannot assign requested address"。持久化写入 sysctl 配置后执行 sysctl -p 生效。
⚠️ 改完内核参数忘了同步 Nginx 侧:listen 行加 backlog 参数才能真正用上更深的队列,如
listen 80 backlog=8192;。
装完的三步验证
nginx -t # 语法检查 systemctl start nginx curl -I http://127.0.0.1 # 看到欢迎页 200 即通
再补一个开机自启与信号验证:
systemctl enable nginx nginx -s reload # 平滑加载,确认连接不掉
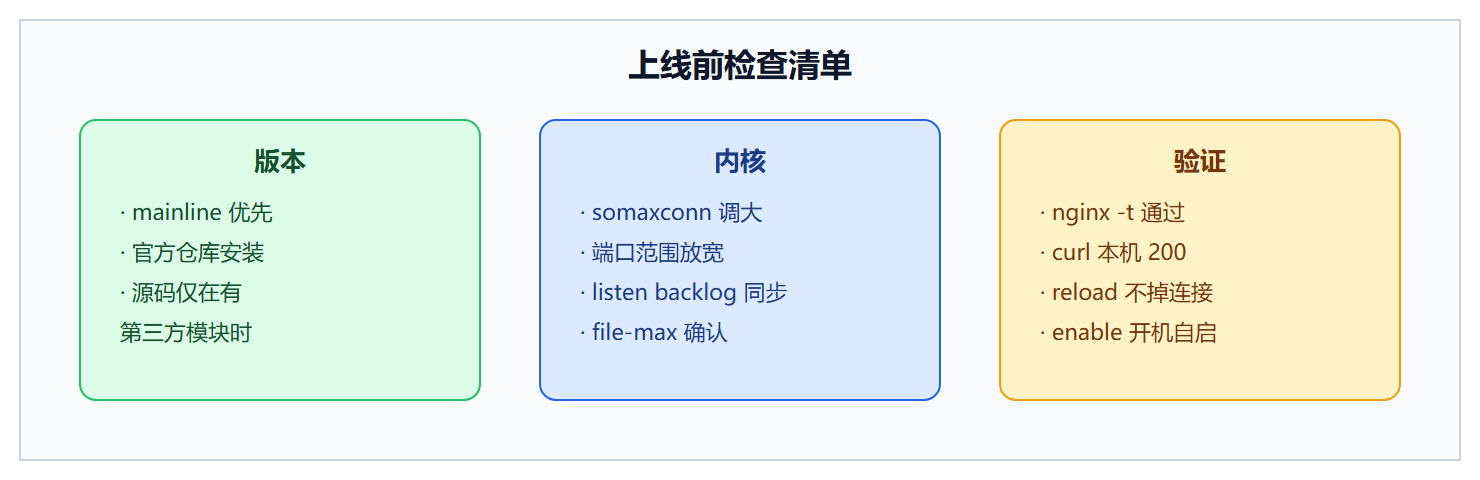
图:生产安装检查清单
源码编译路线备忘
确需编译时(比如要嵌第三方模块),流程与目录约定要一步到位:
# 安装编译依赖后 ./configure --prefix=/usr/local/nginx \ --with-http_ssl_module \ --with-http_v2_module \ --with-stream \ --with-threads \ --add-dynamic-module=../ngx_cache_purge make && make install
三条纪律:编译参数在每台机器上必须一致,把 configure 命令存进版本库而不是靠记忆;二进制路径与仓库版不同,systemd 服务文件要手写并纳入配置管理;升级流程固定为"编译新版、替换二进制、nginx -t、reload",绝不 make install 覆盖配置目录。源码路线的自由是用纪律换的,团队没有配置管理基础时,老老实实用仓库包。
一张启动期故障对照表
装机阶段最常见的报错与含义:
| 现象 | 含义 | 处理 |
|---|---|---|
| bind() to 0.0.0.0:80 failed | 端口被占 | 查占用进程,或改监听端口 |
| setgid() failed | user 指定的用户不存在 | 创建 nginx 用户或改 user 指令 |
| worker_connections are not enough | 打开文件数受限 | 抬高 worker_rlimit_nofile 与系统级限制 |
| host not found in upstream | upstream 写了域名但解析失败 | 检查 DNS 或启动顺序依赖 |
版本选型还有一层组织层面的考量:同一家公司的所有 Nginx 应统一到同一个版本线上,而不是各团队各选各的。理由在故障时最明显——全网同一版本意味着同一份已知问题清单、同一份配置语义、同一套模块兼容性验证。混合版本的集群里,一条在 1.18 上验证过的配置到 1.24 的机器上行为不同(比如 http2 指令语法迁移),这类差异平时隐形,出事时极难排查。建议把"统一版本线"写进基础设施规范,升级按批次灰度推进,而不是逐台随机漂移。
装机收尾还有一份最小化交付清单值得照抄:机器上应有配置版本库的检出、监控探活的接入、日志轮转的默认配置、以及一份写明"这台机器属于哪个集群、找谁负责"的说明文件。这四样东西的成本加起来不到一小时,却决定了这台机器半年后是"资产"还是"来历不明的黑盒"。运维生涯里最贵的排查,往往不是技术难题,而是搞不清一台没人认领的 Nginx 上为什么跑了十一个 server 块。
本节要点回顾
- mainline 是生产默认选择,stable 只是特性冻结分支;
- 官方仓库性价比最高,源码编译留给确实需要第三方模块的场景;
- 配置按站点拆文件,主配置只留骨架加 include;
- 内核参数是隐形天花板:somaxconn 与端口范围必须与目标并发匹配;
- 装完必做三步验证:语法、连通、平滑 reload。