6.1 状态监控与指标采集
6.1 状态监控与指标采集
本节摘要:stub_status 端点暴露 Nginx 的活动连接、请求计数与读写等待数,是指标采集的最小入口;生产监控通常用 Prometheus exporter 补齐 per-upstream 视角。本节给出核心指标清单与告警阈值设定方法。
最小指标端点
server { listen 127.0.0.1:8100; # 只绑本机,给采集器用 location /stub_status { stub_status; access_log off; } }
curl 一下就能看到:
Active connections: 15 server accepts handled requests 8456 8456 32891 Reading: 0 Writing: 3 Waiting: 12
五行数据信息量不小:
| 指标 | 含义 | 异常信号 |
|---|---|---|
| Active connections | 当前总连接 | 持续逼近 worker 容量上限 |
| Reading | 正在读请求头的连接数 | 大量堆积 = 慢客户端或攻击 |
| Writing | 正在返回响应的连接数 | 持续高 = 后端慢 |
| Waiting | 空闲等待中的 keepalive 连接 | 正常时占比最大 |
告警阈值怎么定
阈值不是抄来的,是基线推出来的。观察一周的 P50 与 P99 分布后:
Writing 基线 P99 = 200,容量 = worker数 × connections → 阈值设在基线三倍(600)并保留五倍容量余量 错误率:5xx 占比 > 0.5% 持续 3 分钟 → 页面告警 429 占比突增:限流误伤或攻击,值得子路径区分
我倾向"基线倍数"而非绝对值:绝对值换台机器就失效,基线倍数跟着业务形态走。
补齐 per-upstream 视角
stub_status 只看整机,定位不了"哪个后端坏"。两个路子:
# 1. 日志先行:2.3 节定义的 main 格式里有 upstream_response_time # 按天聚合就能看到每个后端的耗时漂移 # 2. exporter 方案:Prometheus 的 nginx exporter # 通过 API 暴露每 upstream 的请求数、响应码、失败计数
图:监控三层视图
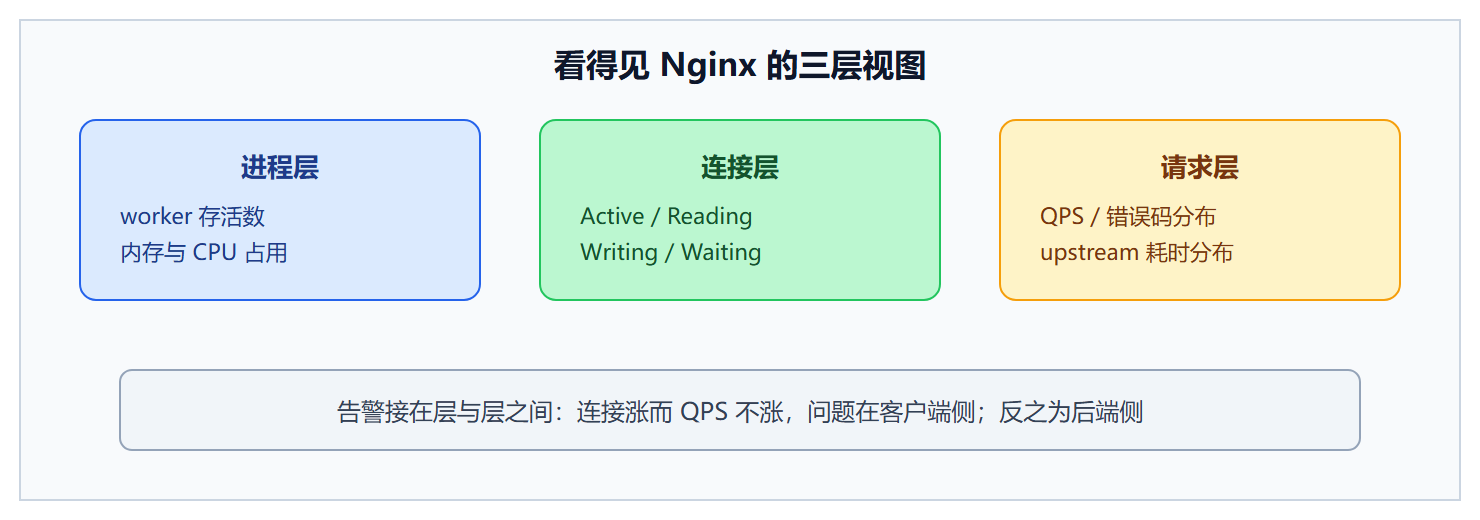
💡 判断口诀:Writing 高 + upstream 耗时高 = 后端慢;Reading 高 = 慢客户端;Waiting 暴跌 = 短连接风暴(检查 keepalive 是否被关)。
指标采集落地
stub_status 的数字是累计值和瞬时值混在一起的,采集器要做一层换算才能入库:requests 是累计计数,两次采样相减除以间隔才是 QPS;Active、Reading、Writing、Waiting 是瞬时值直接入库。采集脚本的核心逻辑:
# 每分钟采集一次,算出增量 QPS 后推给监控 Agent prev=$(curl -s http://127.0.0.1:8100/stub_status | awk 'NR==3{print $3}') sleep 60 curr=$(curl -s http://127.0.0.1:8100/stub_status | awk 'NR==3{print $3}') echo "nginx_qps $(( (curr - prev) / 60 ))" # Waiting/Active 的比值也值得入库:比值跌破常态说明短连接风暴
告警的分层同样重要:连接类指标是"趋势告警"(连续多个周期爬升才报),错误率是"突刺告警"(单周期越线即报)。把两类阈值混在一个灵敏度上,要么天天误报被忽略,要么真出事时慢半拍。
一个 Waiting 指标的实战案例
某周五傍晚 Waiting 从常态的 60% 跌到 5%,QPS 无变化,业务无报障。这种"没有故障的现象"最考验判断。回查配置变更记录,发现下午有人把后端某接口的响应头加了 Connection close,keepalive 被后端单方面关闭,客户端每请求重建连接。指标解释了变化,但要不要处理?算一笔账:QPS 两万,每次建连多约 1ms 的往返与内核开销,合计约 2% 的资源浪费,还不至于故障但属于慢性失血。处理方式是推动后端去掉该头。这个案例的要点:监控的价值不止于故障告警,也在于让无声的退化被看见——没有基线,这种退化永远无人知晓。
采集体系之外,监控的"最后一公里"是值班视角的整理:每条告警必须附带一句话行动指引——"Writing 高于阈值:按口诀检查后端耗时,进 6.3 流程"。没有行动指引的告警只是噪音生产器,值班的人收到后要么忽略要么恐慌。整理的过程也是对指标的再筛选:把上线三个月从未触发或触发后无人行动的告警降级或删除。监控系统的健康度同样需要监控,一个充斥失效告警的面板,会让真正重要的那条告警在狼来了的故事里被错过。
把本章开头的三层可见性再细化成一张值班速查表,它是本节的最终交付物:连接层看 stub_status——Active 逼近容量上限查连接泄漏,Writing 高企查后端慢,Reading 堆积查慢客户端,Waiting 暴跌查 keepalive 被关;请求层看访问日志——错误率按状态码分流,429 突增查限流误伤,5xx 进复盘流程;业务层看后端指标——应用 CPU 与数据库慢查询是 Nginx 指标异常时的第一下游线索。三层各有一个"五分钟能拿到"的数据源,值班的人按层下钻,不慌不乱。这张表建议打印出来贴在值班位上,它比任何监控平台的首页都更接近"告警响了之后我该干什么"这个真问题。
指标的口径统一是多人协作时的暗坑:Active connections 在 reload 前后会短暂翻倍(新老 worker 并存),QPS 采样窗口不同的人算出的数字能差百分之十几。团队层面把口径写死——采样间隔、聚合方式、reload 期是否剔除——比追求更炫的图表重要。监控数据一旦成为考核或汇报依据,口径不清的数字还会引发信任危机,这是技术债变成组织债的典型路径。
本节要点回顾
- stub_status 绑本机,五项数据是免费的体检报告;
- 阈值从基线倍数推导,不抄绝对值;
- per-upstream 视角靠日志或 exporter 补齐,整机指标定位不了具体后端;
- 层间交叉对比能快速切割客户端侧与后端侧问题。