6.2 日志分析:从访问日志里找真相
6.2 日志分析:从访问日志里找真相
本节摘要:访问日志是请求粒度的完整证词。字段设计决定能回答什么问题;聚合分析(状态码、耗时、IP、URI 四个维度)是排障与容量分析的基本功。本节给出可直接复用的查询手法。
字段设计决定分析上限
2.3 节的 main 格式再补两个实战字段:
log_format main '$remote_addr [$time_local] "$request" $status ' '$body_bytes_sent rt=$request_time ' 'urt=$upstream_response_time ' 'up=$upstream_addr cache=$upstream_cache_status ' '"$http_user_agent"';
upstream_addr:这次请求打到了哪个后端——多后端环境没有它就没法定位节点;upstream_cache_status:缓存 HIT 还是 MISS,验证 5.1 节的命中率。
四个维度的常用聚合
状态码分布——服务健康的第一眼:
awk '{print $4}' access.log | sort | uniq -c | sort -rn # 4xx 突增看 4.2 节限流;5xx 突增进 6.3 节流程
慢请求清单——按总耗时与后端耗时双排序:
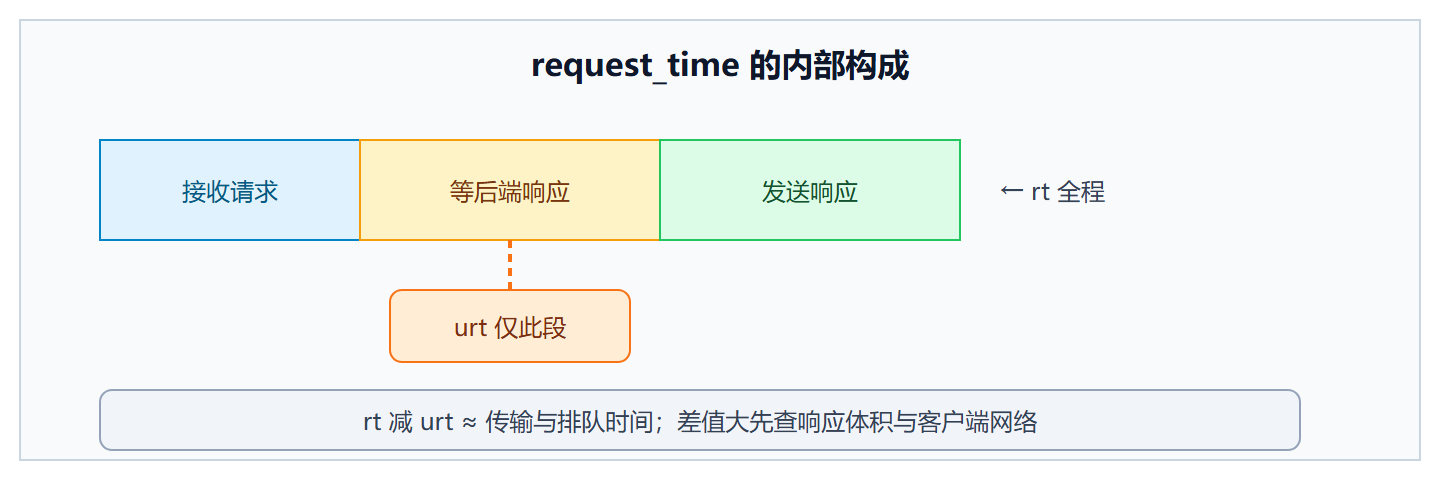
awk '$(NF-4) ~ /rt=/ {print}' access.log | sort -t= -k2 -rn | head -20 # rt 高 urt 低:传输慢(大响应或弱网) # rt 高 urt 高:后端慢,拿 up 字段找节点
IP 排行——谁在打你:
awk '{print $1}' access.log | sort | uniq -c | sort -rn | head # 单 IP 占比异常 → 4.2 节的限流与封禁链路
URI 热度——容量与缓存的输入:
awk '{print $6}' access.log | sort | uniq -c | sort -rn | head # 热点 URI 正是 5.1 节缓存收益最高的位置
一次日志驱动的容量分析
把一天的 urt 按小时聚合,画出的曲线揭示了后端的"晚高峰畸形":QPS 涨 40%,但 urt P99 涨了三倍——不是流量大,是高峰期的数据库慢查询拖累。结论写在数据里:扩应用无用,先治慢查询。没有请求粒度的日志,这个判断只能靠猜。
图:一次请求的耗时解剖
日志管理的两个提醒
一是轮转与保留:logrotate 配 daily 加 rotate 30,磁盘再也不是静默杀手;二是日志脱敏:URL 里的 token、手机号在采集进分析平台前打码,合规与安全都要求如此。
组合查询:回答一个真实问题
单维度聚合是基本功,真实排障要组合查询。例如"晚八点下单接口变慢,慢在哪个环节、哪个节点",一条管道完成拆解:
# 取晚高峰时段的下单请求,拆 rt 与 urt,按后端节点分组 grep "POST /api/order" access.log \ | awk -F'rt=|urt=|up=' '{split($3,a," ");print a[1], ($2-$3>0.1?"net-slow":"app-slow")}' \ | sort | uniq -c | sort -rn | head # 输出形态: # 812 10.0.1.12:8080 app-slow # 96 10.0.1.11:8080 app-slow # 11 - net-slow
结论直接可行动:慢集中在 12 号节点的应用层,不是网络。带着这份输出去找应用团队,比一句"接口慢"有效得多。日志分析的本质就是把"感觉"翻译成"证据"。
日志体量的治理
高流量站点的日志本身就是一条数据管道,治理三件套缺一不可。轮转用系统自带机制,按天切割保留三十天;压缩归档把冷日志压到十分之一体积;采样策略对超高 QPS 的健康探活与静态请求按比例记录,业务请求全量保留:
# logrotate 配置要点:切割后通知 Nginx 重开文件句柄 # daily 与 rotate 30 之外,postrotate 段是关键 # nginx -s reopen # 不加 reopen,Nginx 会继续往旧句柄写,日志"切了但没切"
这句 reopen 是日志轮转最常见的坑:磁盘上看到了新文件,老文件却持续增长,因为进程手里的句柄没换。排查方法是对比文件的实际写入时间与轮转时间是否同步。
日志分析能力的进阶形态是实时化:高流量场景下"事后 grep"的延迟以分钟计,秒级发现异常需要把日志流式送进分析平台。但管道再先进,字段的口径定义仍在这一节:平台里的每个看板,背后都是日志格式里某个字段的承诺。所以日志格式每次变更(加字段、改顺序)都应视作接口变更来管理——通知所有下游看板维护者、灰度切换、保留旧格式并行期。多少团队的实时大盘在一夜之间全部归零,追查半天发现是有人给日志加了个字段。日志是排障的证词,也是数据接口,两面都要守。
日志分析的日常化建设值得最后强调一次:把本节的四类聚合做成每天自动跑的日报——状态码分布、TOP20 慢请求、TOP10 来源 IP、TOP20 热点 URI,各附环比变化。日报的价值不在看,在"变化可见":某天慢请求榜首换了一个新接口、某个 IP 的请求量翻了十倍,这些趋势在没有日报时至少要等用户投诉才能发现。五条命令构成的日报脚本,是投入产出比最高的一份运维代码,也是 6.3 节排障能力在事前形态的延伸——最好的排障,是让问题在变成故障前先在日报里露头。
最后一条经验关于工具的克制:本节的命令全部用 awk 与 grep 完成,不是复古,而是刻意——排障时最可靠的是每台机器都有的工具。分析平台再强大,故障现场未必连得 上;离线工具再朴素,永远在你手边。先用最简工具回答第一个问题,需要更深的切片时再上平台,这个顺序让排障能力不依赖任何单一基础设施的存活。
本节要点回顾
- 日志格式加 upstream_addr 与 cache 字段,分析能力翻倍;
- 四个维度聚合(状态码、耗时、IP、URI)覆盖九成排障问题;
- rt 与 urt 的差值切割"传输慢"与"后端慢";
- 轮转保留与脱敏是日志体系自己的运维。