7.1 性能优化:事件循环诊断实战
7.1 性能优化:事件循环诊断实战
本节摘要:Node 性能问题九成可以归为两类:主线程被同步代码卡住,或 I/O(多为数据库)太慢拖满资源。本节建立以「事件循环延迟」为核心的监控指标,实操 CPU Profiler 与堆快照两件内置工具,学会读火焰图,最后用三个真实案例走完「先测再改」的完整流程。
动手目标
- 能实现事件循环延迟监控并解读数值
- 能用内置分析器采集 CPU 剖面与堆快照
- 能从火焰图找出热点函数
- 能复述三个典型性能案例的因果链与修法
一、核心指标:事件循环延迟
第 2 章说过 setTimeout 的延迟是「下限」。反过来利用这一点就能测出主线程的繁忙度:每秒注册一个定时器,实际触发时间与计划时间的差就是这一秒内事件循环的阻塞量。
function monitorEventLoopDelay() { let last = Date.now(); setInterval(() => { const now = Date.now(); const delay = now - last - 1000; // 计划间隔 1 秒 if (delay > 100) { console.warn(`事件循环延迟 ${delay}ms — 主线程有阻塞`); } last = now; }, 1000); } monitorEventLoopDelay();
生产上可以直接用官方的 perf_hooks.monitorEventLoopDelay,它给出直方图分布而不只是平均值。经验刻度:低于 10ms 健康,几十毫秒要关注,破百说明有明显阻塞。这个指标的妙处在于它直接度量「单线程模型的健康度」——CPU 高不一定有事(可能在算该算的东西),事件循环延迟高一定有事。
const { monitorEventLoopDelay } = require('perf_hooks'); const h = monitorEventLoopDelay({ resolution: 20 }); h.enable(); setInterval(() => { console.log('延迟分位: p99 =', h.percentile(99).toFixed(1), 'ms'); h.reset(); }, 10000);
二、两件内置工具
CPU 剖面回答「时间花在哪个函数」。不用装任何东西,命令行采样后用性能面板打开分析:
node --cpu-prof app.js # 退出后生成 .cpuprofile 文件, 浏览器开发者工具的性能面板可直接载入
堆快照回答「内存被谁占着」。三个快照对比法:运行一段时间拍一张、再运行一段时间拍一张,比较增量里增长最快的对象类型。
node --inspect app.js # 另开终端连接后调用 heapProfiler 采样, 或用 chrome://inspect 可视化操作
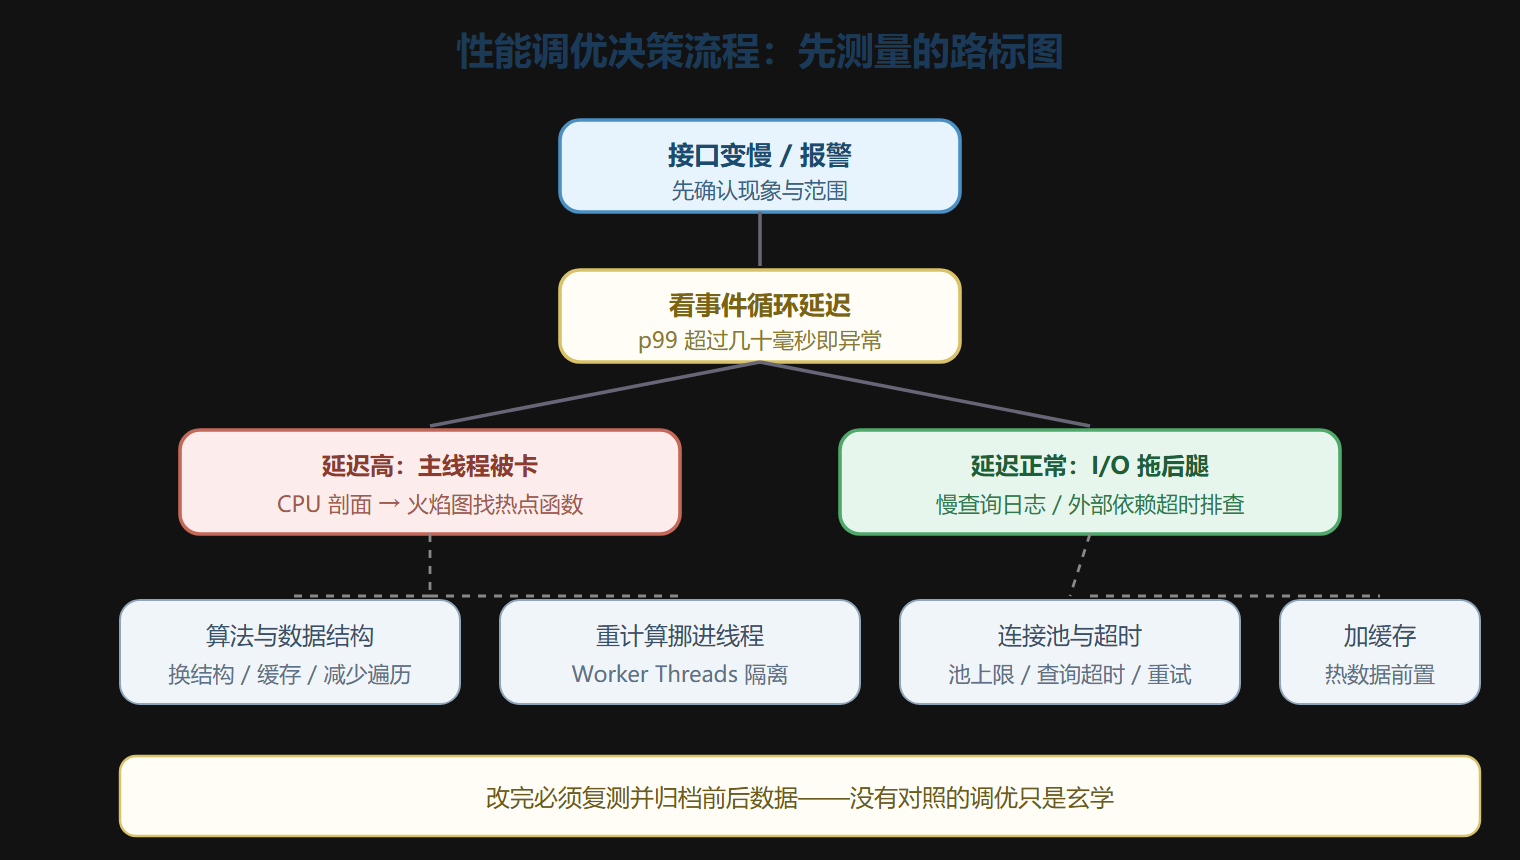
性能调优决策流程
三、三个真实案例
案例一:JSON 解析吃掉主线程。日志上报接口每分钟收几条 20MB 级的大报文,JSON.parse 单次耗时 300ms+,期间所有请求排队,事件循环延迟报警。修复分两手:客户端拆分批量上报(单条不超 1MB),服务端大报文改走带超时保护的队列异步处理。教训:同步的重操作不限于是你写的循环,标准库的 parse、stringify、crypto 同样在主线程上跑。
案例二:轮询间隔吞掉吞吐。一个后台任务用 while (true) { 查库(); sleep(100ms) } 的同步空转写法,空转逻辑把 poll 阶段塞满。改成事件驱动的「完成后再等 100ms」:
async function loop() { while (true) { await 查库(); await new Promise(r => setTimeout(r, 100)); // 让出主线程 } }
案例三:闭包积累的内存泄漏。全局缓存 Map 只进不出,堆快照对比显示某对象数组稳定增长。修复:Map 换成带上限与过期清理的 LRU。内存问题的排查路径永远是三张快照对比,而不是盯着代码猜。
四、读火焰图
CPU 剖面转成火焰图后,读法三句话:横宽即耗时(越宽的框越吃 CPU)、看最宽的叶子(顶层框架宽只说明它是调用链容器,叶子才是干活的人)、先找意料之外的宽框(已知的热点优化收益有限,陌生的宽框往往就是问题)。常见嫌疑:序列化/反序列化、正则回溯、深递归、以及在热路径上被反复调用的工具函数。
💡 关键直觉:监控指标定方向、内置工具找元凶、对照数据验疗效——三步之外都是运气。把这三步固化成排查清单,性能问题就有章法了。
监控的常态化
诊断能力最好沉淀为常态监控而非救火工具:事件循环延迟、进程内存、句柄数三个指标每十秒采一次汇入监控系统,配上阈值告警。有了基线数据,异常出现时第一眼就能回答「这是突发还是渐变」——渐变的内存曲线指向泄漏,突发的延迟尖峰对应某个具体发布或流量形态。没有基线的优化都是猜,有基线的优化才叫工程。
本节要点回顾
- 事件循环延迟是核心指标:直接度量单线程健康度,p99 破百必有问题。
- 两条命令采证据:--cpu-prof 抓 CPU 剖面,--inspect 配合堆快照查内存。
- 延迟高低分两路:高走主线程排查(火焰图),正常走 I/O 排查(慢查询/超时)。
- 同步陷阱:parse、stringify、crypto 与空转循环同样卡主线程。
- 内存靠三快照:对比增量定位增长对象,LRU 与过期清理是常见收尾。