7.2 PM2与cluster集群:榨干多核
7.2 PM2 与 cluster 集群:榨干多核
本节摘要:单进程的 Node 只能用一个 CPU 核,且一崩全崩。cluster 模块用「主进程监听、子进程处理」的架构把多核利用起来,PM2 在此之上补齐了守护、日志、零停机重载与监控。本节讲 cluster 的端口共享原理与进程分工、PM2 的配置文件与常用命令,以及内存与连接数在集群下的新账。
学习目标
- 能用原生 cluster 模块手写多进程服务并解释端口共享机制
- 能写 PM2 配置文件管理集群、日志与重启策略
- 能执行零停机重载并理解其代价
- 能重算集群下的连接池与内存预算
一、为什么需要集群
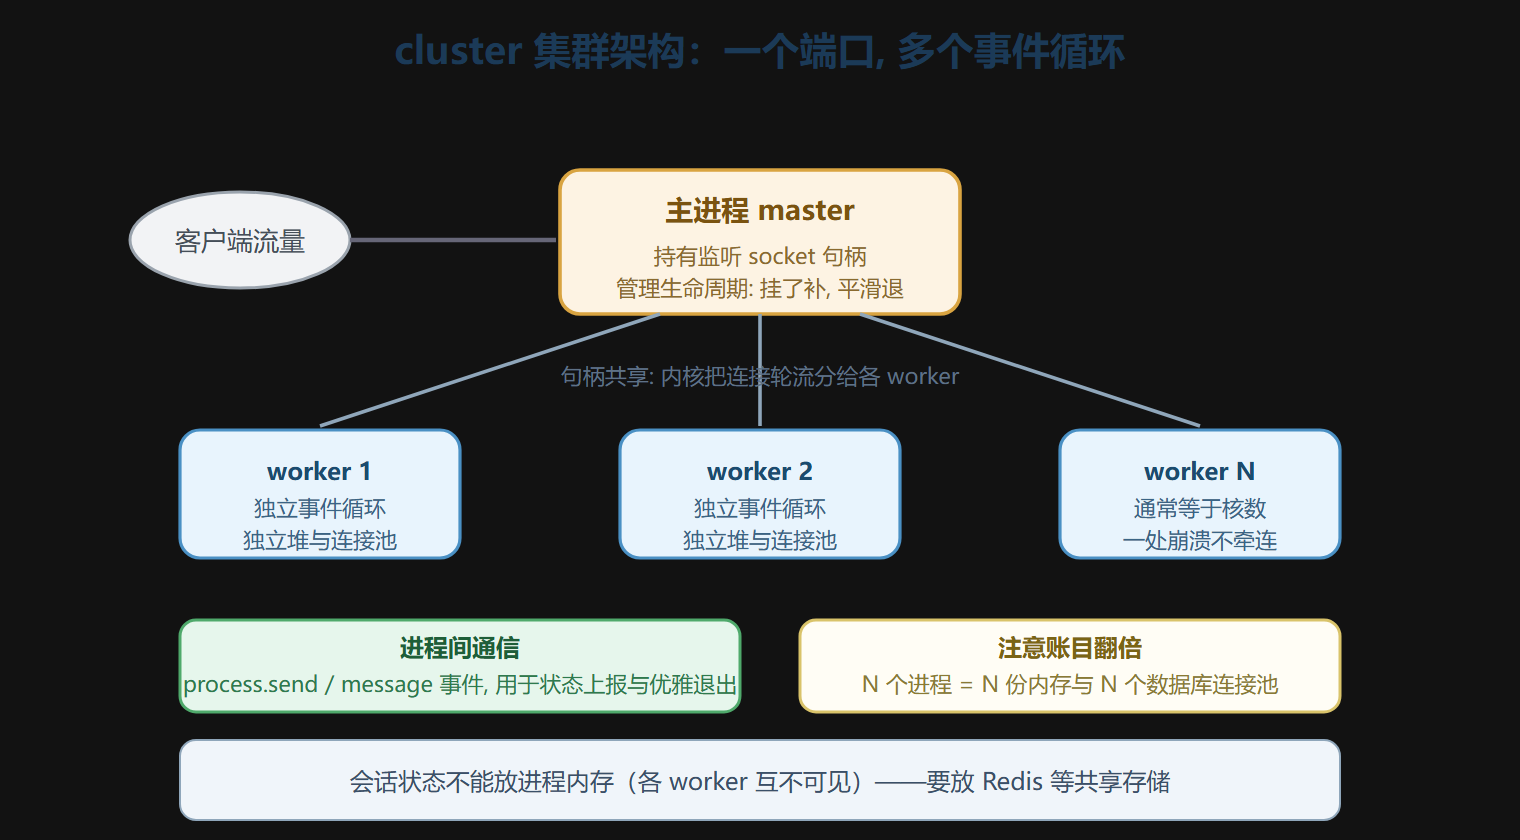
两个硬伤逼出集群:单核天花板——一个 Node 进程最多跑满一个核,4 核服务器浪费四分之三;单点脆弱——未捕获异常让进程退出,服务归零。cluster 模块一箭双雕:主进程(master)负责监听端口与管理子进程(worker),worker 各自跑一份完整应用。
const cluster = require('cluster'); const http = require('http'); const os = require('os'); if (cluster.isPrimary) { const workers = Math.min(4, os.cpus().length); for (let i = 0; i < workers; i++) cluster.fork(); cluster.on('exit', (worker, code) => { console.error(`worker ${worker.process.pid} 退出, 码 ${code}`); cluster.fork(); // 挂了就补 }); } else { http.createServer((req, res) => { res.end(`由进程 ${process.pid} 处理`); }).listen(3000); }
多份代码都调用 listen(3000) 却不冲突,靠的是 文件描述符共享:真正的监听 socket 由主进程创建,子进程通过进程间通信拿到同一个句柄,操作系统内核把到达的连接轮流分给各 worker。所以负载均衡发生在连接建立层,不需要应用层转发。
cluster 集群架构
二、PM2:把集群工程化
原生 cluster 够用但朴素,生产环境标配 PM2。配置文件化管理一切:
// ecosystem.config.js module.exports = { apps: [{ name: 'order-api', script: 'app.js', instances: 4, // 集群进程数, 或 'max' 占满所有核 exec_mode: 'cluster', max_memory_restart: '400M', // 内存超标自动重启, 泄漏保底 env_production: { NODE_ENV: 'production', }, out_file: 'logs/out.log', error_file: 'logs/error.log', merge_logs: true, kill_timeout: 5000, // 给优雅退出留 5 秒 }], };
日常命令一屏:
pm2 start ecosystem.config.js --env production pm2 ls # 进程状态总览 pm2 monit # 实时 CPU/内存面板 pm2 reload order-api # 零停机重载 pm2 restart order-api # 硬重启(会断流量) pm2 logs order-api # 看日志 pm2 startup # 开机自启
reload 与 restart 的区别是面试与事故双高频:reload 逐个重启 worker——先起一个新的再退旧的,期间其余 worker 继续服务,流量无感;restart 全体立即重启,必有瞬断。发版用 reload,改环境变量等必须全量重启的场合才用 restart,并安排在低峰。
优雅退出还需要代码配合:收到退出信号后停止接新连接、把手头请求处理完再退。
process.on('SIGTERM', () => { server.close(() => process.exit(0)); // 处理完存量连接 setTimeout(() => process.exit(0), 4000).unref(); // 兜底强制退 });
三、集群之后的新账本
进程数翻上去,三笔账要重算。内存:4 个 worker 各自一份 V8 堆,总占用是单进程的四倍附近,容器配额要跟上。连接池:第 5 章的公式在集群下兑现——数据库总配额 100,4 个进程各分 25,单进程池上限别再写 100。会话状态:cluster 默认轮转分发,同一用户的两次请求可能落在不同 worker,进程内存里的 session、本地缓存全部失效——要么上 Redis 共享,要么用粘性会话(不推荐,破坏无状态)。
⚠️ 常见坑:instances 越多越好是幻觉。worker 数超过核数后互相抢 CPU,事件循环延迟反而上升;容器环境还要给系统与旁路进程留核,4 核容器跑 3-4 个 worker 是常见甜点。
发布日的检查单
把集群发布的要点压缩成一张可以照着执行的检查单:确认配置文件里的进程数与环境变量正确;用 reload 而不是 restart 做滚动更新;发布后观察事件循环延迟与错误率是否回到基线;日志确认新旧进程交接干净、没有孤儿进程。发布是所有前述知识的考试现场,检查单是让考试稳定发挥的小抄。
容器环境的一点提醒
若部署在容器里,进程数要与容器配额而不是宿主机核数对齐:容器里查到的核数常常是宿主机的,按它开满进程会超卖配额,表现为周期性的延迟尖峰。给容器设好配额、进程数按配额取值,是容器化 Node 服务最常见的一个校准点。
日志的集中化
多进程之后,日志也散成了多份:每个 worker 各写各的文件流。生产环境的标配做法是进程只管往标准输出写结构化日志,收集与汇聚交给平台层——进程无状态、日志无文件,扩容缩容都不留尾巴。
本节要点回顾
- 架构一图:master 持句柄管生死,worker 各自一条事件循环,内核层分发连接。
- PM2 是标配:配置文件管集群、日志、内存保底与开机自启。
- reload 与 restart:前者零停机逐个换,后者瞬断全重启。
- 优雅退出要代码配合:SIGTERM 里 close 加超时兜底。
- 三笔新账:内存翻倍、连接池按进程配额拆分、会话状态上共享存储。