7.3 Worker Threads与Node的未来
7.3 Worker Threads 与 Node 的未来
本节摘要:cluster 解决「用满多核」,Worker Threads 解决「单次重计算不卡主线程」——两者分工不同。本节讲 worker_threads 的消息传递模型与实战(线程池化)、它与 cluster 的选型边界,最后展望 Node 的演进:ESM 全面化、顶层 await、单执行体应用等趋势,为全书画上句点。
动手目标
- 能写一个最小的 Worker 并用 postMessage 通信
- 能用池化模式复用 Worker 处理批量任务
- 能在 cluster 与 Worker Threads 之间做出正确选型
- 能概述 ESM、顶层 await 等方向的工程意义
一、Worker Threads:进程里的线程
第 7.1 节的案例已经暴露:JSON.parse 大报文、图片处理、加密压缩这类同步重活,在主线程上跑必然拖累全部请求。cluster 帮不上忙——轮到谁谁倒霉。答案是把重活搬进真正的线程:worker_threads。
const { Worker, isMainThread, parentPort } = require('worker_threads'); if (isMainThread) { const worker = new Worker(__filename); worker.on('message', r => console.log('结果', r)); worker.on('error', e => console.error('线程出错', e.message)); worker.postMessage({ rows: [ /* 十万行数据 */ ] }); } else { parentPort.on('message', ({ rows }) => { const result = 重计算(rows); // 随便跑多久, 不卡主线程 parentPort.postMessage(result); }); }
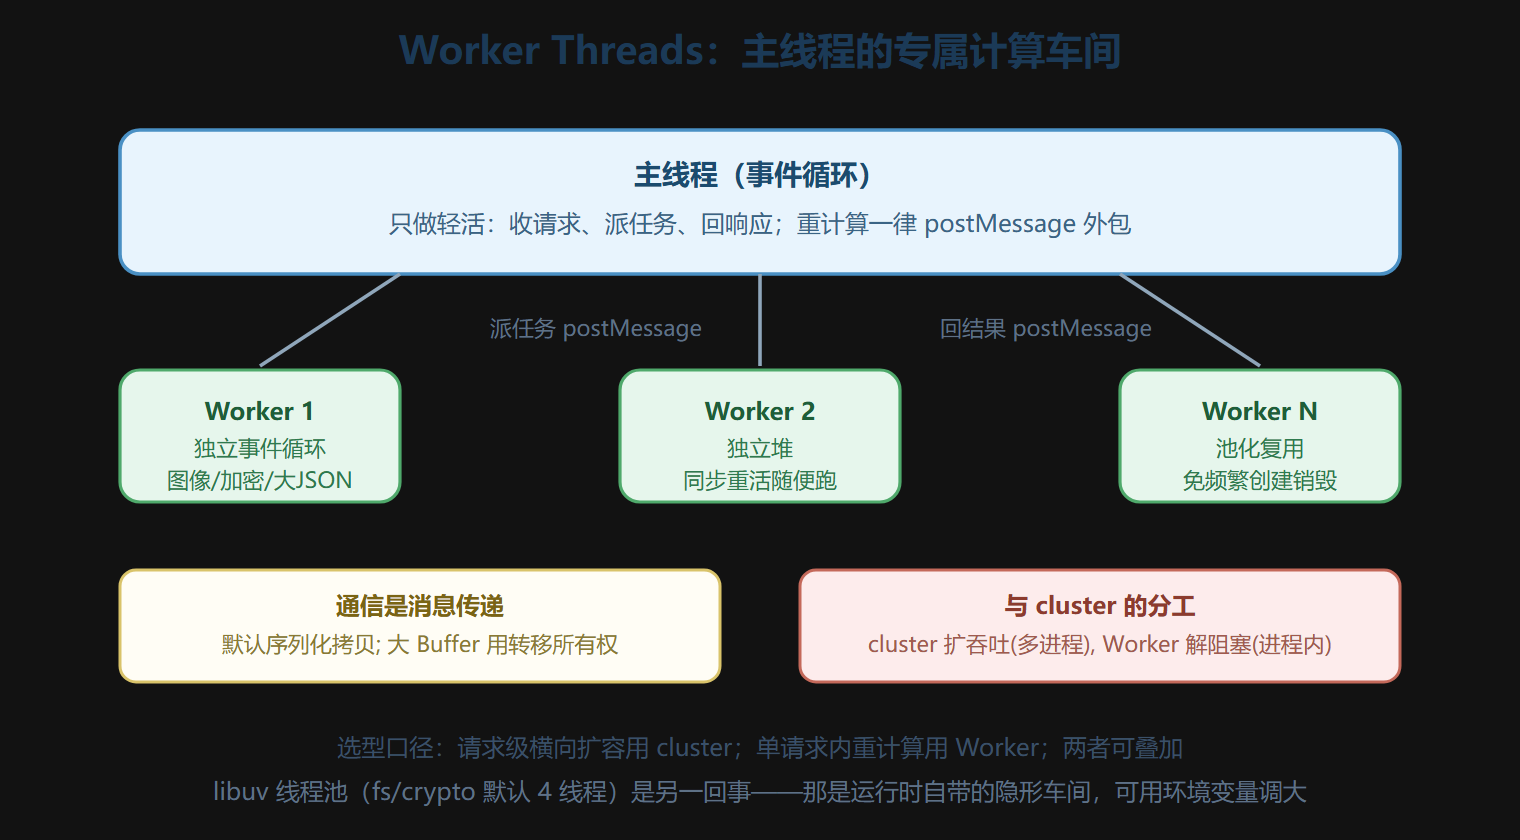
要点藏在这个文件自包含的写法里:同一个文件,主线程与 Worker 里各执行一遍,用 isMainThread 分流。Worker 有自己独立的事件循环与 V8 实例——这一点必须刻在脑子里:它不是共享内存的线程(默认),通信靠消息序列化,跨线程传大对象是有拷贝成本的。真要传大缓冲,用 transferList 转移 Buffer 的所有权而不是复制。
Worker 线程池架构
二、池化:Worker 的正确打开方式
按请求创建 Worker 就像按请求建数据库连接——开销不可接受。做法与连接池同构:预建 N 个 Worker,任务排队领取。
const { Worker } = require('worker_threads'); class WorkerPool { constructor(size, workerFile) { this.idle = []; this.queue = []; for (let i = 0; i < size; i++) { const w = new Worker(workerFile); this.idle.push(this.wrap(w)); } } wrap(w) { return { worker: w, busy: false }; } run(task) { return new Promise((resolve, reject) => { const slot = this.idle.find(s => !s.busy); const job = { task, resolve, reject }; if (!slot) { this.queue.push(job); return; } this.dispatch(slot, job); }); } dispatch(slot, { task, resolve, reject }) { slot.busy = true; slot.worker.once('message', r => { slot.busy = false; resolve(r); const next = this.queue.shift(); if (next) this.dispatch(slot, next); }); slot.worker.once('error', e => { slot.busy = false; reject(e); }); slot.worker.postMessage(task); } } // 用法: 池大小取核数, 八万行数据的重计算交给线程 const pool = new WorkerPool(4, './heavy-task.js'); const result = await pool.run({ rows });
注意这个模式与第 3 章 fetchPool、第 5 章连接池的家族相似性——池 + 队列 + 借还是 Node 里一切稀缺资源管理的通用骨架,认出它,你就在任何模块里都会用。
三、Node 的演进方向
ESM 全面化。import/export 正在成为新代码的默认形态:静态可分析(tree-shaking 的前提)、导出实时绑定(第 1 章对比过)、顶层 await 可用。过渡期长短项目会长期混居,掌握「type 字段决定解析规则、扩展名与包 exports 字段控制入口」三条就能应对绝大多数混用问题。
顶层 await。ESM 入口文件里可以直接 await——配置加载、数据库迁移在启动期的写法更直白。代价是会阻塞后续 import 的执行,启动链上的重活该挪到工具入口而不是被层层 import 的库文件里。
单执行体应用。官方在做「把项目打包成单个可执行文件」的能力,分发小工具不再要求目标机器装 Node——对 CLI 交付是实打实的减负。
方向上的主线其实没变过:让事件循环上的每一毫秒更值钱。从 Stream 的背压、cluster 的多进程、Worker 的多线程到测试与监控的体系化,Node 十几年的演化都在回答同一道题——单线程模型如何在真实负载下保持快而稳。这也是本教程用事件循环串起全部章节的原因:理解了主线,任何新特性都只是变奏。
保持跟进的方式
Node 的大版本每年两次落地,跟进成本其实不高:每次升级读一遍官方的发布说明,重点关注弃用警告与性能变化,在 CI 里用一个独立分支先跑全量测试,绿了再合入。真正要持续投入的是把本教程的暗线练成本能——无论生态怎么变,判断「这段代码会不会卡事件循环」「这个瓶颈在主线程还是在 I/O」的眼光,永远是 Node 工程师最值钱的手艺。
结语
教程到这里就结束了。回头看,第 1 章那张分层图上,你的代码在最顶层;而你现在知道了下面每一层的名字与脾气——V8 怎么执行、事件循环怎么调度、流怎么背压、进程怎么集群、线程怎么分工。所谓实战能力,无非是问题出现时知道下潜到哪一层。愿你接下来的每个线上深夜,都比想象中从容。
最后一次要点演练
合上教程前,试着不看目录复述全书的暗线:回调是接口、Promise 是值、事件循环是调度引擎、Stream 是背压的水管、集群是多核的分身、Worker 是车间的帮工——一条线背下来,二十五篇就连成了一片。
本节要点回顾
- Worker 是进程内的真线程:独立事件循环与堆,消息传递通信,transferList 转移大缓冲。
- 池化是标配:预建复用加任务队列,与连接池、并发池同构。
- 选型三分法:扩吞吐用 cluster、解单请求阻塞用 Worker、两者可叠加;libuv 线程池是另一层隐形车间。
- ESM 是新默认:静态分析加实时绑定;混用期记住 type 字段与 exports 入口两条规则。
- 顶层 await 慎用:启动链上的阻塞会层层传导,重活放工具入口。