3.2 特征描述符
3.2 特征描述符
本节摘要:检测器回答"特征在哪",描述符回答"特征长什么样"——把关键点邻域编码成定长向量或二进制串,才能跨图比对。本节拆解 SIFT 的尺度空间与梯度方向直方图编码、ORB 的二进制串与汉明距离思想,给出"精度、速度、专利"三维选型表。核心结论:离线高精度用 SIFT,实时与移动端用 ORB。
从项目需求看本节目标
阅读完本节,你应当能够:
- 用 SIFT 或 ORB 一步完成检测加描述,拿到关键点与描述符矩阵
- 解释 SIFT 的三层结构:尺度空间找位置、主方向定旋转、直方图做编码
- 说清 ORB 二进制描述符为什么比对快、BRIEF 为什么需要旋转补偿
- 按任务在 SIFT、ORB 之间做出有依据的选择
- 读懂描述符矩阵的形状含义与 dtype 约定
先跑起来:两行拿到描述符
import cv2 img = cv2.imread('box.jpg', cv2.IMREAD_GRAYSCALE) sift = cv2.SIFT_create() kp1, des1 = sift.detectAndCompute(img, None) # None 表示不用掩码 orb = cv2.ORB_create(nfeatures=1000) kp2, des2 = orb.detectAndCompute(img, None) print(des1.shape, des1.dtype) # 例如 (823, 128) float32 print(des2.shape, des2.dtype) # 例如 (1000, 32) uint8
两个输出结构相同、内容迥异。kp 是关键点对象列表(坐标、尺度、方向、响应强度),des 是描述符矩阵——每行对应一个关键点。SIFT 的矩阵是 N 行 128 列的 float32,每个描述符是 128 维浮点向量;ORB 是 N 行 32 列的 uint8,每行 32 个字节、256 个比特位,每 bit 是一次邻域亮度比较的结果。形状与 dtype 的差异背后是两套完全不同的编码哲学,也是浮点距离与汉明距离的分野——直接决定下一节匹配器怎么选。
画出来看看检测到的关键点长什么样:
vis = cv2.drawKeypoints(img, kp1, None, flags=cv2.DRAW_RICH_KEYPOINTS)
RICH 标志会画出每个点的圆圈(半径即尺度)与短线(方向即主方向),SIFT 的"带方向的圆"一眼就能看懂。
核心原理:从邻域到可比对的编码
2.1 SIFT:一部精密的编码机器
SIFT(尺度不变特征变换)要同时解决四个问题:换了尺度、转了角度、变了亮度、换了视角,描述符还得"认得出同一个点"。它分三步走。
第一步,尺度空间定位。同一物体在两张图里大小不同,固定窗口的检测必然错位(上一节实验 4 已验证)。SIFT 的解法是把图与不同 σ 的高斯核卷积、再相邻层相减得到差分高斯(近似拉普拉斯),堆成一个金字塔;在"空间 × 尺度"的三维立方体里找局部极值,极值点的三个坐标就是位置加尺度——窗口大小随物体大小自适应,尺度不变性由此而来。
第二步,主方向分配。在关键点邻域内统计梯度方向直方图,取峰值方向作为该点的"主方向",此后所有计算都以主方向为坐标原点。图像旋转时主方向跟着转,局部坐标系同步旋转——旋转不变性由此而来。drawKeypoints 里那根短线画的就是它。
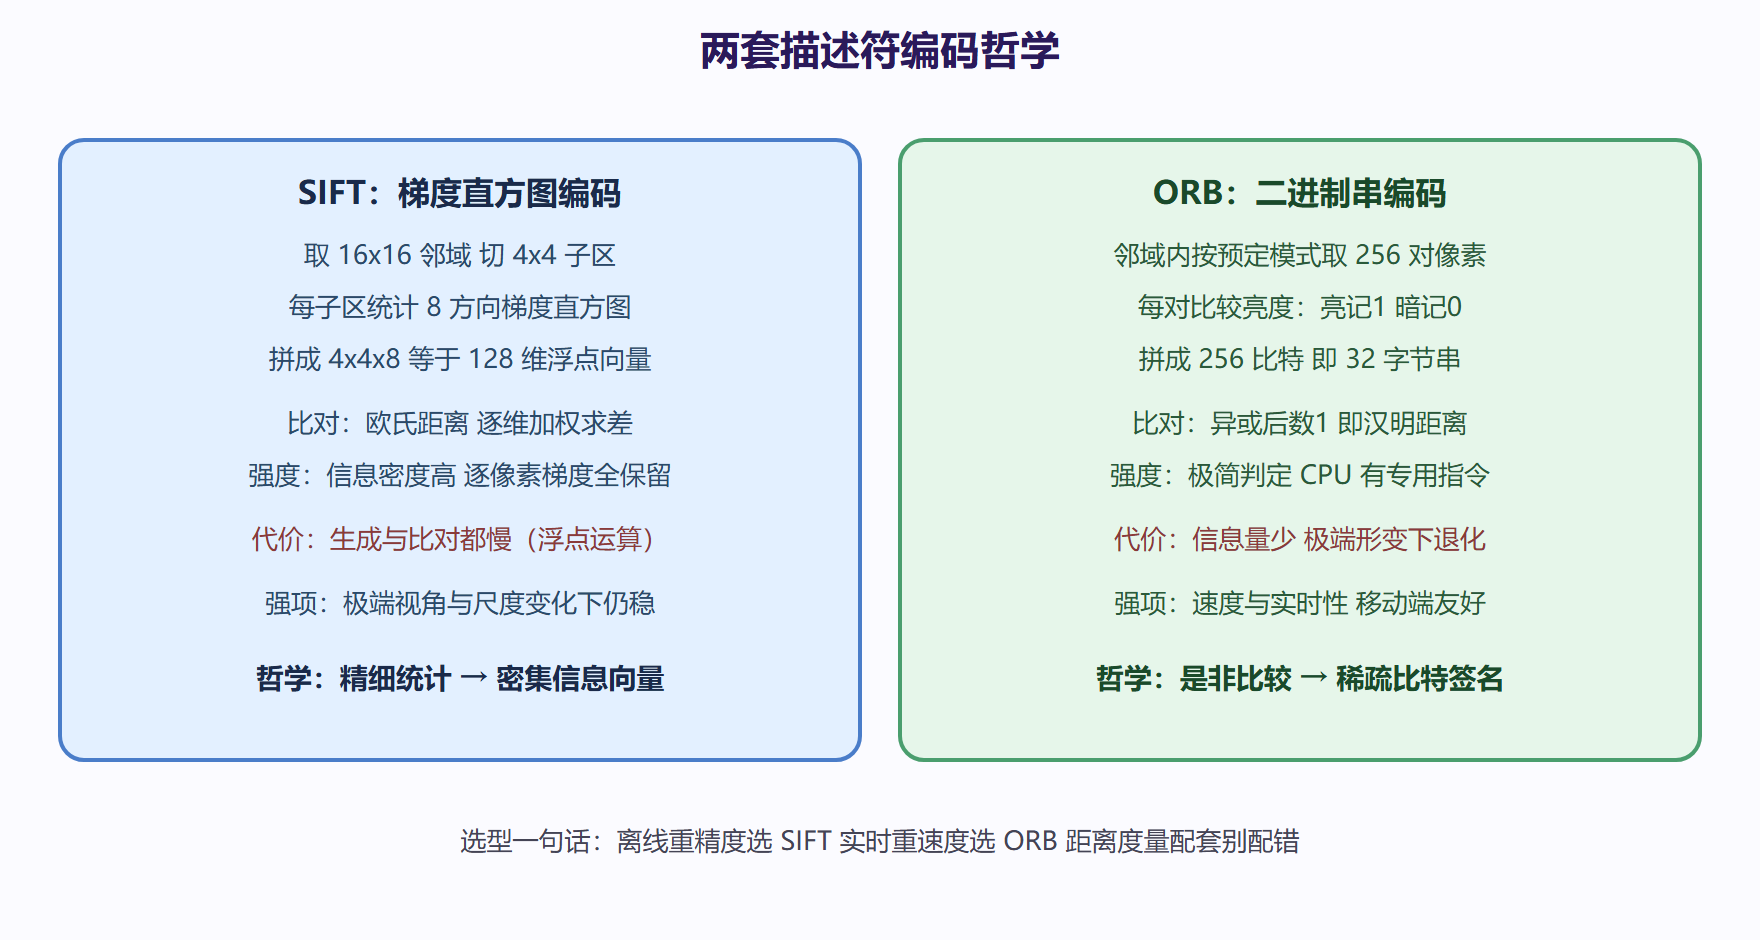
第三步,梯度直方图编码。以关键点为中心取 16×16 邻域,切成 4×4 个子区,每个子区统计 8 个方向的梯度直方图,拼接成 4×4×8 = 128 维向量。梯度对亮度平移天然不敏感(差分消掉常数),再归一化并把过大的分量截断(抑制非线性光照突变),鲁棒性最后一环扣上。
128 维浮点向量之间的相似度用欧氏距离衡量,越近越像。这套 1999 年由 David Lowe 提出的方案至今仍是精度标杆,代价是计算量大——每个点都要金字塔加直方图全套伺候。
2.2 ORB:把"像不像"变成"几个比特不同"
ORB(Oriented FAST and Rotated BRIEF)是 2011 年为实时场景打造的组合拳:检测环节用 FAST(快),加 Harris 打分排序取质量最高的前 N 个,再加金字塔实现尺度层、加灰度质心法算主方向;描述环节用 BRIEF——在邻域里按预定模式取成对的像素点,比较亮度,亮者为 1 暗者为 0,256 对比较拼成 256 bit 的二进制串。ORB 的"O"与"R"正是给 FAST 与 BRIEF 补上方向与旋转:BRIEF 原版一旋转就乱套,ORB 按主方向把采样模式整体旋转后再比较,救回了旋转不变性。
二进制串的比对只要做异或再数 1 的个数(汉明距离),CPU 有专门指令,比 128 维浮点距离快一个数量级——这是 ORB 速度的第二来源(第一是 FAST 检测)。移动端、无 GPU 的实时跟踪、上万点规模的批量匹配,都是 ORB 的主场。
2.3 选型三维表
| 维度 | SIFT | ORB |
|---|---|---|
| 精度与鲁棒性 | 高:尺度旋转光照全面覆盖 | 中:极端视角与大尺度变化下退化 |
| 速度 | 慢(数量级差距) | 快,实时可行 |
| 描述符形态 | 128 维 float32 | 32 字节二进制串 |
| 距离度量 | 欧氏距离 | 汉明距离 |
| 专利状态 | 2020 年 3 月已到期,可自由商用 | 开源无负担 |
| 典型场景 | 离线配准、三维重建、图像拼接 | 移动端、实时 AR、视频跟踪 |
SURF 不在表里单列:它曾是 SIFT 的提速版,长期受专利保护,多数 OpenCV 发行包已不包含,新项目没有理由再选它。
描述符生成流水线
工程实践要点
3.1 接口版本差异
SIFT 的接口位置随版本迁移过:4.4 以后主模块直接 cv2.SIFT_create(),更老版本在 contrib 的 xfeatures2d 下。报"没有该属性"先查版本(第 1 章第 2 节的排查表),再决定升级包还是改代码。ORB 的 nfeatures 参数是产出上限,默认 500 往往不够用,按场景给到 1000–5000。
3.2 关键点质量决定匹配上限
描述符再好也救不住糟糕的关键点。检测前的两步预处理(轻度高斯平滑、必要的对比度拉伸)常比换描述符更见效。另一个实用技巧:drawKeypoints 先可视化看一眼分布,点全挤在背景纹理上就调 mask 或加大 goodFeaturesToTrack 式的间距控制。
3.3 描述符数量的匹配预算
1000 对描述符暴力匹配是 100 万次距离计算,SIFT 浮点距离在 CPU 上要几秒;ORB 汉明距离毫秒级。预算紧张时的两个选择:用 FLANN 加速(下一节),或先降采样减少关键点数量。"匹配慢"的锅常常不在匹配器,在特征点给太多。
⚠️ 常见坑:把 SIFT 描述符喂给按汉明距离算的匹配器(或反之)。NormTypes 对不上,距离全是无效值,匹配结果看起来"能跑但全是错的"。口诀:浮点描述符配 NORM_L2,二进制描述符配 NORM_HAMMING,一一对应别混。
3.4 动手实验清单
- 同一张图分别用 SIFT 与 ORB 检测描述,drawKeypoints 对比数量与分布。
- 把图旋转 30 度再做一次,对比两种描述符的关键点主方向是否同步旋转。
- 缩小到 50% 再做一次,观察 ORB 关键点数量的衰减与 SIFT 的尺度自适应。
- 打印两种描述符矩阵的 shape 与 dtype,写下它们分别该配哪种距离度量。
3.5 两套编码哲学的对照全景
SIFT 与 ORB 编码机制对比
3.6 常见疑问与解答
描述符维度越高越准吗?
在合理范围内是的(16 维与 128 维的 SIFT 差距明显),但边际递减且伴随代价:维度翻倍计算翻倍、样本不足时高维空间里的距离反而失去区分度(维度灾难)。ORB 的 256 比特是大量实验的甜点位——再长,速度优势被侵蚀,精度收益趋零。
同一张图能混用两种描述符吗?
技术上可行(各自匹配后合并结果),实践上极少这么做——两套距离度量无法直接比较远近,合并逻辑复杂且收益模糊。选定一种贯穿全流程,是更工程化的选择。
主方向估计错了会怎样?
描述子整体"转错角度",与正确描述的距离骤增,表现为匹配漏配。纹理环形对称的目标(车轮、圆桌)主方向天然不稳定,是匹配漏检的常见场景——这类目标上 ORB 的旋转补偿反而是负担,可考虑关掉方向的 BRIEF 变体或换方法。
3.7 实战配方:一次完整的检测描述实验
跑一遍对照实验,把本节所有概念落到实测数据上,比读三遍正文有效。
实验设置:同一物体( textured 的盒子或书)拍三张图——原图、旋转三十度、缩小到一半。三张图各跑 SIFT 与 ORB,记录六个指标:关键点数量、检测耗时、描述耗时、描述符矩阵形状。
预期结果与解读:SIFT 的关键点在缩放图上衰减明显少于 ORB(尺度空间的直接证据);ORB 的两项耗时快一到两个数量级(二进制编码的功劳);旋转图上两者的主方向标记都同步偏转(drawKeypoints 的短线可视化)。
进阶一步:把三张图两两配对做第 3 章第 3 节的匹配流程,记录比率测试后的匹配数与 RANSAC 内点数。你会得到一张直观的"形变容忍度"表:原图对旋转图匹配数尚可,对缩小图骤减——这正是"ORB 对大尺度变化退化"的量化版本,也是选型时该背下来的经验数字。
这份实验的价值不止于验证结论,更在于它给了你一套"新场景快速评估"的方法:换任何目标、任何拍摄条件,跑同套实验,十分钟内得到"选哪种描述符、能容忍多大形变"的实测答案。工程选型靠数据不靠信仰,这个实验就是你的数据源。
本节要点回顾
- 检测与描述是两个环节:检测给位置尺度方向,描述把邻域编码成可比对的向量或比特串。
- SIFT 三步走:尺度空间定位、主方向对齐、4×4×8 梯度直方图编码,四大不变性各有出处。
- ORB 组合拳:FAST 加方向、BRIEF 加旋转、汉明距离加速,实时场景默认。
- 矩阵形态即路线:float32 的 128 维走欧氏距离,uint8 的 32 字节走汉明距离,距离类型不能配错。
- SURF 已无必要:专利与发行包双重出局,新项目在 SIFT 与 ORB 之间二选一即可。
- 预处理决定上限:平滑与对比度准备常比换算法更见效,检测分布先可视化再谈调参。
常见追问:描述符到底在描述什么
把以角点为中心的一小块邻域,按某种统计规则压缩成一个固定长度的向量。SIFT 把邻域切成四乘四的小格,每格统计八个方向的梯度直方图,拼出一百二十八维;ORB 则拿某个二值模式在邻域里做一系列亮度比较,比较结果直接排成二百五十六位的比特串。理解了这一点,很多性质就自明了:SIFT 是浮点向量,比对靠欧氏距离,精度高但算得慢;ORB 是二值串,比对靠汉明距离,一条 CPU 指令能比好多个维度,速度优势由此而来。
顺带回答"为什么要归一化"。SIFT 匹配前常对描述符做归一化,消掉整体亮度的影响;ORB 依赖亮度比较,本身就对单调光照变化有容忍度,但对比度太低时比较结果会变成噪声。所以特征数量上不去时,除了调检测参数,拉一拉对比度预处理经常立竿见影。
描述符到手,下一节让两张图的特征"对上号":BF 与 FLANN 两种匹配器、Lowe 比率测试、RANSAC 提纯,一条完整的匹配流水线。
另外提醒一句:SIFT 与 ORB 的描述符不要互相混着匹配,两者的度量空间完全不同,BFMatcher 里 normType 一定要对上——浮点用 NORM_L2,二值串用 NORM_HAMMING,写错不报错但结果是噪声。