3.3 特征匹配
3.3 特征匹配
本节摘要:匹配是"检测—描述"之后的关键一跃:在两组描述符之间找对应关系。本节讲 BF 暴力匹配与 FLANN 近似匹配两条路线,重点是 Lowe 比率测试如何用一个阈值砍掉大部分误匹配,以及 RANSAC 用几何一致性提纯出单应矩阵,支撑图像拼接与物体定位。核心结论:匹配质量七分靠筛选,三分靠匹配器。
本节要解决的问题与目标
阅读完本节,你应当能够:
- 写出"检测描述 → BF 匹配 → 比率测试 → 可视化"的完整流程
- 解释比率测试为什么能识别"模棱两可"的匹配
- 说清 FLANN 的加速思路与适用前提
- 用 RANSAC 估计单应矩阵并理解它的迭代逻辑
- 用 warpPerspective 完成一次简单的图像拼接
先跑起来:完整匹配流程
两张图:一张物体特写(模板),一张包含该物体的场景。目标是在场景里找到物体并画框。完整流程不过二十行:
import cv2 img1 = cv2.imread('box.jpg', cv2.IMREAD_GRAYSCALE) # 模板 img2 = cv2.imread('scene.jpg', cv2.IMREAD_GRAYSCALE) # 场景 sift = cv2.SIFT_create() kp1, des1 = sift.detectAndCompute(img1, None) kp2, des2 = sift.detectAndCompute(img2, None) bf = cv2.BFMatcher() matches = bf.knnMatch(des1, des2, k=2) # 每个描述符找前2近邻 good = [] # 比率测试 for m, n in matches: if m.distance < 0.75 * n.distance: good.append(m) vis = cv2.drawMatches(img1, kp1, img2, kp2, good[:50], None, flags=cv2.DrawMatchesFlags_NOT_DRAW_SINGLE_POINTS)
先跑不筛的版本(直接用 matches 画线),再跑比率测试版本对比:前者的连线像一团乱麻,大量线飞向错误的区域;后者只剩下干净的几十条近平行的连线。一个阈值 0.75 就干掉了大多数错误,这是整个匹配环节性价比最高的一行代码。
核心原理:从距离排序到几何一致
2.1 匹配器做的事:给每个描述符找邻居
BF(Brute-Force)暴力匹配对第一组每个描述符,遍历第二组全部描述符算距离,按远近排序。knnMatch 的 k=2 表示"顺便把第二近的也带回来"——第二近的距离是比率测试的关键参照。crossCheck=True 是另一个筛选开关:只有互为最近邻(A 的最近是 B,B 的最近也是 A)的对子才保留,筛得干净但会减少匹配数,与比率测试二选一即可,叠加使用收益有限。
FLANN 走近似路线:预先为第二组描述符建一棵 KD 树式的索引,查询时只探索最有希望的分支,不保证全局最近邻,但快得多。SIFT 这类浮点描述符上万条时,BF 要秒级,FLANN 毫秒到百毫秒级。代价是近似偶有漏配,参数(索引与搜索配置字典)也需要理解成本。经验法则:特征少于几千对用 BF(反正快),上万或需要实时再用 FLANN。注意 ORB 的二进制描述符要用 FLANN 的 LSH 索引配置,KD 树是给浮点向量用的。
2.2 比率测试:识别"模棱两可"
一个描述符在对面图里找最近邻,距离 0.30,看起来不错;但第二近邻距离 0.32——两个候选几乎一样近,说明这个特征"长得很大众",在对面有多个相似结构(重复纹理、对称图案),选谁都是赌博。Lowe 的比率测试拒绝这种匹配:只有最近邻显著近于第二近邻(0.30 < 0.75×0.32 不成立,此例被拒),才认为匹配是"独一无二"的。0.75 是 Lowe 论文的建议值,误匹配多时降到 0.6–0.7 收紧,匹配数太少时放宽到 0.8。
这个测试揭示了一个重要认知:误匹配的根源常常不是算法弱,而是图像内容本身有歧义。格子衬衫、百叶窗、印刷文字这类重复纹理,任何描述符都会给出"多候选",比率测试的作用是把这类不可靠的匹配主动放弃,宁缺毋滥。
2.3 RANSAC:用几何一致性做终审
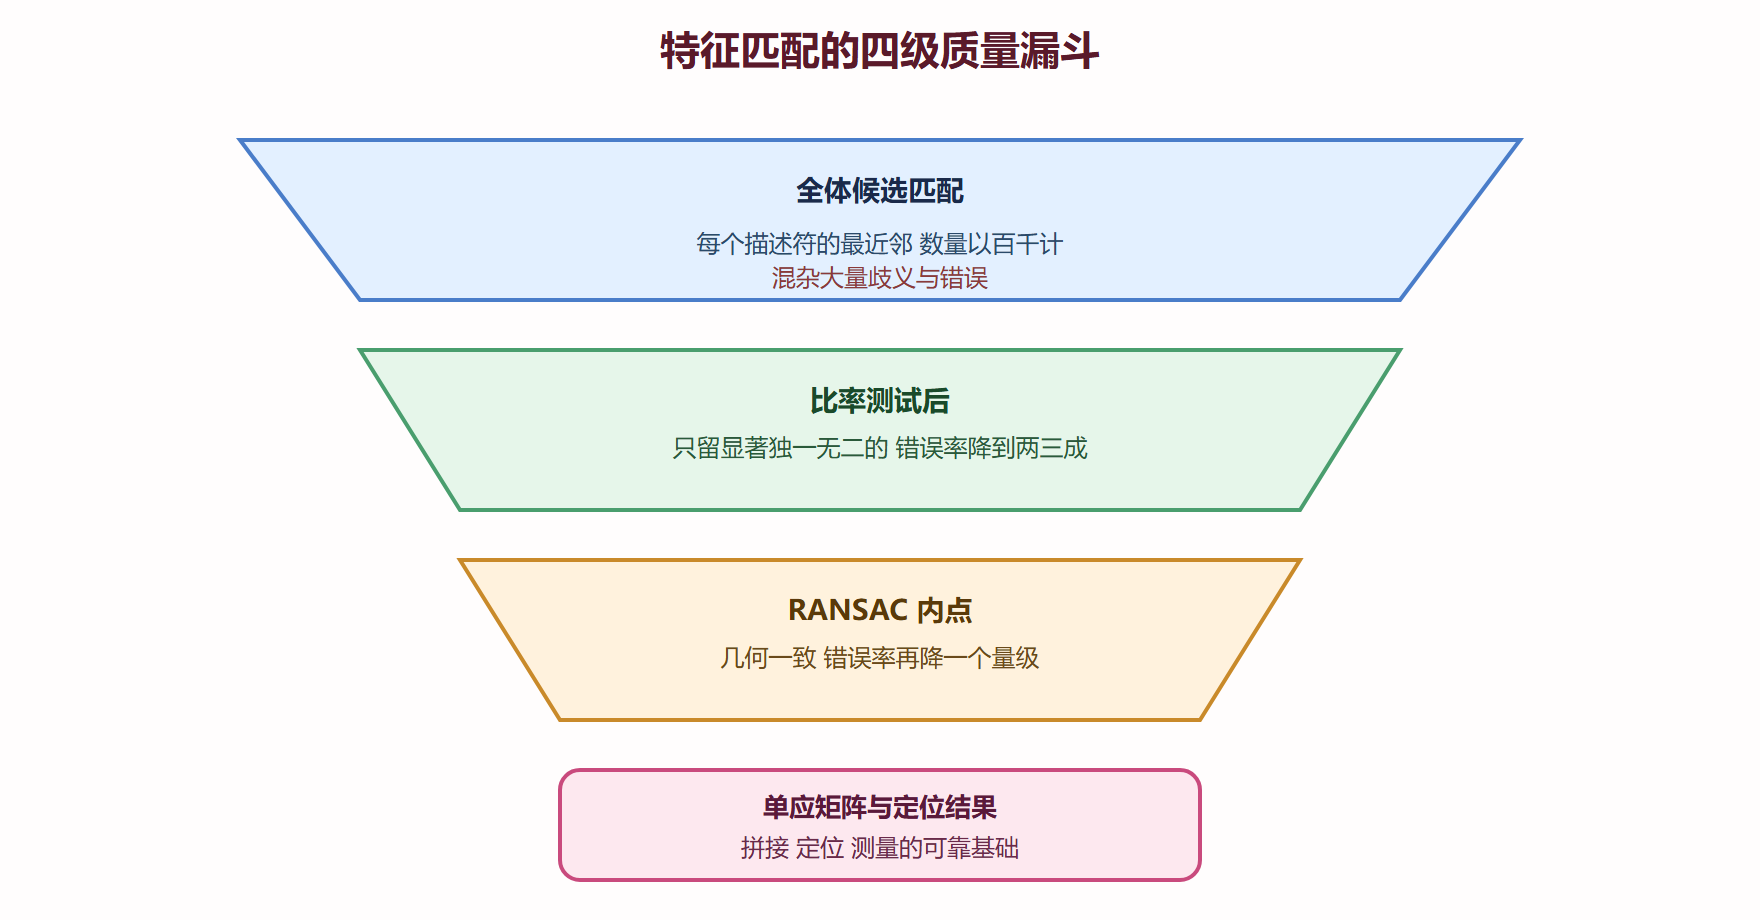
比率测试后剩下的几十对匹配,仍可能混着百分之几到几十的错误。人眼看连线"大体平行"就能判断匹配靠谱,机器的版本是几何模型:如果两组点来自同一平面的同一物体,它们之间应满足一个 3×3 的单应矩阵变换(第 2 章第 2 节的透视变换矩阵正是它)。
RANSAC(随机抽样一致)的逻辑像审稿:随机抽 4 对匹配算一个候选单应矩阵;用候选矩阵检查所有匹配,数一数"误差在阈值内的支持者"有几个;重复几百轮,支持者最多的矩阵当选,支持它的匹配集叫内点,其余判为外点(误匹配)。findHomography 一行完成这一切:
import numpy as np src = np.float32([kp1[m.queryIdx].pt for m in good]).reshape(-1, 1, 2) dst = np.float32([kp2[m.trainIdx].pt for m in good]).reshape(-1, 1, 2) H, mask = cv2.findHomography(src, dst, cv2.RANSAC, 5.0)
返回的 mask 标记内点,用它过滤 good 即得"几何一致"的最终匹配集。有了矩阵 H,把模板的四个角经透视变换投到场景图上,就是物体定位框——本节开头的目标达成:
h, w = img1.shape corners = np.float32([[0,0],[w,0],[w,h],[0,h]]).reshape(-1,1,2) projected = cv2.perspectiveTransform(corners, H) cv2.polylines(scene_color, [np.int32(projected)], True, (0,255,0), 3)
工程实践要点
3.1 三个环节的质量配比
一条经验:匹配失败时按"图像内容 → 筛选阈值 → 匹配器"的顺序排查。多数"匹配不准"其实是内容歧义(重复纹理、视角太大、光照太暗)或比率阈值太松;匹配器本身(BF 还是 FLANN)几乎从不是瓶颈。把调参精力放在 0.75 这个数字和检测质量上,回报最高。
3.2 图像拼接的最小闭环
匹配流水线的招牌应用是拼接:找匹配 → 单应矩阵 → warpPerspective 把第二张图按矩阵变换到第一张的坐标系 → 拼接画布上叠加。两图重叠度建议 30% 以上,重叠太少匹配点不足,矩阵不稳。拼接缝的处理(简单直接叠加或用多频段融合)超出本节范围,但"匹配 → 矩阵 → 变换"的骨架就是这里的三行代码。
3.3 匹配数多少才够
定位单个刚性物体:比率测试后 10 对以上、RANSAC 内点 8 对以上,通常就稳了。图像拼接或三维重建:要求数十到数百对均匀分布的匹配。低于下限时的补救顺序:先放宽比率阈值到 0.8、增加特征点数量(nfeatures 或 qualityLevel),最后才考虑换描述符。
⚠️ 常见坑:queryIdx 与 trainIdx 弄反。knnMatch(des1, des2) 里,匹配对的 queryIdx 索引 des1 的关键点、trainIdx 索引 des2——方向一反,单应矩阵的变换方向也反,warp 出的图完全错位。另一个坑是距离度量与描述符不配(第 3 章第 2 节的口诀:浮点配 L2、二进制配 HAMMING),错误往往不报错但结果全废。
💡 关键直觉:drawMatches 的连线形态是最好的诊断仪。内点连线应大体平行、长度均匀(刚体变换下);连线交叉杂乱说明混入大量外点;连线短而密但不平行,可能是两张图几乎没变换,也可能模型退化。先看图再调参,永远比盲调快。
3.4 动手实验清单
- 同一对图分别画"未筛选 / 比率测试后 / RANSAC 内点"三张匹配图,数一数错误连线的递减。
- 把比率阈值从 0.6 扫到 0.9,记录匹配数与目测准确率,找你这对图的最佳点。
- 故意用重复纹理图(格子布、键盘)做匹配,观察比率测试的大幅淘汰——体会"内容歧义"。
- 完成一次两图拼接:H 矩阵 → warpPerspective → 画布叠加,检查接缝处是否对齐。
3.5 匹配流水线的质量漏斗全景
从特征到几何一致的四级漏斗
3.6 常见疑问与解答
比率测试与 crossCheck 能同时用吗?
语法上能(crossCheck 在构造 BFMatcher 时开,比率测试在结果上筛),但两者都在做"确认匹配唯一性"的同类工作,叠加只会进一步减少数量、少量提升精度,一般二选一。我的默认:比率测试,因为它有个连续可调的旋钮,工程上更顺手。
匹配点在图上分布不均有什么影响?
单应矩阵的估计依赖匹配点的空间覆盖:点全挤在一角时,矩阵在该区域外是"外推"而非"拟合",矫正或拼接在远处会明显变形。第 3 章第 1 节的均匀采样对策在此复用,另外 findHomography 前可按网格粗略平衡一下点的分布。
两张图视角差很大还能匹配吗?
手工特征的舒适区在视角差三四十度以内,再大就需要"中间图"桥接——拍一张中间角度的过渡图,分别匹配再传递对应关系,多图拼接的骨架就是这种链式匹配。深度特征对大视角的耐受度更高,但桥接思路依然通用。
单应矩阵能用于非平面目标吗?
严格不能。单应描述的是平面在两视图间的映射,非平面目标(不同深度的点)不满足同一矩阵。实践中"目标近似平面"(贴墙的海报、桌上的卡片)时用起来没问题;深度差异大的场景要做三维重建(本质矩阵、三角化),超出本教程范围,但入口概念都在本章。
3.7 实战配方:物体定位的完整交付流程
把本节所有环节组装成"拿模板图在场景图中框出物体"的交付级流程。
第一步素材准备。模板图要"满框、干净":目标占满画面、无背景杂边(有杂边就先裁掉);场景图的光照与分辨率和模板不要差太远。素材质量差的 matcher 谁也救不了,这条比所有参数都重要。
第二步特征与匹配配置。ORB 加 BF(汉明距离)起步——快速跑通全流程;精度不达标再换 SIFT 加 FLANN。比率阈值 0.75,先不做任何"优化"。
第三步提纯与矩阵。findHomography 的 RANSAC 阈值按重投影误差给,5 像素是惯例;内点数低于 8(本节 3.3 的下限)直接判定失败,返回"未找到",不要硬出结果。
第四步交付与诊断信息。输出定位框之外,把"匹配总数、比率测试后数量、内点数"三个数字一起返回——它们是线上问题的第一手诊断数据(定位失败时区分"没匹配上"还是"匹配了但几何不一致")。
第五步失败案例回流。线上失败的样本攒起来人工看:重复纹理、视角过大、分辨率失配三类占绝大多数,对应的改进(换描述符、加中间视角模板、统一分辨率)各有明确动作。做到这一步,匹配模块就从"能跑的代码"变成了"可运维的系统"。
本节要点回顾
- 匹配七分靠筛选:比率测试与 RANSAC 两道闸门的贡献大于匹配器本身的选择。
- 比率测试拒绝歧义:最近邻不显著优于第二近邻即弃,0.75 起步,宁缺毋滥。
- BF 与 FLANN 分工:几千对以内用 BF 简单可靠,上万或实时用 FLANN(二进制描述符配 LSH 索引)。
- RANSAC 用几何终审:随机抽 4 对拟合单应矩阵,选支持者最多者,内点即最终匹配。
- 单应矩阵是副产品:findHomography 既提纯匹配又给出变换模型,直接支撑定位框与图像拼接。
- 诊断先看连线图:平行均匀为佳,交叉杂乱为外点,先看图再调参。
特征匹配解决了"两张静态图里找同一物体"。下一章把视野放大到"在一张图里找出所有目标"——从老当益壮的 Haar 级联讲到深度学习的 YOLO。
常见追问:匹配点最少要几对才可信
估计单应矩阵理论下限是四对,但四对点没有任何冗余,一对误匹配就把结果带偏。工程上我要求至少十对以上内点再谈单应,二十对以上才敢做拼接;少于这个数宁可放弃,改用更鲁棒的跟踪或检测方案。另一个信号是内点占比:RANSAC 之后内点低于一半,说明两图重叠区太小或视角差太大,继续硬算只会得到一个看起来合理、实际错误的变换,这种"自信的错误"比报错危险得多。