4.1 传统对象检测方法
4.1 传统对象检测方法
本节摘要:深度学习普及之前,对象检测靠"手工特征加分类器"的组合拳:Haar 特征加级联分类器统治人脸检测二十年,HOG 加 SVM 是行人检测的经典答案。本节跑通 CascadeClassifier 与 HOGDetectMultiScale,拆解 Haar 的积分图加速与"早期拒绝"级联机制、HOG 的梯度直方图块设计,最后给出传统方法在低算力场景的坚守理由。
学习目标
阅读完本节,你应当能够:
- 加载预训练 Haar 级联并完成人脸与眼睛检测
- 解释积分图如何把任意矩形区域求和降到四次查表
- 说清级联"早期拒绝"机制为什么带来数量级的提速
- 用 HOGDescriptor 的默认行人模型完成行人检测
- 判断一个具体项目该用传统方法还是直接上深度模型
先跑起来:人脸检测十行
OpenCV 自带一批训练好的 Haar 级联模型,装好即用:
import cv2 face_cascade = cv2.CascadeClassifier( cv2.data.haarcascades + 'haarcascade_frontalface_default.xml') img = cv2.imread('group.jpg') gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY) faces = face_cascade.detectMultiScale(gray, scaleFactor=1.1, minNeighbors=5, minSize=(60, 60)) for x, y, w, h in faces: cv2.rectangle(img, (x, y), (x + w, y + h), (0, 255, 0), 2)
cv2.data.haarcascades 指向安装包内置的模型目录,免下载。对一张合影跑这段代码,每张正脸都会得到一个绿框。两个参数直接决定体验:scaleFactor 控制多尺度搜索的步长(每轮放大 1.1 倍再扫一遍),minNeighbors 要求一个候选区域被多少个"邻居级联层"确认才上报——它就是置信度旋钮,误框多就调大,漏检多就调小。
HOG 行人检测同样现成:
hog = cv2.HOGDescriptor() hog.setSVMDetector(cv2.HOGDescriptor_getDefaultPeopleDetector()) rects, weights = hog.detectMultiScale(img, winStride=(8, 8))
内置的 SVM 权重是 Dalal 与 Triggs 那套经典行人模型的复刻,对站立、全身、姿态标准的行人效果尚可。
核心原理:手工特征的两座高峰
2.1 Haar 特征:用明暗对比画"五官"
Haar 特征是一组黑白相邻的矩形模板:两个矩形"亮区减暗区",三个矩形的组合,四个矩形的对角组合。把它们扣在人脸上:眼睛区域比脸颊暗(水平二矩形特征可捕捉),鼻梁比两侧亮(垂直二矩形特征可捕捉)。每个特征输出一个数——黑白区平均灰度之差,这个数就是分类的依据。
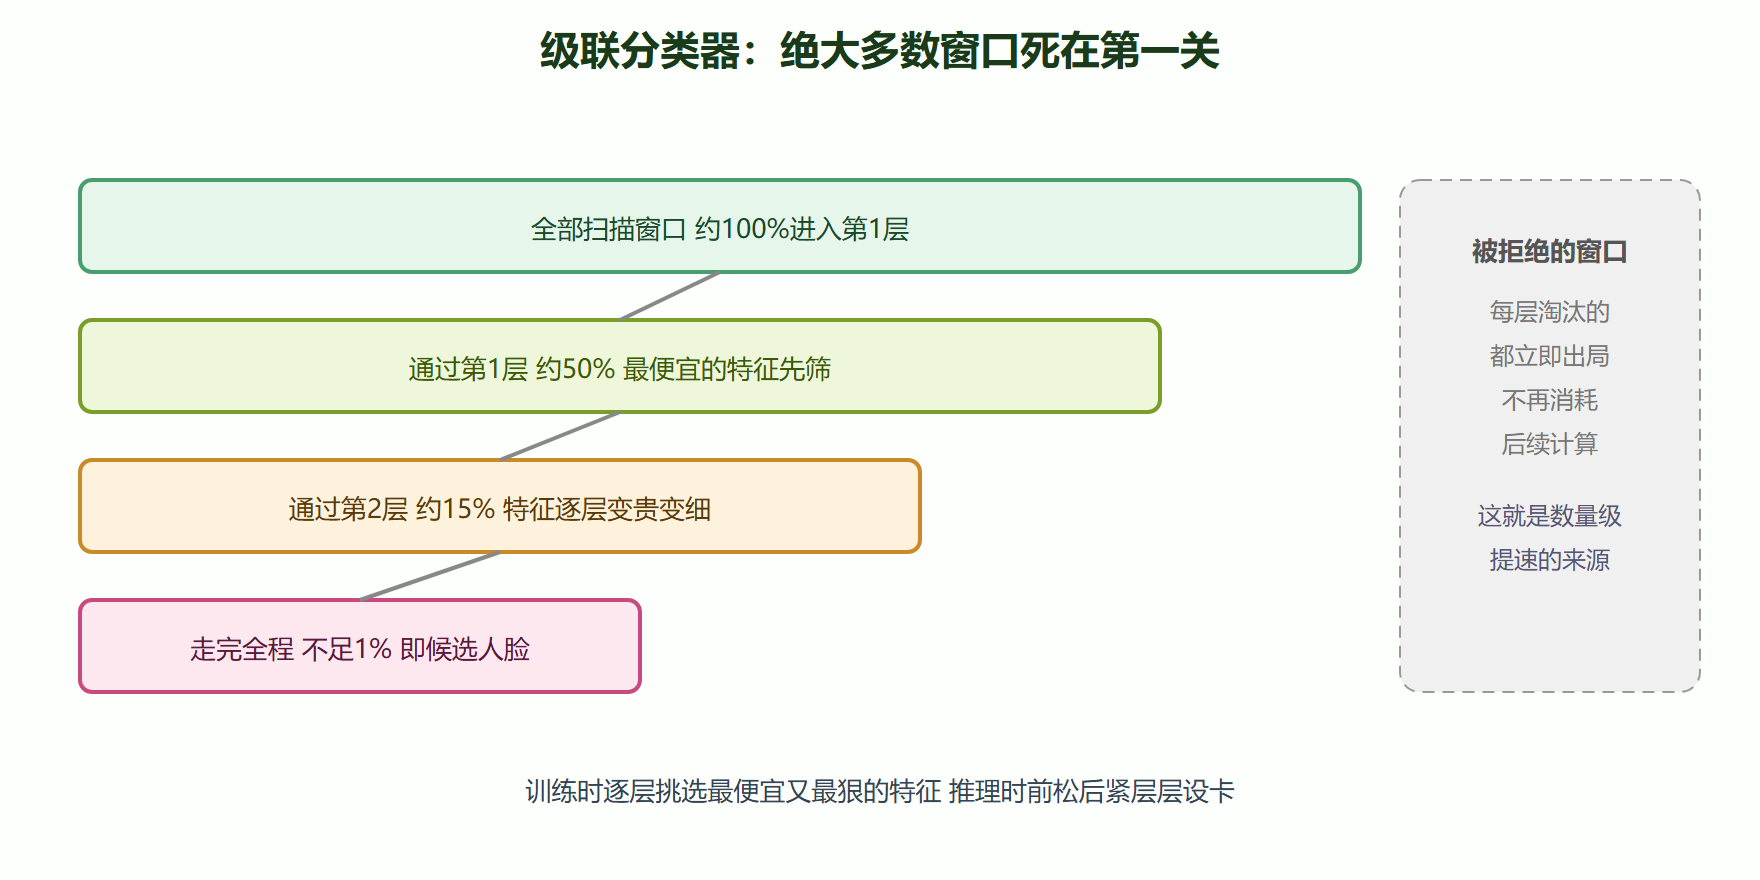
问题是计算量:一个 24×24 的检测窗口里有超过 16 万种位置尺寸组合的特征,逐个求和是不可行的。2001 年 Viola 和 Jones 论文的两大发明解决了它。第一个是积分图:预计算一张"左上角到此处累计和"的图,之后任意矩形区域的灰度和都能用四个角的查表值加减得到——不管矩形多大,代价恒定。第二个是级联分类器:把成千上万个弱分类器排成一条流水线,前几层用最便宜、最有区分力的特征把"明显不是脸"的窗口立刻枪毙,越往后检查越细。一张图中 99% 以上的位置是背景,级联让它们在前两三层就被淘汰,只有极少数"疑似人脸"走完全程——整体速度因此提升几个数量级,这才有了 2001 年硬件上的实时人脸检测。
代价也很清楚:级联是在"正脸、光照正常、无遮挡"的数据上训练的,侧脸、戴墨镜、大角度俯仰都会大量漏检;且一个模型只认一种目标(人脸模型不认行人),换目标要重新训练,训练流程(正负样本收集、opencv_traincascade 工具链)远比推理复杂。
2.2 HOG 加 SVM:梯度统计出"人的形状"
HOG(方向梯度直方图)换一条思路:不比明暗,比"边缘的方向分布"。计算全图每个像素的梯度(第 2 章第 5 节的 Sobel),把图切成小格(cell,典型 8×8),每格统计 9 个方向的梯度直方图;再把相邻格子组成块(block)做归一化以抵抗光照变化,最后所有块的直方图串成几千维的特征向量,交给 SVM 分类器判断"这块是不是人"。
HOG 的洞察在于:物体的形状信息集中在梯度方向上,而对光照鲁棒的秘诀是局部归一化。行人之所以适合 HOG,是因为人体轮廓(头肩、直立的双腿)产生稳定的垂直边缘模式,在梯度方向统计里呈现稳定的"指纹"。detectMultiScale 的 winStride 参数控制滑动窗口的步进密度:步子大速度快但可能跳过紧凑人群中的目标,(4,4) 与 (8,8) 是常见的两个档位。
2.3 两座高峰的对比
| 维度 | Haar 级联 | HOG 加 SVM |
|---|---|---|
| 特征内容 | 明暗矩形对比 | 梯度方向直方图 |
| 加速机制 | 积分图加级联早期拒绝 | 积分直方图、粗步进 |
| 擅长目标 | 正脸、刚性目标 | 行人等轮廓稳定的直立目标 |
| 弱点 | 侧脸遮挡漏检、误报依赖参数 | 形变姿态适应性差、密集场景重叠框多 |
| 训练成本 | 样本需求大、工具链繁琐 | 特征固定、只需训 SVM,相对轻 |
工程实践要点
3.1 参数调试顺序
detectMultiScale 误框多:先调 minNeighbors(5 到 8),再考虑 scaleFactor 收细到 1.05;漏检多:反向操作,并确认 minSize 没把目标挡在门外。HOG 的重叠框问题用非极大值抑制(NMS)解决——同一目标被相邻窗口多次命中,留下分数最高的框、抑制重叠过高的邻居。OpenCV 的 DNN 模块自带 NMS,传统 HOG 要手写或用现成实现(重叠率阈值 IoU 取 0.5 左右是惯例,第 4 章第 2 节详述 IoU)。
3.2 预处理的小改善
Haar 检测前做直方图均衡化(equalizeHist)对暗光与逆光场景常有立竿见影的改善——级联是在均衡化后的数据上训练的,推理时保持同样的预处理是常识也是细节。
3.3 传统方法何时仍是首选
深度模型不是万能替代。三种场景我仍会选传统方案:一是算力预算极紧(低端 ARM、无 NPU 的微控制器级别),Haar 检测一张 VGA 图只要几毫秒,轻量 CNN 也做不到这个量级;二是场景完全可控(固定机位、固定光照、目标姿态单一,如产线上的标准件),传统方法调好参数后误报率可以压得极低,且模型小到几十字节的 XML;三是数据稀缺,收集不到训练深度模型的样本时,预训练的 Haar 与 HOG 模型零样本成本直接可用。反过来,目标类别多、姿态复杂、场景开放,就直接跳到下一节的 DNN 方案,不必在传统方法上硬磨。
⚠️ 常见坑:CascadeClassifier 加载失败不报错,detectMultiScale 返回空列表——模型文件路径错了(cv2.data.haarcascades 拼接时少了斜杠或文件名拼错),你会以为是图的问题查半天。加载后判一下
face_cascade.empty()。另一个坑是拿人脸模型去检测侧脸甚至行人,结果全空就骂算法不行——模型只认它训练过的世界。
💡 关键直觉:级联与 HOG 的共同哲学是"把人类对目标的知识手工翻译成特征"。Haar 翻译的是明暗布局,HOG 翻译的是轮廓走向。深度学习的革命性在于让网络自己学这个翻译——理解这条主线,第 4 章第 2 节的对比就水到渠成。
3.4 动手实验清单
- 用同一张合影分别跑 scaleFactor 1.05 / 1.1 / 1.3,记录检测数与耗时的变化。
- minNeighbors 从 2 扫到 10,观察误框消失、漏检出现的过程,选你那张图的平衡点。
- 手遮半张脸再跑人脸检测,验证遮挡下的漏检;转头 45 度再试,验证侧脸问题。
- 跑 HOG 行人检测并自己实现一个简单 NMS(按重叠率合并),对比前后框的数量。
3.5 级联检测的流程透视
Haar 级联的早期拒绝机制
3.6 常见疑问与解答
Haar 和 HOG 一起用会不会更好?
很少这么组合,两者是同位竞争关系(都是"手工特征加分类器"的完整方案),不是上下游互补。实践中更常见的组合是"HOG 检测候选加第二级分类器复核"——检测给框、复核给精细标签,衔接处在第 4 章第 3 节的分类环节。
训练自己的级联要多少样本?
经验量级:正样本几千张(含各种光照姿态),负样本可以更多(万级不嫌多)。采集与标注的功夫占大头,训练本身半天到一天。样本多样性不足是训练失败的常见原因——用同一角度同一光照的几百张图训练,出来的模型换个场景就废。
为什么 OpenCV 只自带人脸眼睛这些模型?
预训练模型的发行受目标常见度与训练成本双重筛选,人脸是最普及的需求。其它目标(车牌、行人)社区有第三方模型可寻,但引入第三方文件时注意验证来源与许可,这属于工程合规的基本功。
3.7 实战配方:产线人脸闸机的参数标定
用一个人脸门禁的虚拟案例,演示传统检测从零到交付的标定过程。
场景设定:固定机位、环形补光、人脸距离一到两米。这类"光照可控、姿态单一"的场景正是级联的舒适区。
第一步基线测试。默认参数(1.1 加 5)跑五十张样本,记录三个数:检出率(该检出且检出)、误报数、单帧耗时。这组数字是后续所有调整的对照组,没有对照组的调参是玄学。
第二步误报治理。有误报先升 minNeighbors(5 到 8),再收 scaleFactor(1.1 到 1.05,扫描更细)。每调一档重跑五十张,检出率掉超过两个点就回退——误报与漏检的跷跷板要压在业务容忍度上(门禁场景漏检让人重刷即可,误报是安全事故,压误报优先)。
第三步性能预算。minSize 设为目标最小尺寸(一到两米距离的人脸宽度实测后填入),砍掉小尺度扫描,耗时常见能降一半;确认单帧耗时留出余量(低于分配预算的七成)。
第四步交付固化。把标定好的参数写进配置文件加注释(每组参数对应的实测数据),交付文档里附上五十张样本的测试报告。三个月后现场环境变了(灯换了、机位挪了),重跑第一步的基线测试即可判断是否需要重新标定——参数不是一次定终身,但标定流程是。
本节要点回顾
- 两大件:Haar 特征比明暗对比、HOG 比梯度方向分布,都是把人的先验手工编码成特征。
- 积分图是加速基石:任意矩形求和四次查表,16 万特征的计算从不可行变成实时。
- 级联即早期拒绝:便宜特征先筛掉绝大多数背景,疑似目标才走完全程,速度提升数量级。
- 参数三件套:scaleFactor 管尺度步长、minNeighbors 管置信门槛、minSize 管最小目标,按误报与漏检的跷跷板调。
- 加载失败是静默的:判 empty 防坑,模型文件路径是第一嫌疑人。
- 低算力可控场景零样本:传统方法的三块坚守阵地,别被"深度学习默认论"带走决策。
常见追问:Haar 还能撑多久
取决于场景封闭程度。门禁、考勤、工业流水线这类光照与姿态可控的场景,Haar 加一层尺寸过滤,依旧又快又稳,树莓派级别算力就能跑满帧率;开放街景、密集人群这类场景,直接上第 2 节的 DNN 检测。判断标准很简单:能不能在采集端控制住光照与背景——控制得住,传统方法仍是性价比之选;控制不住,就别再为难它。
传统方法的天花板在特征的表达力。下一节进入 DNN 模块:加载预训练的 YOLO,几行代码获得开放场景下的多类别检测能力。